
Token 折扣仍綁在等待時間上
你想讓 agent 整夜跑一件工作,打開 Sail Research 的價格頁,Kimi K3 每百萬輸出 token 列了三個價錢:12.50、10.00、6.25 美元(2026 年 10 月 23 日查詢)。模型一樣,差別只在你願意等多久。這個價差能不能一路拉大到 1000 倍?Sail 的共同創辦人 Neil Movva(前 NVIDIA 工程師)在 2026 年 8 月 25 日發布的訪談裡說,他的工作就是把 token 做到 "as cheap as humanly possible"(便宜到人類做得到的極限)。
快速回答 牌價上看得到的降幅目前來自願意等:Sail Research 價格頁(2026-10-23)的 Kimi K3,flex 輸出每百萬 token 6.25 美元,是 asap(即時)12.50 美元的一半。Neil Movva 的目標是把成本降到至少千分之一;牌價上同模型價差約 2 倍,輸入端最大約 6.7 倍。要拿折扣,工作得能放到背景,並自己處理重試與逾時。
推論模式和牌價放在一張表
下表整理自 2026 年 10 月 23 日的公開頁面;美元是 Kimi K3 每百萬輸出 token 價格,百分比是折扣,不能直接相比。
- 低延遲;沒容量回 503,不排隊
- 12.50 美元
- Sail 價格頁、Completion windows 頁
- 排隊等容量;可同步或背景
- 10.00 美元
- 同上
- 最寬排程;忙時可能久等
- 6.25 美元
- 同上
- OpenRouter 未列延遲數字
- 15.00 美元(mxfp4)
- OpenRouter 端點列表
- OpenRouter 未列延遲數字
- 8.25 美元(Decart,mxfp4);9.50 美元(Chutes,mxfp4)
- 同上
- 批次;時限頁面未列
- 11.40 美元(DeepInfra)
- OpenRouter 端點列表
- 目標 1–15 分鐘;可被搶占
- 標準價的 50%
- Google Gemini API 文件
- 最久 24 小時;非同步
- 標準價的 50%
- 同上
- 較慢;偶爾無資源(429)
- Batch 費率;429 不收費
- OpenAI 開發者文件
Sail 自己對這三個窗口的說法是:asap 比傳統推論供應商便宜 30–70%,balanced 便宜 45–80%,flex 便宜 55–85%。這是 Sail 的自我比較,頁面沒有交代比較對象與算法,下面只用它的牌價本身。OpenRouter 上 Decart 的 8.25 美元與 Chutes 的 9.50 美元,都低於 Sail asap 的 12.50 美元;精度與延遲不同,只能當參考。
用一個「整夜掃程式庫」的工作,檢查六個重點
這個例子取自 Fortune 2026 年 6 月 25 日的報導:Sail 的客戶 Detail.dev 用它跑程式碼審查 agent,每次花三到四小時掃程式庫找 bug。下面一站對一個重點,先放 Movva 或其他一手來源怎麼說。Movva 的引言取自 YouTube 影片的自動字幕(影片 1 小時 23 分,上傳日 2026-08-25,Colossus 節目頁同日發布),時間碼是影片的大約位置;訪談錄製日期未公開。
第一站:誰在等這個答案?
Movva 的第一個重點是,agent 的下一階段是背景工作,沒有人在等。他說 Baseten、Fireworks、Together 這類推論供應商,過去被 Cursor 這位重要客戶拉向低延遲;他認為那在一年前是對的選擇,大約半年前起,長時間工作變得更重要。他在約 4:14 說,agent 一次跑幾小時甚至幾天,每秒吐 100 個 token 或 10 個,差別不大。
他用一句話收這個想法(約 4:35):"the best latency is no latency at all."(最好的延遲是沒有延遲。)人在迴圈裡等 agent 回覆,他說(約 4:47)"you're the bottleneck"(你就是瓶頸)。他對比例的預測在約 6:26:今年底背景與即時的工作量大約五五開,之後他看到的是 90/10,偏向背景。
工程上的意思: Sail 在請求上標 completion_window(asap、balanced、flex)。flex 只能用 Responses API 並設 background=True,或走 Batch API,其他端點回 HTTP 400;客戶端要改成先送出、再輪詢結果。
掃程式庫沒有人等,屬於背景那一半。假設用量 5,000 萬輸入、500 萬輸出 token(本站假設,不計快取),Kimi K3:asap 約 187.5 美元,balanced 150 美元,flex 93.75 美元。
本站建議: 先把工作分成「有人在等」與「沒人在等」兩批,再比價;帳單減半是用等待時間換來的,兩種等待方式要分開看。這個分法也決定哪些請求能改走背景窗口,哪些只能留在 asap。
第二站:等待為什麼能換折扣?
Movva 的第二個重點是,延遲與吞吐量在 GPU 上互相拉扯,而過去整個產業為了聊天機器人選了延遲。他在約 19:00 預測,明年最大的改變是從聊天機器人轉向主動或背景 agent,在那樣的世界裡,圍繞吞吐量建堆疊更合理。他在約 19:30 說,窄而快對寬而慢,是整個電腦科學的經典取捨;放到 GPU 上,GPU 的效率來自把許多使用者的工作併成一個批次(batch)一起算,批次越大,單一請求在 GPU 上待的時間越長。
他用公車比喻(約 20:15):想到舊金山市中心,你可以搭公車,或叫一台專車。專車走你要的路線;公車要服務很多人,路上會停下來等人上下車。
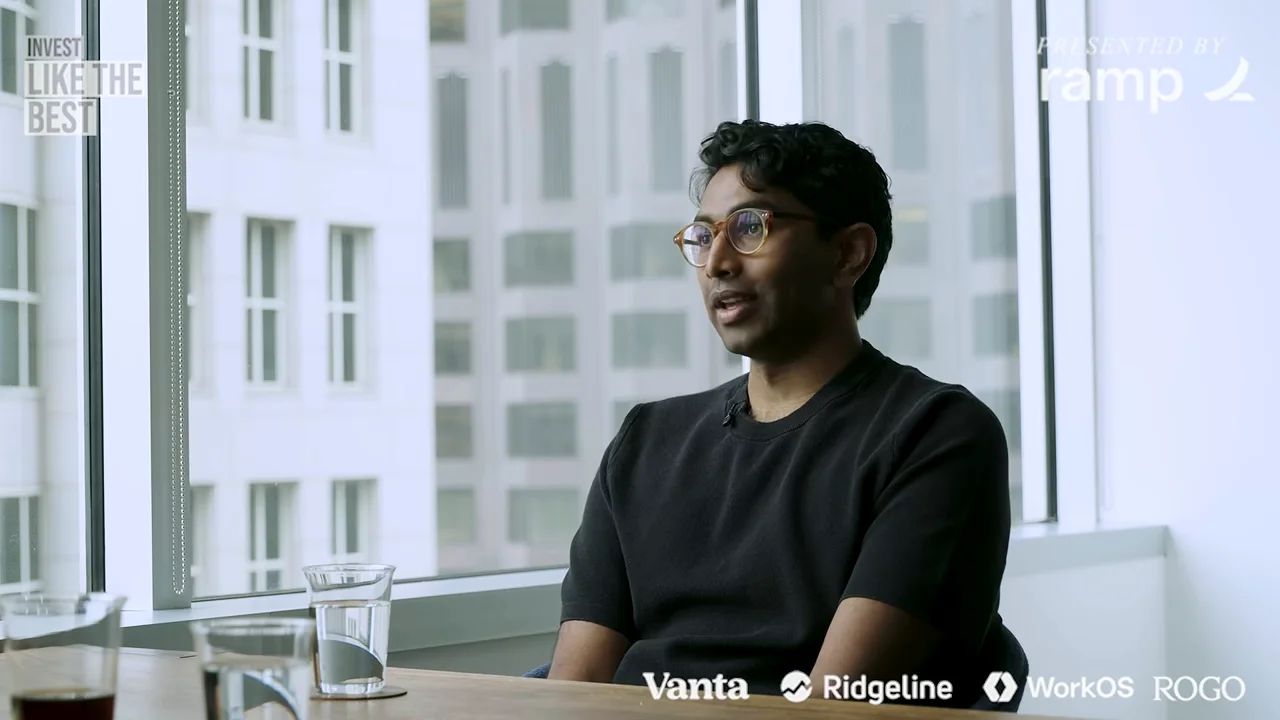 Movva 談批次與延遲的取捨,約 20:15;《Invest Like the Best》第 488 集〈From Transistor to Token〉,Colossus/YouTube,影片 20:15;畫面著作權屬原節目。
他接著講了一個加速也有上限的例子(約 21:30):把一個大矩陣乘法切開,分給最多八張 NVIDIA GPU 並行,可以縮短單次運算的時間,但不會快到八倍,是亞線性(sublinear)的加速。Sail 部落格 2026 年 8 月 27 日的〈HTDYM (How To Deploy Your Model)〉由署名作者 Ben Mayer 寫,補了成本這一面:即使模型、工作負載、晶片都固定,光是切法不同,每塊錢能買到的 token 數就能差 3 倍以上。
Sail 的 Completion windows 頁寫明:asap 不能跑背景請求,也不支援 Batch;flex 只能跑背景請求與 Batch。換窗口時,呼叫方式也要一起換。
第三站:機器掉了,誰負責?
Movva 的第三個重點是,背景工作容得下不穩定的機器,所以可以買別人不要的算力。他在約 56:20 說,Sail 的做法是願意買任何地方、任何時長的晶片,並把容量搬進自己的機隊。他還說(約 57:17),自己不會意外有些資料中心的上線率掉到 95%;這在別人眼裡是致命的,他說自己是第一個買家。
代價他也講明了(約 58:41):"our P99, our 99th percentile latency, it's not going to be controlled."(我們的 P99 延遲沒辦法控制。)P99 指 99% 的請求能在這個時間內完成,數字越大,慢的那批請求要等越久。他的交換條件是 "in return, I'll give you unbeatable economics."(換來划算的價格。)他估計請求失敗時,agent 那一輪大概多等幾分鐘,甚至十分鐘,因為系統要重新找一張 GPU。
這個取捨在別家的便宜窗口上也看得到。Google 的 Gemini Flex 文件(頁面標示 2026-10-13 更新)寫它是「可被搶占」的:標準流量暴增時,請求可能被擠掉,回 503(容量滿)或 429(資源耗盡)。Flex 仍是同步呼叫。Batch 是非同步。系統不會自動改走標準層,客戶端要自己重試,並讓每次重試前的等待時間按倍數增加(指數退避);文件也建議把客戶端逾時設到 10 分鐘以上。OpenAI 的 Flex 說明寫著「較慢、偶爾沒有資源」,Flex 以 Batch 費率計價,遇到 429 不收費,可以用指數退避重試,或改走標準處理;SDK 預設逾時 10 分鐘。Sail 的 asap 則是等一下容量,沒有就回 503,不排隊;flex 在忙時「可能等很久」。Fortune 報導,Sail 為了吞吐量放棄即時性,撐不起語音助理或即時聊天機器人。
工程上的意思: 便宜的窗口把可靠性丟回客戶端:重試要有退避,逾時要放寬,重送要能辨識是否已跑過。Sail 的 Retrying requests 頁說,沒有 response ID 或 idempotency key 就重試,可能重複開工並再收費。
被搶走一張 GPU,多等的幾分鐘落在三到四小時裡,沒有人會發現;放進使用者按鈕後要等的流程,就是逾時。我的判斷: 比價時要把重試成本算進去:重送若會再收一次費用,50% 的折扣一次重試就抵銷了。
第四站:便宜的晶片是怎麼算出來的?
Movva 的第四個重點是,便宜來自每一層都去找價差。他在訪談開頭(約 0:03)說,他會用上整個堆疊每一層能動的槓桿:每一種晶片、每一種電源、美國各地合適的土地。
晶片這一層,他在約 23:58 說,有些新創押注另一種加速器,記憶體階層不同:盡量放大晶片上的 SRAM,拿來存模型權重與 KV cache。他在約 24:25 解釋,SRAM 很吃晶粒面積:像 NVIDIA Blackwell 這種約 800 平方毫米的大晶粒,全做成 SRAM 大約只有個位數 GB。他在約 26:47 以 Cerebras 為例:SRAM 離運算單元近,頻寬是每秒 21 PB(他說的數字),NVIDIA Blackwell 的 HBM 約每秒 10 TB 上下,他說兩者差好幾個數量級,換來的是容量小得多。
Sail 部落格給了一個具體的例子,這是 Sail 自己的數字,沒有第三方驗證。
2026 年 8 月 27 日的〈HTDYM〉說,Sail 對 Gemma 4 31B 在 24 種晶片、3,455 種配置上估價,結果是用 Google 的 TPU v6e,輸入 token 的成本約降到三分之一(約 3 倍的降幅),解碼(輸出)token 的成本約增加 25%,比較對象是他們當時的 H200 配置。prefill 是模型先處理輸入內容的階段。文中說,Sail 這個模型的工作負載偏向輸入多(prefill-heavy),所以輸入變便宜、輸出變貴的交換划算;實測 prefill 效能達到事前預估的 87.5%。2026 年 9 月 9 日的〈Chasing Speed of Light on TPU v6e〉另說,優化底層運算程式(kernel)後,prefill 階段的浮點運算利用率(MFU,實際運算量占理論峰值的比例)從約 32% 升到約 63%,表示晶片的理論算力用得更充分。
同一個價格頁(2026-10-23)上,Gemma 4 31B 輸入價從 asap 的 0.40 美元降到 flex 的 0.06 美元(約 6.7 倍),輸出價從 0.60 降到 0.30 美元(2 倍)。
Fortune 報導轉述 Movva 的說法:客戶相較相近的替代方案,常見 3 到 10 倍的成本改善;報導沒有說明怎麼量。
第五站:一兆 token 要多少錢?
Movva 的第五個重點是規模:他想創造讓一個人每天消耗一兆 token 的條件。主持人 Patrick O'Shaughnessy 請他說明一兆 token 有多大,Movva 在約 1:15:15 說,以 OpenAI 的牌價,至少要 500 萬美元。他接著說(約 1:15:31),要讓這件事成立,他們要的是 "three to six orders of magnitude improvement in cost per token"(每個 token 的成本改善三到六個數量級;他說他們要的是「至少」)。他說降到約 5,000 美元,大概就會有一些客戶(約 1:15:36)。
他也說,對某些大小的模型,Sail 已經接近把一兆 token 壓到數萬美元(約 1:15:47)。用 Sail 價格頁的 flex 價對照(2026-10-23,單價乘上一百萬,不計快取):
- 125 萬美元
- 625 萬美元
- 1.25/6.25
- 40 萬美元
- 180 萬美元
- 0.40/1.80
- 6 萬美元
- 30 萬美元
- 0.06/0.30
- 5 萬美元
- 15 萬美元
- 0.05/0.15
小模型的輸入端落在數萬美元;Kimi K3 的輸出端是 625 萬美元,與 Movva 說的 500 萬美元同一量級,但模型、輸入輸出比例與窗口都不同。
我的判斷: 牌價上看得到的折扣是 2 倍上下,最大 6.7 倍,離 1000 倍還差兩個多數量級。模型變小、肯等的窗口、輸入多輸出少的工作,都有助於壓低帳單;但目前列出的數字,還看不出三樣疊起來就能到 1000 倍。1000 倍仍是 Movva 的目標。
2026 年 10 月 23 日,OpenRouter 的端點列表:GLM-5.3 輸出價,Sail 列 2.00 美元(fp8),Z.AI 直營 4.40 美元(fp8),Wafer 列 1.40 美元(fp4);Kimi K3 的 Sail 端點 5.50 美元(fp4),低於價格頁 flex 的 6.25 美元,兩邊均未說明原因。這些端點精度不同、未列延遲,不能當同條件比較,價格也會調整。
工程上的意思: 比價時固定四件事:模型版本、精度(量化)、窗口、輸入與輸出的比例。
第六站:token 之後,拿什麼計價?
Movva 的最後一個重點是,token 不會是最終的計價單位。他在約 2:05 說,他的北極星是業界最低的每 token 成本,而且要贏一大段;但他不認為 token 是工作或智慧的最終單位,只是現在用的單位。他在約 2:13 說,token 之後會往「結果」(outcomes)移動,方向還很模糊。他設想的是(約 2:31):agent 自己決定要做多少,"take as many shots on goal as they can"(盡可能多嘗試幾次),用掉多少 token 取決於任務;也就是 agent 自己管理 token 預算,而現在是公司規定每位工程師每月能花多少 token。
本站建議: 計價單位改變之前,先把預算設在任務層:掃程式庫這種工作,事先寫下單次任務的 token 上限與停止條件,單位改變時再依新費率重訂。
還沒有人回答的一題
目前還沒有人替你回答的,是你自己的夜間工作該付哪個價。你今天排進夜間、沒有人在等的工作,為什麼還在付即時的價錢?
常見問題
Flex 和 Batch 差在哪?
Google 文件寫 Flex 目標 1–15 分鐘、仍是同步;Batch 是非同步,最久 24 小時;兩者都是標準價的 50%。
要即時回應的應用,能用這些便宜窗口嗎?
多半不行。Sail 的 asap 是低延遲窗口,價格也最高;flex 在忙時可能久等。
一兆 token 要花多少錢?
看模型與輸入輸出比例。依 Sail 的 flex 價,小模型一兆輸入 token 是 5 萬到 6 萬美元,Kimi K3 的輸出是 625 萬美元。
Flex 請求失敗會收費嗎?
依 OpenAI 的 Flex 文件,遇到 429 時不收費。Sail 的 Retrying requests 頁未說明失敗請求本身是否計費。
延伸閱讀
- GPT-6 Astra 為什麼讓長時間任務變成焦點?
- Agent 要用的工具與基礎設施,2026 年有哪些?
- LLM 的 Token、Embedding 與 Context Window 是什麼?
- Loop Engineering 實戰:AI 寫得越快,人越審不動
參考資料
- Patrick O'Shaughnessy 與 Neil Movva, Ex-NVIDIA Engineer: Why AI Is About to Get 1000x Cheaper(Invest Like the Best,YouTube 影片與自動字幕,上傳日 2026-08-25;節目頁標題 From Transistor to Token,第 488 集) https://www.youtube.com/watch?v=uyzqxIoiobU
- Colossus, From Transistor to Token(Invest Like the Best 節目頁,2026-08-25;完整逐字稿需登入,本文引言取自影片自動字幕) https://colossus.com/?p=424800
- Ben Mayer, HTDYM (How To Deploy Your Model)(Sail Research 部落格,2026-08-27) https://www.sailresearch.com/blog/htdym
- Ben Mayer, Chasing Speed of Light on TPU v6e(Sail Research 部落格,2026-09-09) https://www.sailresearch.com/blog/tpu-v6e-gemma
- Sail Research, Pricing(價格頁,2026-10-23 查詢) https://docs.sailresearch.com/pricing
- Sail Research, Completion windows(文件,2026-10-23 查詢) https://docs.sailresearch.com/completion-windows
- Sail Research, Retrying requests(文件,2026-10-23 查詢) https://docs.sailresearch.com/retries
- OpenRouter, Models API 與各模型 endpoints(公開 API,2026-10-23 查詢) https://openrouter.ai/api/v1/models
- Google, Gemini API Flex inference(頁面標示 2026-10-13 更新) https://ai.google.dev/gemini-api/docs/flex-inference
- OpenAI, Flex processing(開發者文件,2026-10-23 查詢) https://developers.openai.com/api/docs/guides/flex-processing
- Fortune, Exclusive: A former Apple engineer thinks AI infrastructure is built for the wrong future. Investors just gave him $80 million to fix it(2026-06-25;報導 Sail 融資、客戶與 Movva 的說法) https://fortune.com/2026/06/25/exclusive-sail-apple-kleiner-perkins-gpu-token-nvdia-sequoia-80-million/
留言0
登入後就能留言。
登入