
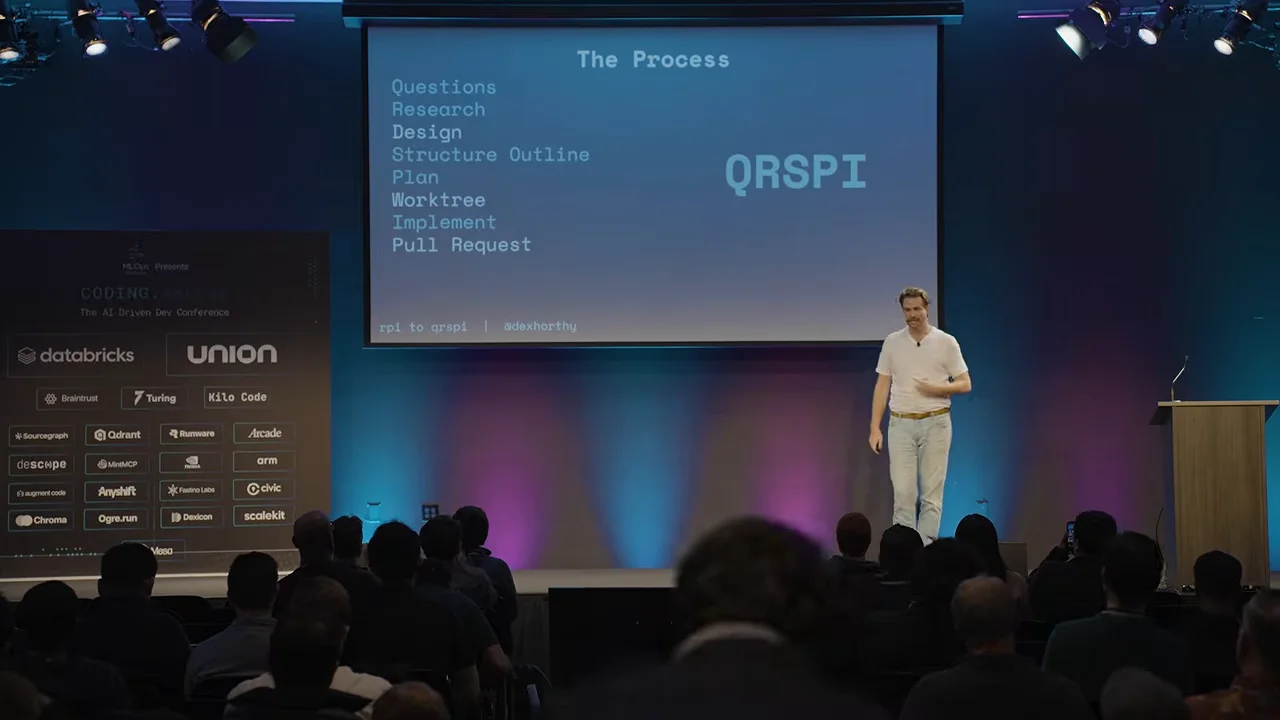
「I don't think it's okay to not read the code.」(我不認為可以不讀程式碼。)
這句話是 HumanLayer 創辦人 Dex Horthy 在 2026 年 3 月 3 日 Coding Agents Conference(Computer History Museum)的演講裡說的。他提到有人會反問:八月的時候,你不是說過不用讀 code 嗎?他的回答是:「I was wrong.」(我錯了。)
如果你的 PR 清單裡,同時躺著 AI 寫的 diff 和 AI 寫的 plan,這個轉彎跟你有關。他把自己推廣過的 Research-Plan-Implement(RPI,研究、計畫、實作三步流程)拆掉重做,現在叫 CRISPY。
快速回答 CRISPY 是 Dex Horthy 把 RPI(Research 研究、Plan 計畫、Implement 實作)拆成八個階段的流程,目標是 2 到 3 倍的生產力,而且每一行 code 仍然有人讀。拆開的原因是研究被需求污染、單一提示塞了 85 條以上的指令、plan 比 code 更難審。這是 HumanLayer 自己的做法與自述,沒有公開 prompt,也沒有第三方的成效數據。對已有 code review 的團隊,我建議設計與大綱由人確認、長 plan 只抽查、深度審查留給 code。
這篇照時間走一遍,六個重點會依序出現:研究要和需求隔離;指令數有預算;長 plan 只抽查,深度審查留給 code;設計與大綱是人必須在場的兩道關卡;先切垂直片段;以 2 到 3 倍為目標,不追 10 倍。
2025 年 7 月:AI 多寫的程式,扣掉返工還剩多少?
AI 多寫的程式,扣掉返工約剩一半。Stanford 的 Yegor Denisov-Blanch 在 2025 年 7 月 23 日的 AI Engineer World's Fair 上,拿 10 萬名以上工程師、600 多家公司的資料,報告 AI 讓產出增加約 30 到 40%,但扣掉修 bug 與返工之後,淨增加約 15 到 20%(AI Engineer 講者頁)。
Dex 在 2026 年 3 月的演講開頭,用這份研究當起點。他的口語版本是:你多出貨 50%,但其中一半在清上週的 slop(低品質的 AI 產出)。這是他的概數,他也特別說明這些是 Opus 4.5 之前的數字。
這張圖的重點是橘紅色那一塊:新程式碼之後,又有一部分是在改前面剛寫的程式,所以產出的總量變大,能交付的東西沒有等比例變多。
同一份研究還按任務拆開看。低複雜度的 greenfield(全新專案)增加約 35 到 40%,高複雜度的 greenfield 約 10 到 15%,低複雜度的 brownfield(既有程式碼)約 15 到 20%,高複雜度的 brownfield 約 0 到 10%(Dex 投影片 1:50 的矩陣)。Dex 的解讀是:AI 對全新、簡單的任務最有用,對複雜的既有系統幫助最小。
另一邊,METR 研究 2025 年初資深開源開發者使用 AI,結果任務多花 19% 的時間,信賴區間是 +2% 到 +39%(METR,2026-02-24 回顧)。兩份研究的對象與方法不同:Stanford 呈現的是扣掉返工後的淨產出,METR 發現的是任務多花 19% 時間。
2025 年 8 到 12 月:RPI 怎麼走到「不用讀 code」,又走回來?
Dex 在 2025 年 8 月主張可以不讀 code,11 月改成要讀很長的 plan,2026 年 3 月兩者都認錯。RPI 的三步是 Research(把程式碼現況壓成一份事實文件)、Plan(寫出實作計畫)、Implement(照計畫實作)。2025 年 12 月 2 日上線的〈No Vibes Allowed〉演講,Dex 說:「We don't not read the code. All code gets reviewed.」(我們沒有不讀 code,所有 code 都會被審。)同一場他也說,不讀 plan 的話流程不會成功。
到了 2026 年 3 月,他把這段回頭列成兩個錯誤:八月主張可以不讀 code,十一月主張要讀很長的 plan。他說他們試過大約六個月不讀 code,結果得把系統的大塊部分拆掉重寫。
同一段時間,另一條線在累積證據。HumanLayer 共同創辦人 Kyle(原文署名只有名字,未列姓氏)在 2025 年 11 月 25 日的〈Writing a good CLAUDE.md〉寫道,前沿模型大約能穩定遵循 150 到 200 條指令;Claude Code 自己的 system prompt(每次對話前由工具預先塞給模型的系統指令)已經用掉約 50 條;他們自己的根目錄 CLAUDE.md 不到 60 行。
這裡有一個要分清楚的地方。投影片附的論文是 2025 年 7 月 15 日的〈How Many Instructions Can LLMs Follow at Once?〉(IFScale),它測的是 20 個模型在最多 500 條指令下的表現,最好的模型在最高密度時準確率是 68%。論文本身沒有「150 到 200 條」這個數字,那是 Kyle 的詮釋。
工程上的意思:這個預算是共用的。system prompt、CLAUDE.md(放在專案根目錄、給 agent 讀的規則檔)、MCP(讓 agent 呼叫外部工具的協定)工具說明和你的流程提示,全部在同一個額度裡搶。
2026 年 2 月:連 METR 都說量不準了?
對,METR 自己在 2026 年 2 月就說量不準。2026 年 2 月 24 日,METR 公布新一輪實驗:57 位開發者、143 個程式庫、800 多個任務。原班開發者的估計值是 -18%(信賴區間 -38% 到 +9%),新招募的是 -4%(信賴區間 -15% 到 +9%)。METR 稱這些為 speedup,但沒有另外給定義;它把早期結果 +19% 描述成任務多花 19% 時間,依此上下文,負值應讀成耗時減少(此處依上下文解讀,METR 原文沒有另外定義這些數值)。兩個區間都跨過 0,所以不能排除沒變快、甚至變慢。
METR 的結論是,這批資料給的是「unreliable signal」(不可靠的訊號)。原因是有些開發者不願意在沒有 AI 的條件下工作,因此拒絕參加,造成選擇偏誤。METR 原文寫 "it is likely that developers are more sped up from AI tools now"(現在的開發者很可能被 AI 工具加速得更多),但這批資料只是「very weak evidence」(很弱的證據)。
這給後面的討論定了一個基調:量測本身就很難,Dex 後面要求用「defensible metric」(站得住腳的指標)檢驗成效。
2026 年 3 月 3 日:Dex 認了哪三個錯,又拆成哪八步?
三個錯是:不讀 code、讀很長的 plan、讓 AI 在正式環境產出 slop;改法是把流程拆成八步(Questions、Research、Design、Structure Outline、Plan、Worktree、Implement、Pull Request)。他說自 2025 年 10 月以來,HumanLayer 跟上千位工程師合作,從小新創到 Fortune 500。一個常見的模式是:把工具交給高手,成果很好;高手再交給團隊,成果就不一定了。
他挖出三個原因,每一個都對應一個改法。
一、研究被需求污染(重點一)。 很多人下指令是「我要做這個功能,去研究程式碼」。Dex 的說法是,好的研究全是事實,但你一旦告訴模型你要建什麼,它就會開始有意見。改法是用兩個 context:第一個把 ticket(需求單)變成一串問題,第二個是全新的 context(模型這一輪能看到的全部內容),只拿到問題,不知道要做什麼,據此寫研究文件。2026 年 4 月他補充,這件事用程式「programmatically」做,負責研究的 agent 看不到 ticket。
二、指令超過預算(重點二)。 原本的 create-plan 是單一提示,有 85 條以上的指令,包含先提出設計選項、先對齊結構、才寫 plan 等步驟。Dex 說大約 50% 或更多的使用者,若沒說出特定的「magic words」,模型就會跳過提問,直接寫 plan。他的結論:「If you built a tool that requires hours and hours of training … go fix the tool.」(如果工具需要大量訓練才能用好,就去修工具。)修法是把它拆成多個提示,投影片顯示從 85 條以上降到 38 條,他口述是每一個都低於 40 條。他給了一條通則:能用程式的流程控制,就不要用提示做流程控制。
三、plan 比 code 更難審(重點三)。 1000 行的 plan 大約對應 1000 行 code,誤差約 10%,而且 plan 裡常有實作時才出現的意外。你花一小時審 plan,實作完仍然得重讀 code。Dex 的新建議是:「don't read the plans, please read the code.」(別讀 plan,請讀 code。)他也回應了「別人不讀 code」的例子:那些是開源專案,沒人會半夜被叫醒,也沒有數百萬美元的罰款。
拆開之後,流程如下。這張總覽表是本站依 Dex 兩場演講(2026 年 3 月 3 日與 4 月 20 日)整理的,RPI 欄是 2025 年 11 月的做法,CRISPY 欄是 2026 年 3 月與 4 月的說明。
- 一個「研究程式碼」提示,需求常被一起帶進去
- ticket 先變成問題;研究在新 context 進行,看不到 ticket
- 研究文件只放事實(Dex)
- 包在 Plan 的 85 條指令裡,常被跳過
- 約 200 行 markdown:現況、目標狀態、要遵循的 pattern、已決定的事、未決問題
- 人必須在場
- 同上
- 約 2 頁,Dex 比喻成 C 語言的 header file:階段、順序、怎麼驗證
- 人必須在場
- 單一提示,產出的 plan 如 Dex 舉例約 1000 行,要求人讀
- 約 8 頁,逐行改動,給 agent 用
- Dex:別讀 plan,請讀 code(本站建議:plan 抽查)
- Implement 照 plan 做
- 演講只列名稱,沒有展開
- 未說明(Dex:測試與驗證「I don't have a good answer」)
「人必須在場」這一欄,有 HumanLayer 的產品文件佐證:design 和 outline 的交接一定等你確認,部分交接可以自動開始。
名字的由來很隨性。Dex 說這八個字母湊不成好唸的縮寫,所以他們「just picked the ones we liked」(挑了喜歡的字母),叫 crispy。他也說得很誠實:以前三步已經有人學不會,現在是七步(投影片列八項),平台團隊怎麼調整共用提示又不破壞各團隊的流程,目前還沒有答案。
2026 年 4 月 20 日:為什麼設計與大綱一定要人在場?
因為架構判斷沒辦法用強化學習訓練給模型,而模型又偏好水平切;Dex 在 2026 年 4 月 20 日的邁阿密 AI Engineer 演講補了這兩個理由。
設計與大綱:人必須在場(重點四)。 Design 階段,Dex 說人要在場,因為「you can't RL a model on architecture」(你沒辦法用強化學習訓練模型的架構判斷),壞架構的後果會拖上數月到數年,五分鐘的單元測試看不出來。設計文件的作用,是在 agent 動手前,把它對程式碼的理解攤出來,Dex 稱為「brain surgery on the agent」(在 agent 身上動腦手術)。
Structure Outline 的理由,是模型很愛水平切:先做完整個資料庫,再做服務層、API,最後才做前端,寫到 1200 行才第一次能整體檢查(這張水平切的投影片 3 月演講時已提到)。
先切垂直片段(重點五)。 Dex 的做法是要求垂直切:像工程師自己寫那樣,每一片都從前端貫穿到資料庫一小塊功能,先用 mock(假資料或假服務)接通,再逐層換成真的,每片做完就能跑一次檢查。
工程上的意思:outline 讓你在第一行 code 寫出來以前調整階段順序。要驗收的是每一個階段結束後,有沒有一個能跑的檢查。
以 2 到 3 倍為目標(重點六)。 另一個常被忽略的論點是團隊對齊,下面的時間分配圖在 3 月演講時已提到。Dex 說一個本來要兩天的功能,coding 部分大約 2 到 4 小時,用 AI 之後 coding 降到 20 分鐘,整個功能仍然要兩天,因為對齊、審查、跨 repo 協調與驗證都沒省。用 AI 來做規劃與對齊,才縮短審查與返工,所以他把目標定在 2 到 3 倍;他的理由是「10x 但六個月後全丟」沒有意義。
在邁阿密,他還說明了兩件事。一是 HumanLayer 沒有公開 CRISPY 的 prompt,他說把開源的三個 prompt 拆成大約八個,是「an exercise for the reader」(留給讀者的練習)。二是他對「燈全關」的軟體工廠(沒有人讀 code)的預測:三個月沒人讀 code,出現 agent 解不了的 bug,接著是三週的停機。他明講這是推測,沒有數據。
2026 年 5 到 6 月:更新的資料站在哪一邊?
大部分站在「量不準,而且指標容易被玩壞」這一邊。這三筆都是 5 月以後的資料。
2026 年 5 月 11 日,METR 發表自我回報調查:349 位技術工作者的中位數是價值提升 1.4 到 2 倍,速度提升 3 倍。METR 同時警告,回覆率約 2%,樣本很可能有嚴重的選擇偏誤,並引用自己早期的發現:開發者高估 AI 對任務時間影響平均達 40 個百分點。
DORA 在 2026 年 6 月 2 日發表〈Finding balance in the era of tokenmaxxing〉,作者 Evan Conaway 談的是把 token 用量排行榜當績效的做法,他認為 token 數是虛榮指標,容易被灌水,一旦變成目標就不再衡量真正的工作(Goodhart 定律)。他建議看既有的 DORA 指標,加上效率與風險指標。在這之前,DORA 2025 年報告的結論是 AI 的主要角色是放大器:「magnifying an organization's existing strengths and weaknesses」(放大組織原有的強項與弱點)。2026 年 4 月 22 日,DORA 的 Quick Check 加入了 deployment rework rate(部署返工率)。DORA 沒有在該頁給出定義。
Dex 本人也沒有改口。Web Directions 對 2026 年 6 月 30 日 AI Engineer World's Fair 的現場報導(John Allsopp 撰寫,二手轉述)引了他的話:「for now we're stuck reading the code, but we can still move pretty fast.」(目前我們只能繼續讀 code,但仍然可以相當快。)
把各方放在一起:誰在賣什麼,還有哪些別的解釋?
本站的歸納是瓶頸搬家了:產出變快,驗證與對齊仍可能拖住交付。Stanford 的返工與 Dex 的兩天功能支持這點;DORA 的放大器說法只是旁證,它談的是組織原有的強弱。
衝突在兩處。Dex 反對不讀 code 的路線,他在 Q&A 說「I do not endorse that」(我不背書);但他點名的開源專案(Beads、OpenClaw)正是在做相反的事。METR 自己的兩份資料,一份是區間跨過 0 的實驗,一份是 3 倍的自我回報,數字看似打架,但方法和樣本都不同,不能直接比。
幾個替代解釋值得放在桌上:
- 模型變強,可能讓早期研究(Stanford 與 METR 2025 年的數字)的參考價值下降。Dex 說投影片是 Opus 4.5 之前的數字,METR 也認為 2026 年初的提升「likely」更大。
- 說這些話的人有立場。HumanLayer 賣的是協作用的 IDE,Dex 在邁阿密講完後直接徵求設計夥伴與工程師。
- 返工也許是組織的問題。DORA 的放大器說法暗示,同樣的工具在流程弱的團隊會放大混亂,換 prompt 並不會改變這件事。
對台灣團隊,我的判斷是:這些做法裡不依賴 HumanLayer 的部分最便宜,也最值得先試,也就是研究與需求分開、把巨型提示拆小。這個判斷的前提是你的 review 流程已經存在;如果團隊本來就沒有人審 code,先補這件事比換流程重要。
審查資源的配置,我會這樣排:設計與大綱是兩道一定要有人在場的關卡,因為這裡改一行字,比實作後改一千行便宜得多;長 plan 只抽查,不逐行審,因為 Dex 自己的數字是 1000 行 plan 約等於 1000 行 code,審完 plan 還得再讀一次 code;深度審查留給 code。代價是你得接受 plan 裡的實作意外會晚一點才被發現,而且團隊要有人真的有時間讀 code。證據上,這套配置目前只有 Dex 的自述與間接數據支持,沒有對照實驗,所以先在一條功能線上試,量過再推廣。
你的團隊,每週花多少小時讀 AI 寫的 code,有人量過嗎?
如果 Dex 是對的,每一行都要有人讀,讀 code 的工時就是 CRISPY 必須計入的成本。
常見問題
CRISPY 跟 QRSPI 是同一個東西嗎?
是同一個流程的兩個名字。CRISPY 是 Dex Horthy 把 RPI(Research-Plan-Implement)重做後的流程。Dex 在 2026 年 3 月的投影片標題寫 QRSPI(Questions、Research、Design、Structure Outline、Plan、Worktree、Implement、Pull Request)。他說這串字母不好唸,所以挑了幾個喜歡的字母,叫它 crispy。
HumanLayer 有公開 CRISPY 的 prompt 嗎?
沒有。CRISPY 是 Dex Horthy 的八階段 AI 寫程式流程,他在 2026 年 4 月的邁阿密演講說,他們不公開 CRISPY 的 prompt,並建議讀者拿開源的三個 RPI prompt,自己拆成大約八個。
AI 寫的 code 一定要逐行讀嗎?
Dex 的立場是要,前提是有人依賴你的 code、壞了會有人半夜被叫醒的正式產品。他認為他點名的 Beads 與 OpenClaw 等開源專案條件不同,沒有人會半夜被叫醒,也沒有數百萬美元的罰款。這是他的立場,目前沒有看到對照實驗。
指令預算大約是幾條?
HumanLayer 共同創辦人 Kyle 的說法是前沿模型大約穩定遵循 150 到 200 條,這是他的詮釋;IFScale 論文測得的是,最好的模型在 500 條指令時準確率 68%。你要把 system prompt、CLAUDE.md 和工具說明一起算進去。
延伸閱讀
- Plan、Build、Verify、Ship 是什麼?AI 寫程式變快後,進度要怎麼算?(2026 完整懶人包)
- 為什麼 AI 越聊越笨、一直犯同樣的錯?Anthropic 揭密 Context Engineering 實戰(2026 懶人包)
- AGENTS.md 怎麼寫?規則寫越多,Agent 反而越貴?(2026 完整教學+範例)
參考資料
- Dexter Horthy, Everything We Got Wrong About Research-Plan-Implement(Coding Agents Conference,Computer History Museum,2026-03-03;影片 2026-03-24 由 AAIF Live 上傳) https://www.youtube.com/watch?v=YwZR6tc7qYg
- Dexter Horthy, AI Engineer Miami 2026 演講(2026-04-20,約 32:30 起) https://www.youtube.com/watch?v=6IxSbMhT7v4
- Dexter Horthy, No Vibes Allowed: Solving Hard Problems in Complex Codebases(2025-12-02) https://www.youtube.com/watch?v=rmvDxxNubIg
- Kyle(HumanLayer), Writing a good CLAUDE.md(2025-11-25) https://www.humanlayer.dev/blog/writing-a-good-claude-md
- Yegor Denisov-Blanch(Stanford), AI Developer Productivity(AI Engineer World's Fair,2025-07-23) https://www.ai.engineer/talks/tbDDYKRFjhk-ai-developer-productivity
- Daniel Jaroslawicz 等, How Many Instructions Can LLMs Follow at Once?(arXiv 2507.11538,2025-07-15) https://arxiv.org/abs/2507.11538
- METR, Uplift update(2026-02-24) https://metr.org/blog/2026-02-24-uplift-update/
- METR, AI usage survey(2026-05-11) https://metr.org/blog/2026-05-11-ai-usage-survey/
- DORA, 2025 State of AI-assisted Software Development https://dora.dev/research/2025/dora-report/
- Evan Conaway(DORA), Finding balance in the era of tokenmaxxing(2026-06-02) https://dora.dev/insights/finding-balance-in-the-era-of-tokenmaxxing/
- DORA, Quick Check updates(2026-04-22) https://dora.dev/insights/quickcheck-updates/
- HumanLayer, Skills and workflows(產品文件) https://docs.humanlayer.com/guide/skills-workflows
- John Allsopp(Web Directions), AI Engineer World's Fair 2026 field report(二手報導,Dex 2026-06-30 演講) https://fieldreports.webdirections.org/ai-engineer-worlds-fair-2026/
留言0
登入後就能留言。
登入