
Anthropic 為 Managed Agents 加入檔案式記憶庫,六種 Agent 記憶做法一次比較
你對 Claude Code 說「測試一律用 pnpm」,它若把這項偏好寫進記憶,下次對話(session)就讀得到。這句話在 MEMORY.md 裡只占一行,而這份索引每次開場只載入前 200 行或 25KB,超過的部分不會進 context,也就是模型這次能讀到的內容(Claude Code 官方文件,2026-10-23 查閱)。ChatGPT 這邊,在個人部落格發表 ChatGPT 記憶逆向分析的開發者 Manthan Gupta,在 2025 年 12 月的逆向分析裡,數出自己的帳號存了 33 條事實和約 15 則對話摘要。Claude Code 的 200 行是上限,Gupta 的 33 條是單一帳號的樣本,兩者不同類,但數字都不大。
快速回答 記憶量小、載入後仍留得下任務內容時,檔案或筆記通常就夠用,先決定何時讀入、誰寫入。Managed Agents 記憶庫用檔案目錄;ChatGPT 逆向分析與 OpenAI Cookbook 範例沒有用向量;Mastra 的向量檢索要另外打開;Claude Code、Honcho 與 Managed Agents 的文件未說明向量。
記憶在什麼時候進到 context?
ChatGPT 逆向分析與 OpenAI Cookbook 範例在開場就把記憶注入 context;Claude Code 開場只載入索引。
最早的 ChatGPT 記憶就是這種做法。Django 共同作者 Simon Willison 在 2024 年 2 月 14 日貼出他讓 ChatGPT 吐出的系統提示:一個叫 bio 的工具,「The information will appear in the model set context below in future conversations.」意思是:這些資訊會出現在之後每次對話的 context 裡,在系統提示的 model set context 區段。寫入走工具,讀取靠每次對話開頭的 context。
2025 年 12 月,Manthan Gupta 用對話逆向分析 ChatGPT(他自己註明不是 OpenAI 文件),整理出每次送進模型的幾層:只在 session 開頭放一次的環境資訊、長期的使用者記憶(他的帳號有 33 條事實)、最近對話的摘要(約 15 則,只摘要使用者說的話),以及目前對話的原文,後者按 token 數截斷(token 是模型計算文字長度的單位)。他的結論是:「No vector databases. No RAG over conversation history.」也就是不用向量資料庫,也不對歷史對話做檢索增強生成(RAG,先檢索相關內容再交給模型)。
Claude Code 的官方文件區分兩種內容:你寫的 CLAUDE.md,以及 Claude 自己寫下的記憶(auto memory)。每個 session 開場載入 CLAUDE.md 和記憶索引 MEMORY.md;各主題的細節檔(topic 檔)開場不載入,Claude 需要時用一般檔案工具去讀。這些文字只供模型參考;要強制擋住某個動作,得另外設定 hook(在特定事件自動執行的規則)。
工程上的意思:注入有預算。MEMORY.md 超過限額時,文件說寫入仍會成功,但 Claude Code 會回傳錯誤,要 Claude 重寫索引,因為超出的部分下次不載入。
記憶存成什麼形式?
六個做法存的都是文字,差別在結構與誰來寫。
- 開場注入
- 事實清單+對話摘要
- 模型判斷或使用者要求
- 無
- 系統提示說明掛載位置,Agent 用檔案工具讀寫
- 文字檔目錄
- Agent 寫,API 或 Console 可改
- 文件未提
- 索引開場載入,細節按需讀
- markdown 檔
- Claude 自己寫,使用者可改
- 文件未提
- 觀察紀錄取代 context 裡的舊訊息
- 帶日期與重要度標記的文字
- 背景的 Observer、Reflector
- 預設無,可選
- 開場注入
- 狀態物件裡的筆記
- 對話中寫暫存,結束時合併
- 無
- 回應前查詢
- 推理出的結論
- 背景推理模型
- 文件未提
表 1:六個做法的總覽。
Claude Code 的 auto memory 放在 ~/.claude/projects/<project>/memory/,是普通 markdown,每個檔案開頭的 frontmatter(檔案的中繼資料區塊)有 type,分成 user(使用者)、feedback(回饋)、project(專案)、reference(參考)四種。文件說 Claude 會跳過它能從程式碼推得出的東西,也跳過 CLAUDE.md 已經寫過的。檔案只存在這台機器上,不跨機器共享。
OpenAI Cookbook 的個人化範例走另一條路:記憶是一個狀態物件。global_memory 的每則筆記帶 text、last_update_date 和 keywords,另有 session_memory 放這次對話的暫存。範例的記憶政策寫得很具體:「The user's latest message in this conversation overrides everything.」也就是使用者在這次對話的最新訊息,優先於所有已存筆記。整份狀態只是 Python 物件裡的字典和清單,沒有資料庫。
Mastra 的 Observational Memory 在 2026 年 2 月 9 日由工程師 Tyler Barnes 發表,產物是一份格式化文字。他寫它「is text-based (no vector/graph DB needed)」,意思是以文字為基礎,不需要向量或圖資料庫。
要用只需一行設定 observationalMemory: true。
Plastic Labs 的立場和前面幾個不同。2025 年 8 月 19 日的〈Memory as Reasoning〉逐一評了三種資料庫。關聯式資料庫是「Reliable, familiar, optimizable.」,可靠、熟悉、好最佳化;向量資料庫能依語意搜尋,但是「Fuzzy, but still useful.」,結果模糊,仍然有用;圖資料庫用節點與邊組織資料,文中說它難以擴充。接著他們說:「All are useful tools but they assume you already know what’s worth storing and how to structure it.」意思是這些工具都有用,但都預設你已經知道哪些內容值得存、該怎麼組織。
他們的 Honcho 存的是從訊息推理出的結論。Honcho 文件把 peer 定義為「Any entity that persists but changes over time」,也就是會持續存在、但隨時間改變的對象,使用者和 Agent 都算。訊息先「stored and processed in the background」,也就是儲存起來並在背景處理,再由自家推理模型針對每個 peer 得出結論;開發者或 Agent 之後可以查詢這些結論,當作下一次回應的參考。
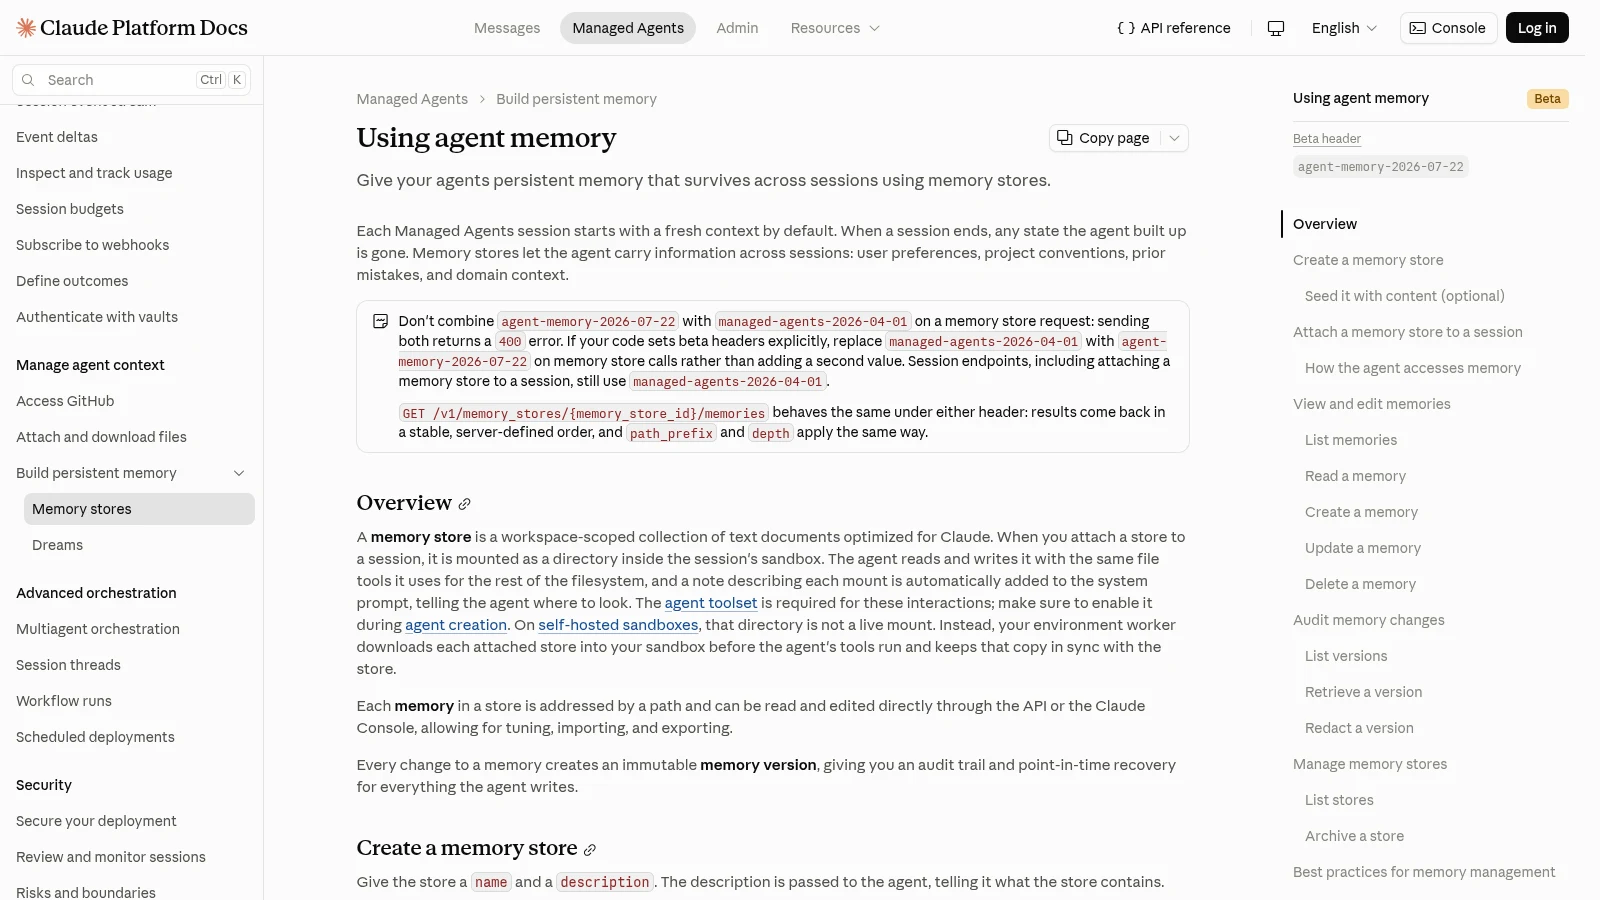
最新的資料點,來自 Anthropic 為 Managed Agents 加入的記憶庫(文件標示 beta header agent-memory-2026-07-22,2026-10-23 查閱)。文件原本的說法是,每個 Managed Agents session 預設從全新的 context 開始,session 結束,Agent 累積的狀態就消失;記憶庫(memory store)是工作區範圍內、為 Claude 最佳化的文字文件集合。掛到 session 時,它會是沙箱裡的一個目錄。系統提示會自動加一段說明,告訴 Agent 記憶掛在哪裡。Agent 再用一般檔案工具讀寫。每則記憶也能透過 API 或 Claude Console 直接讀取與編輯。單則記憶上限 100 kB,一個記憶庫最多 10,000 則;每次修改留下不可變的版本,保留 30 天。文件的建議是拆成許多小而專注的檔案。工程上的意思:形式選了檔案,Agent 就能用一般檔案工具讀寫;版本與人工修改則靠記憶庫自己提供的功能。
誰負責更新記憶?
更新有兩種安排:模型在對話中當場寫入,或交給背景程序整理;背景程序也能在對話進行時執行。
OpenAI Cookbook 兩個都用。對話中,模型呼叫 save_memory_note 把候選筆記寫進 session_memory;對話結束,consolidate_memory 把暫存筆記合併進全域記憶,去重、處理衝突。文件把合併這一步視為整個流程最容易出錯的階段,衝突規則分在注入和合併兩處。
表 2:OpenAI Cookbook 範例的衝突規則。整理自 Cookbook 頁面。
Mastra 全交給背景。依文件預設,原始訊息累積到 30,000 token,Observer 把它們壓成帶日期與重要度標記的觀察,以觀察紀錄取代 context 裡的原始訊息(開啟 retrieval 時,原始訊息仍可由 recall 工具讀回);觀察累積到 40,000 token,Reflector 再重組、修剪一次。兩個門檻都可調,文件並預設開啟非同步緩衝(async buffering),觀察是在背景建立的。Barnes 的文章提到,prompt cache 會重複使用先前處理過的提示內容;訊息只往後追加,所以快取每一輪都能命中,只有 Reflector 動手時整份才失效。他們自己的 LongMemEval 結果(500 題的 longmemeval_s):搭配 gpt-5-mini 為 94.87%;搭配 gpt-4o 為 84.23%,高於同頁列出的 oracle 設定 82.4%。oracle 是只把含答案的那幾段對話直接給模型,所以這代表壓縮後的紀錄在這項評測上,分數超過直接給證據原文。這些是 Mastra 自己公布的數字。
Claude Code 由模型在對話中自己寫。文件說 Claude 不是每個 session 都存,它依「這件事下次對話有沒有用」自己判斷;介面上會看到「Saved 2 memories」。Managed Agents 另有研究預覽的 dreams:一個非同步工作,讀既有記憶庫加最多 100 份過去的對話紀錄,產出一個新的整理過的記憶庫,原本的記憶庫不會被改動。
工程上的意思:更新者決定錯誤從哪一輪開始影響回答,對話中寫入最快,Cookbook 合併要到下個 session。
Managed Agents 的文件還警告,Agent 處理不受信任的輸入時,可能遇到 prompt injection(用惡意內容誘使 Agent 偏離原指令的攻擊)。攻擊成功的話,惡意內容可能被寫進記憶庫,之後的 session 會把它當成可信記憶讀進來。文件建議只讀的資料用 read_only 掛載。
向量檢索到底在哪一步才需要?
六個做法裡,有明文的三家把向量放在預設流程之外,另三家文件未提;從 Mastra 的選項看,向量檢索接在壓縮之後,用來找回被壓掉的細節。
Gupta 的逆向分析和 Mastra 2026 年 2 月的文章都明講不用向量。同一個 Mastra,文件現在多了兩段:設 retrieval: true,Agent 多一個 recall 工具,能回頭瀏覽原始訊息,這一步不需要向量庫。設 retrieval: { vector: true },則再加入語意搜尋,沿用同一個 Memory 記憶元件的向量庫,以及把文字轉成向量的模型(embedder);新的觀察群組會自動建立索引。壓縮過的觀察是預設,要找回壓掉的細節,才在後面接檢索。
OpenAI Cookbook 解釋過為什麼它選狀態而不選檢索:旅遊決策需要一份一致、有優先順序的當前狀態,過去互動被當成鬆散文件檢索時,處理不了衝突和覆蓋。Plastic Labs 對向量的評語見第 2 節。
替代解釋有兩個。第一,這些做法能不用向量,不代表大規模也撐得住:33 條事實是單一帳號的樣本,200 行是索引的載入上限,30k token 是 Mastra 壓縮的觸發門檻,三者都不是記憶總量。第二,LongMemEval 分數是廠商自己跑的,Claude Code、Honcho 與 Managed Agents 的文件沒有說明有沒有向量,不能反過來推論它們沒用。
如果你的內部 Agent 或客服,每位使用者只需要幾十條筆記,就落在小規模這一側。
小規模的記憶,先放檔案和筆記
我的判斷是:每位使用者或每個專案只有幾十到幾百條記憶,而且整包放得進開場預算時,先用有日期、有類型的文字檔。開場整包注入,寫入走明確的工具,整理另排一個背景步驟,再留一個能讓人直接修改的入口。OpenAI Cookbook 注入時的四條優先序,加上合併時的日期規則,是最小可用的衝突處理;自己實作、自己維護,就是代價。整包注入開始擠掉任務內容,或要跨大量使用者查詢時,這個判斷就失效,那時才加索引,關鍵字或向量都行。寫入與整理決定記憶好不好用,向量只是其中一種索引。下一次回頭檢查,我會看 Mastra 的向量選項有多少人真的打開。
常見問題
ChatGPT 的記憶是用向量資料庫做的嗎?
依 Manthan Gupta 2025 年 12 月的逆向分析,沒有:長期記憶是事實清單,近期對話以預先算好的摘要直接放進 prompt,不對歷史對話做檢索。這是從對話行為推出的結果,Gupta 也註明 OpenAI 沒有公布實作細節。
Claude Code 的 auto memory 存在哪裡?會被截掉嗎?
存在 ~/.claude/projects/<project>/memory/,是只在本機的 markdown 檔。MEMORY.md 是記憶索引,每次開場只載入前 200 行或 25KB,超過的部分不載入。各主題的細節另存成 topic 檔,開場不載入,Claude 需要時才讀。
Mastra 的 Observational Memory 什麼時候壓縮對話?
依 Mastra 文件預設,原始訊息累積到 30,000 token(token 是模型計算文字長度的單位)時,背景程序 Observer 壓成觀察紀錄;紀錄累積到 40,000 token 時,另一個背景程序 Reflector 再重組、修剪。兩個門檻都能調,觀察預設在背景建立(非同步緩衝)。
自己做 Agent 記憶,要先選向量資料庫嗎?
不用先選。記憶量小、整包放進 context(模型這次能讀到的內容)後仍留得下任務資料時,文字檔加一個寫入工具就能起步;整包注入擠掉任務內容,或要跨大量使用者查詢時,再加索引(讓模型不必整包載入,只查需要的部分)。
延伸閱讀
- Agent Memory 是什麼?AI 該記什麼、誰批准、何時刪?(2026 完整懶人包)
- 為什麼 AI 越聊越笨、一直犯同樣的錯?Anthropic 揭密 Context Engineering 實戰(2026 懶人包)
- RAG、Workflow、Agent 差在哪?什麼時候真的需要 Agent?(2026 完整比較)
參考資料
- Anthropic, How Claude remembers your project(Claude Code 文件,2026-10-23 查閱) https://code.claude.com/docs/en/memory
- Anthropic, Using agent memory(Managed Agents 文件,beta header agent-memory-2026-07-22,2026-10-23 查閱) https://platform.claude.com/docs/en/managed-agents/memory
- Anthropic, Dreams(Managed Agents 文件,研究預覽,2026-10-23 查閱) https://platform.claude.com/docs/en/managed-agents/dreams
- Manthan Gupta, I Reverse Engineered ChatGPT's Memory System(2025-12-09,逆向分析,非官方文件) https://manthanguptaa.in/posts/chatgpt_memory/
- Simon Willison, Memory and new controls for ChatGPT(2024-02-14) https://simonwillison.net/2024/Feb/14/memory-and-new-controls-for-chatgpt/
- Tyler Barnes, Mastra, Announcing Observational Memory(2026-02-09) https://mastra.ai/blog/observational-memory
- Mastra, Observational Memory(文件,2026-10-23 查閱) https://mastra.ai/docs/memory/observational-memory
- OpenAI, Context Engineering for Personalization(OpenAI Cookbook,頁面未標示日期,2026-10-23 查閱) https://developers.openai.com/cookbook/examples/agents_sdk/context_personalization
- Plastic Labs, Memory as Reasoning(2025-08-19) https://plasticlabs.ai/blog/posts/Memory-as-Reasoning
- Honcho, Overview(文件,2026-10-23 查閱) https://honcho.dev/docs/v3/documentation/introduction/overview
留言0
登入後就能留言。
登入