
上一篇拆開了 LSTM/GRU 如何更新狀態。當任務變成翻譯,還要處理兩段長度不同的序列。一句中文翻成英文,輸出可能多幾個詞;翻成法文,動詞和主詞的位置也可能不同。若模型只能讓輸入第 1 個位置預測輸出第 1 個位置,就很難直接表達這種對應關係。
Seq2Seq 把兩段工作拆開:Encoder 讀來源序列,Decoder 逐步產生目標序列。兩邊長度可以不同,輸出詞也不必和輸入詞逐位置對齊。真正需要釐清的是:Encoder 把讀到的資訊交給 Decoder 的方式是什麼?訓練時餵給 Decoder 的前一個詞,和生成時餵給它的詞,又差在哪裡?
本文會用六張教材原圖、兩張逐步輸入圖表,以及一段可重跑的 CPU 小程式,分清固定狀態、Teacher Forcing、自回歸生成和 Attention 加權。數值與輸出都是手設機制例,不是訓練過的翻譯模型。
Encoder 和 Decoder 解決不同的序列工作
Encoder 依序讀來源 token,將每個位置轉成模型內部的表示;Decoder 則用目前可取得的資訊,一步一步預測下一個目標 token。本文用 x_1, …, x_T 表示長度為 T 的來源,用 y_1, …, y_S 表示長度為 S 的目標。一般不要求 T = S。
序列模型要描述的,是在已知來源 x 的條件下,依序產生目標 y。概念上可寫成:
p(y_1, …, y_S | x)
  = ∏ᵢ p(y_i | y_1, …, y_(i−1), x)
每一步預測的是下一個 token;解碼器可用已產生的目標前綴和來源表示,不代表輸入第 i 個位置就要輸出來源第 i 個位置的對應詞。
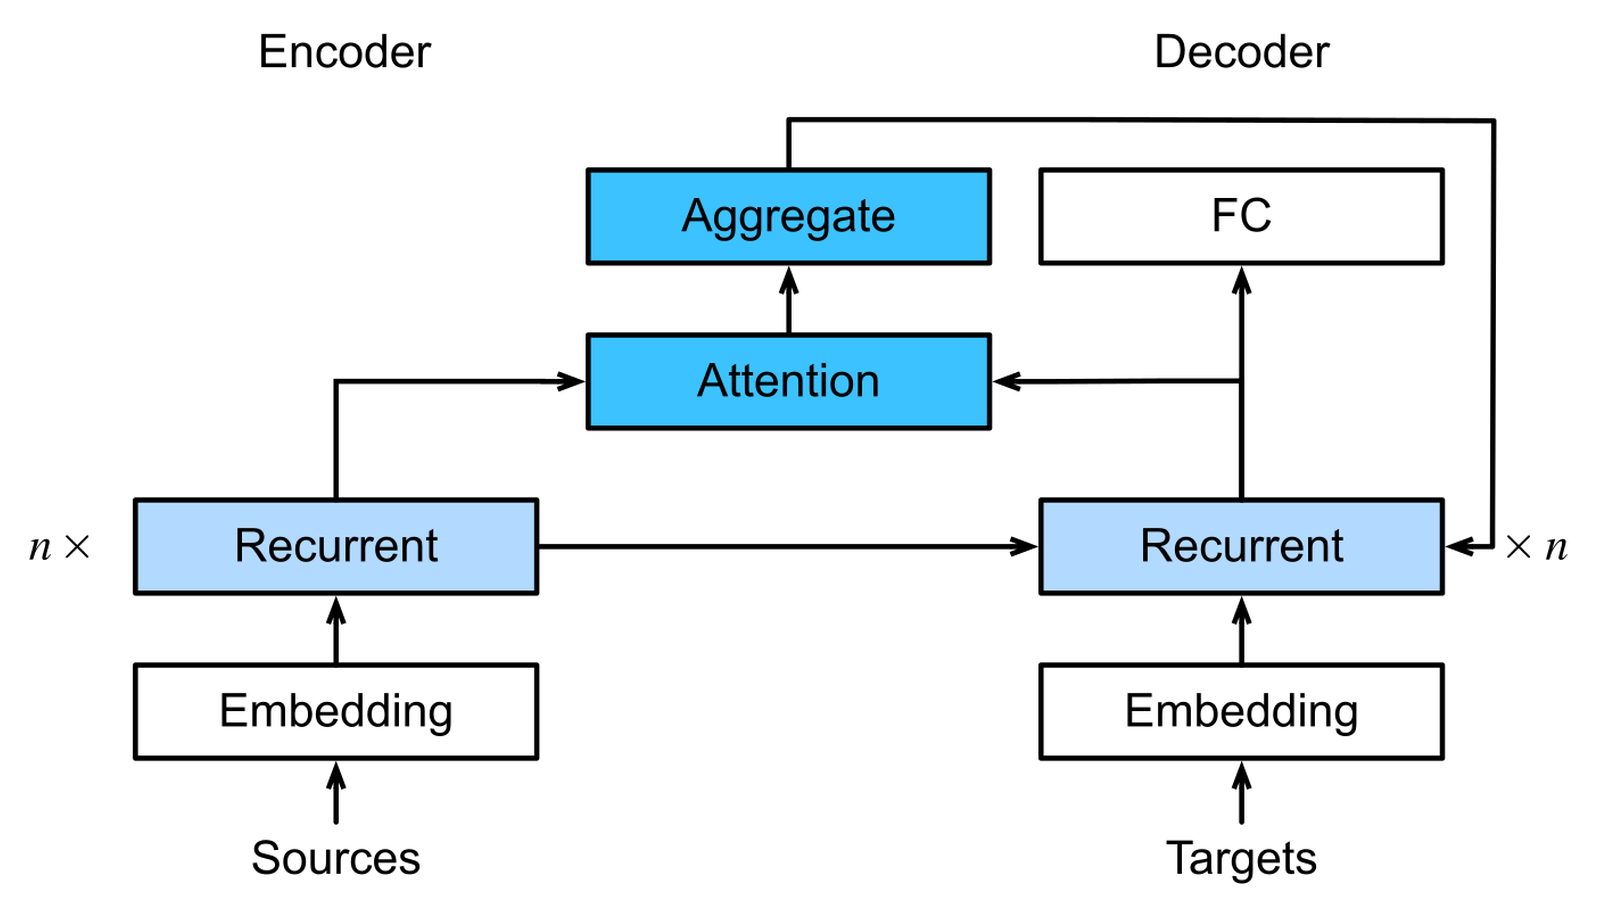
把整個流程攤開後,固定狀態版本會把 Encoder 讀完來源後的狀態傳給 Decoder。圖中的 n× 是循環層重複堆疊的結構示意,並非要求來源和目標 token 數相同;資料流先經過 embedding,再進入循環模組。
把很多來源資訊壓到有限狀態,可能成為表示與訓練上的瓶頸;但這不代表所有長序列都必然失敗。模型大小、資料、訓練方式和任務都會影響結果。後面的 Attention 會提供另一種讀取來源表示的方法,但也不能保證任意長度或翻譯品質。
訓練會把正確的前一詞餵回 Decoder
訓練一個自回歸 Decoder 時,常用 Teacher Forcing:要預測第 i 個目標 token,就將前一個正確 token y_(i−1) 作為這一步的輸入。第一步沒有前一個目標詞,所以用起始符 <bos>。每一步預測的標籤則是當前的 y_i。
D2L 原圖用 They are watching . <eos> 作為來源,並示範法文目標 Ils regardent . <eos>。底下那列是右移一格的 Decoder 輸入,起點為 <bos>:
目標步驟 i | Decoder 輸入 | 要預測的標籤 y_i |
|---|---|---|
| 1 | <bos> | Ils |
| 2 | Ils | regardent |
| 3 | regardent | . |
| 4 | . | <eos> |
輸入與標籤錯開一格,是為了讓 Decoder 用已知前綴預測下一詞。它不是把同一位置的答案送進去,也不是使用未來 token。訓練時會把每一步的輸出 logits 和正確標籤比較,再依有效目標 token 計算 loss;補長度用的 <pad> 不該當成要預測的詞。這篇原型沒有實作或驗證 target loss masking,因此不把後面的程式當作訓練範例。
生成時,輸入改成模型自己的上一個輸出
實際生成時,後續正確詞還不存在,Decoder 得把前一步自己產生的 token 餵回去。這稱為 自回歸生成。下面的原型另用一個省去句點、詞彙小寫的三步例子,以固定、人工指定的 logits 作查表,刻意讓 Teacher Forcing 和自回歸兩條路走出不同輸入:
| 生成步驟 | 餵給 Decoder 的詞 | 人工 logits 中最高分的輸出 |
|---|---|---|
| 1 | <bos> | nous |
| 2 | nous | sommes |
| 3 | sommes | <eos> |
在本例中,迴圈遇到 <eos> 就停止,另設 max_steps 上限,避免沒有終止符時無限生成。實際系統會依其生成程式設定處理 EOS、長度限制或其他停止條件;不能只憑圖推定某一份 helper 的執行方式。D2L 這個 pinned 版本的 predict_step 會先跑固定步數,之後才在輸出後處理中截到 EOS,並非一輸出 EOS 就立刻離開迴圈。
<bos>、<eos> 和 <pad> 的作用也不同:<bos> 啟動目標生成,<eos> 表示目標序列結束,<pad> 是批次對齊時補出的空位。模型對來源端 PAD 的注意力遮罩,和計算目標端 loss 時忽略 PAD,是兩件分開處理的事。
Attention 讓 Decoder 每一步讀取來源表示
固定 state baseline 主要靠一個狀態把來源資訊帶給 Decoder。Attention 另外保留 Encoder 各來源位置的隱藏狀態,讓 Decoder 在每個輸出步驟,依當下的 query 對來源位置打分,再取加權和。這是在讀取已編碼的狀態;Encoder 不需要因每個目標詞而重跑一次。
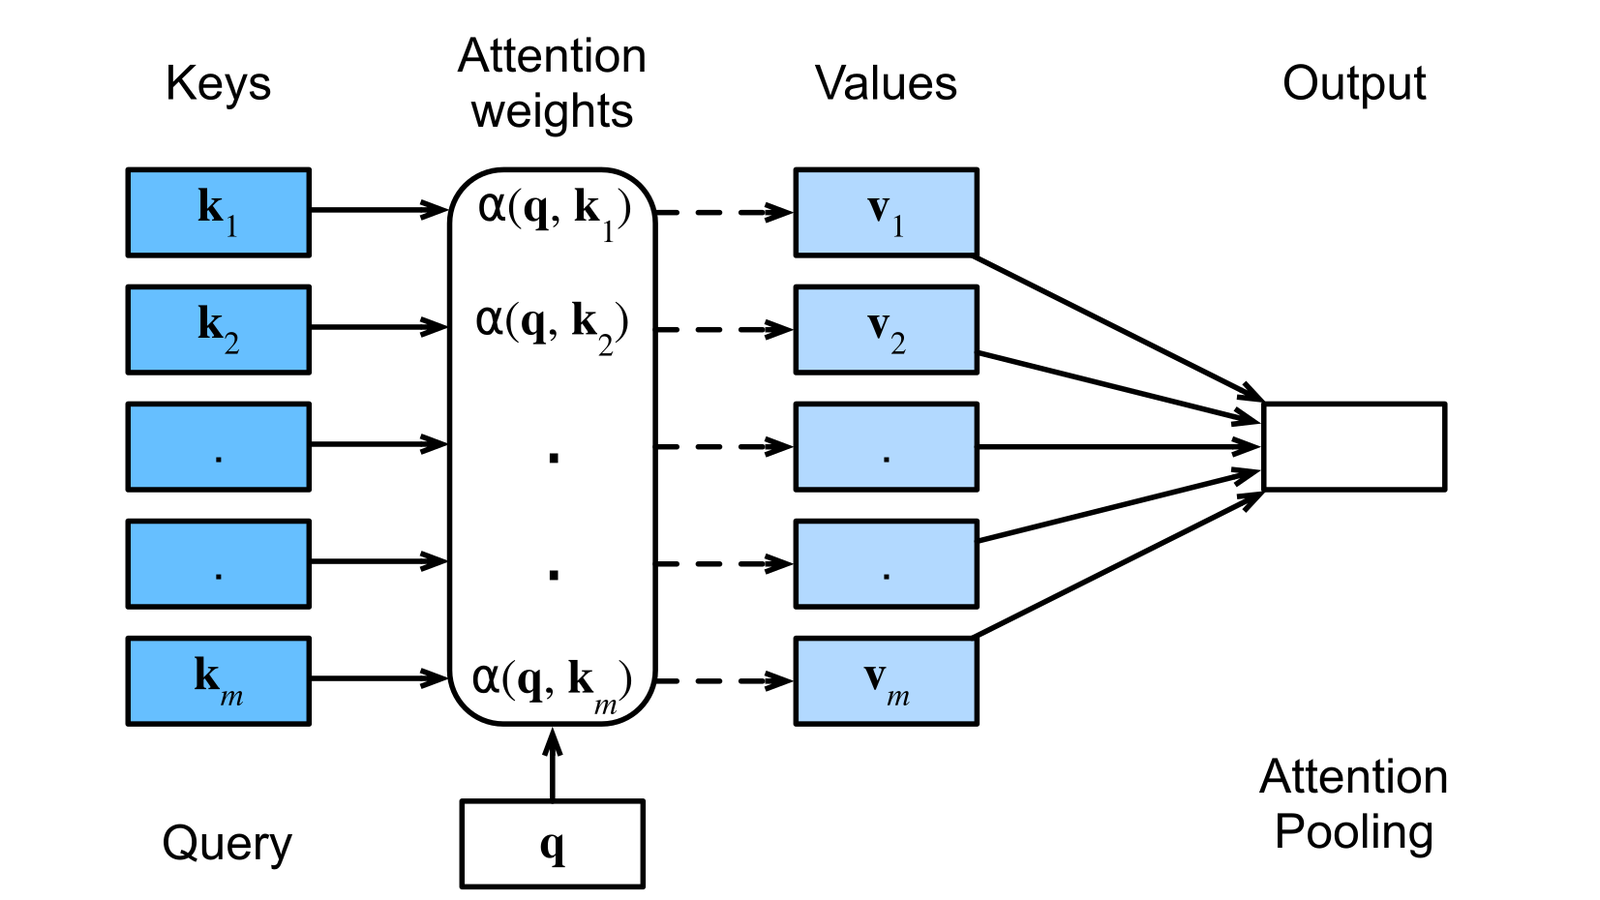
先看一般的 attention pooling 圖:query 和每個 key 進入打分函數,分數經 softmax 變成權重,再分別乘上對應 value,最後加總成 output。
以目標輸出步驟 i、來源位置 j 為索引,令 h_j 是 Encoder 在來源位置 j 的狀態,s_(i−1) 是 Decoder 產生第 i 個目標前的狀態。Bahdanau 式 additive attention 可用下列形式描述打分:
e_ij = vᵀ tanh(W_q s_(i−1) + W_k h_j)
α_ij = softmax over valid source positions j of e_ij
c_i  = Σ_j α_ij h_j
e_ij 是第 i 個輸出步驟對來源位置 j 的分數,α_ij 是沿有效來源位置正規化後的權重,c_i 是本步的 context。這裡用帶權重矩陣的簡寫表示可學的 additive 打分;偏置等細節會依實作而異。每個目標步驟會有一組權重,因此 c_i 的內容可隨 query 改變;它的向量維度則維持固定。
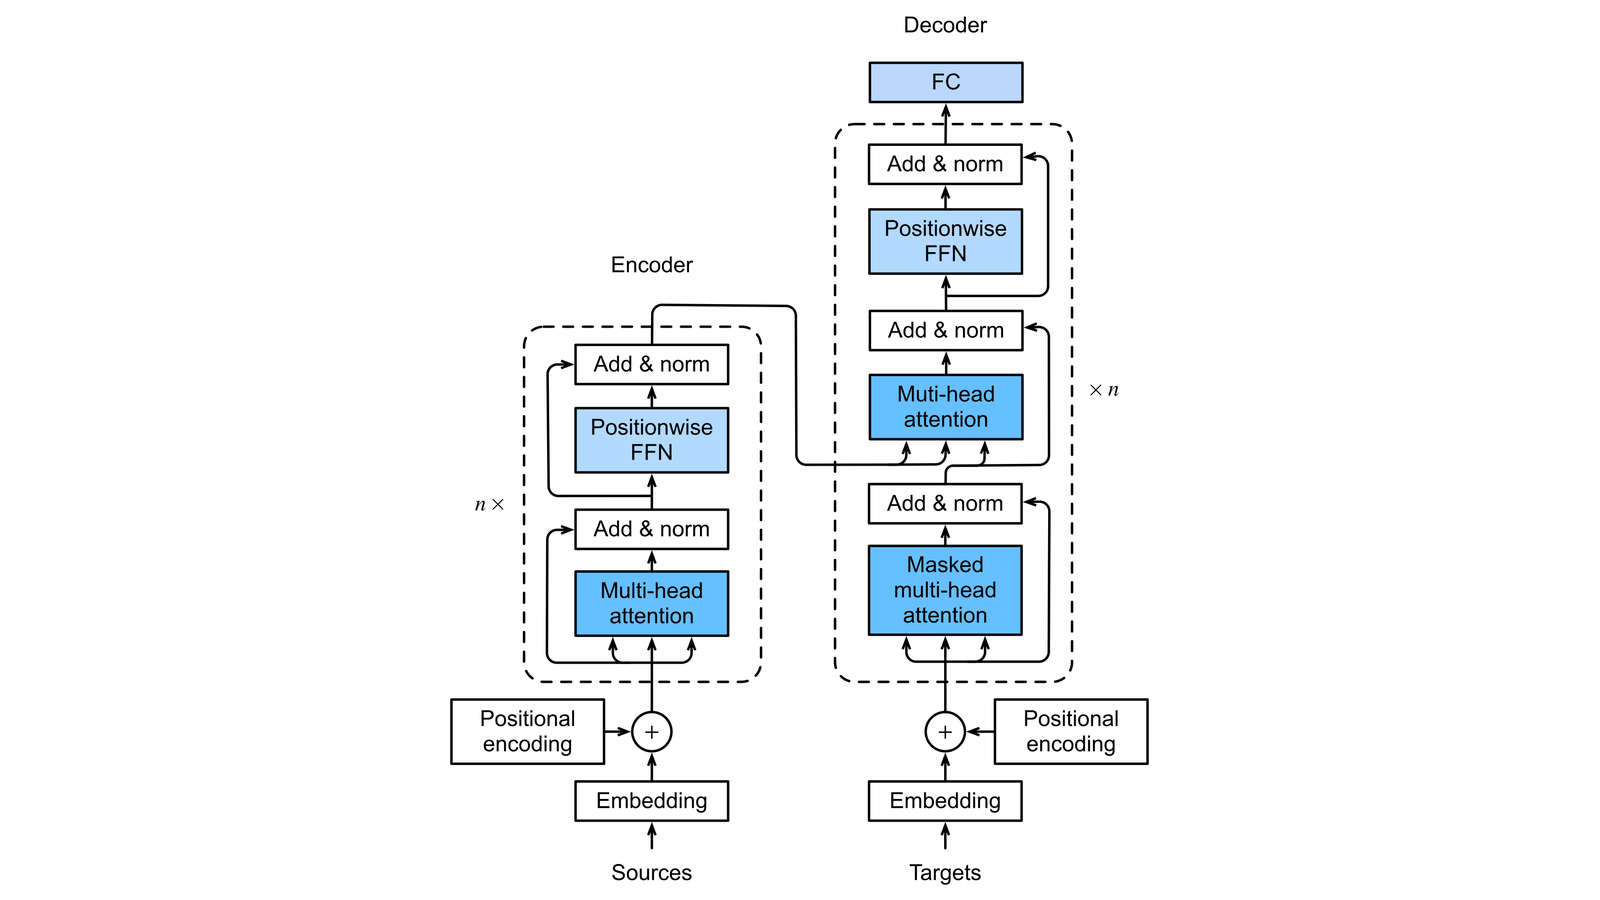
在 D2L 這個 RNN attention 範例中,前一步 Decoder hidden state 作 query,Encoder 各步 hidden state 作 keys 和 values。取得的 context 會與當步目標詞的 embedding 一起送入 Decoder;Encoder 最後狀態另作 Decoder 初始化。這是帶 cross-attention 的 RNN encoder–decoder,並不是 Transformer self-attention。
加權權重只表示這個計算把多少比重分配給每個 value。它不是翻譯正確率,也不等於已證明的因果理由;就算權重圖集中在某個來源詞,也不能只靠這件事證明模型因此做出正確決策。Attention 改變了可讀取來源表示的方式,不保證每個長距離關係都被學會。
手算一個有 padding mask 的 query
先用一維 query 和 keys 算分數,再以四列二維 values 看 context 如何形成。最後一列是 padding:它的 key 即使分數最高,也必須在 softmax 前遮掉。這是可逐項核算的手設例,不是從訓練資料學到的參數。
| 位置 | Key | Value | 有效? |
|---|---|---|---|
| 1 | 1 | [1, 0] | 是 |
| 2 | 0 | [0, 2] | 是 |
| 3 | 1 | [2, 1] | 是 |
| 4 | 2 | [100, 100] | 否,padding |
設定 query q=[1],用 scaled dot product q·k / √d_k。這裡 key depth d_k=1,所以除數 √1=1,原始分數依序為 [1, 0, 1, 2]。只對前三個有效位置做 softmax:
α = softmax([1, 0, 1])
  = [e/(2e+1), 1/(2e+1), e/(2e+1)]
  ≈ [0.422319, 0.155362, 0.422319]
padding 的權重是 0,context 為:
c = 0.422319 × [1, 0]
  + 0.155362 × [0, 2]
  + 0.422319 × [2, 1]
  + 0 × [100, 100]
  ≈ [1.266956, 0.733044]
這也說明 key 的維度與 value 的維度不需要相同:key 深度是 1,用來和 query 計分;value 深度是 2,用來生成二維 context。key 與 value 的位置數則要對齊,因為每個權重必須乘到相同位置的 value。
實作 mask 時應遮掉無效位置的 score,再沿 key 位置做 softmax;只把 padding value 設為零,卻讓它留在 softmax 分母裡,仍會稀釋有效權重。這個小程式假設 caller 傳入有限浮點分數,以及整數型的有效前綴長度 1..K;它支援每個 batch 共用一個長度,或每個 query 指定一個長度。它會拒絕沒有任何有效 key 的 query。某些教材以有限的 −1e6 表示被遮位置,但若整列都被遮,有限分數會彼此相等,softmax 可能回傳均勻分布;全空 key 集合不能當作一個正常注意力分布。
可重跑的機制原型
以下完整程式用 CPU 與 float64 做手設 Q/K/V 計算,並和獨立 Python 純量計算核對。Teacher Forcing 與自回歸示範則使用人工固定 logits 查表;它沒有 encoder、學習參數、語料、訓練、target loss、BLEU 或翻譯品質評估。請將這些輸出視為機制驗算,不要解讀成學好的翻譯結果。
"""Deterministic CPU/float64 Seq2Seq attention mechanics; no model training."""
from __future__ import annotations

import json
import math
import platform

import torch


def masked_softmax(scores: torch.Tensor, valid_lens: torch.Tensor) -> torch.Tensor:
    """Softmax over valid keys; reject any query with no valid key.

    Args:
        scores: (batch, queries, keys) unnormalized attention scores.
        valid_lens: (batch,) or (batch, queries), number of valid leading keys.
    """
    if scores.ndim != 3:
        raise ValueError("scores must have shape (batch, queries, keys)")
    batch, queries, keys = scores.shape
    valid_lens = torch.as_tensor(valid_lens, dtype=torch.long, device=scores.device)
    if valid_lens.ndim == 1 and valid_lens.shape[0] == batch:
        flat_lens = valid_lens.repeat_interleave(queries)
    elif valid_lens.ndim == 2 and tuple(valid_lens.shape) == (batch, queries):
        flat_lens = valid_lens.reshape(-1)
    else:
        raise ValueError("valid_lens must have shape (batch,) or (batch, queries)")
    if torch.any(flat_lens < 1):
        raise ValueError("each query must have at least one valid key; empty key sets are rejected")
    if torch.any(flat_lens > keys):
        raise ValueError("valid key count cannot exceed the key dimension")

    positions = torch.arange(keys, dtype=torch.long, device=scores.device)
    keep = positions.unsqueeze(0) < flat_lens.unsqueeze(1)
    flat_scores = scores.reshape(batch * queries, keys)
    masked_scores = flat_scores.masked_fill(~keep, float("-inf"))
    return torch.softmax(masked_scores, dim=-1).reshape(batch, queries, keys)


def rounded(values: torch.Tensor, digits: int = 12):
    if values.ndim == 0:
        return round(float(values.item()), digits)
    if values.ndim == 1:
        return [round(float(value), digits) for value in values.tolist()]
    return [rounded(row, digits) for row in values]


def main() -> None:
    # One fixed query, three real source positions, and one padded position.
    # Key depth is one, so scaled dot product (divide by sqrt(d_k)) equals q @ k.T.
    queries = torch.tensor([[[1.0]]], dtype=torch.float64, device="cpu")
    keys = torch.tensor([[[1.0], [0.0], [1.0], [2.0]]], dtype=torch.float64, device="cpu")
    values = torch.tensor(
        [[[1.0, 0.0], [0.0, 2.0], [2.0, 1.0], [100.0, 100.0]]],
        dtype=torch.float64,
        device="cpu",
    )
    valid_lens = torch.tensor([3], dtype=torch.long, device="cpu")
    key_depth = queries.shape[-1]
    scores = torch.bmm(queries, keys.transpose(1, 2)) / math.sqrt(key_depth)
    weights = masked_softmax(scores, valid_lens)
    context = torch.bmm(weights, values)

    # Independent scalar calculation using the same fixed inputs.
    raw_scores = [1.0, 0.0, 1.0]
    exp_scores = [math.exp(score - max(raw_scores)) for score in raw_scores]
    py_weights = [value / sum(exp_scores) for value in exp_scores]
    py_context = [
        sum(py_weights[i] * values[0, i, dim].item() for i in range(3))
        for dim in range(values.shape[-1])
    ]
    assert max(abs(weights[0, 0, i].item() - py_weights[i]) for i in range(3)) < 1e-14
    assert weights[0, 0, 3].item() == 0.0
    assert abs(float(weights.sum().item()) - 1.0) < 1e-14
    assert max(abs(context[0, 0, i].item() - py_context[i]) for i in range(2)) < 1e-14

    try:
        masked_softmax(scores, torch.tensor([0], dtype=torch.long, device="cpu"))
        empty_key_result = "unexpectedly accepted"
        raise AssertionError("empty-key row must be rejected")
    except ValueError as exc:
        empty_key_result = str(exc)

    # Deliberate counterexample: finite -1e6 sentinels become equal logits
    # when every position is masked, so softmax returns a uniform distribution.
    # This is not a valid empty-key attention result and is not used above.
    all_masked_finite = torch.full((1, 1, 3), -1e6, dtype=torch.float64, device="cpu")
    finite_sentinel_bad_result = torch.softmax(all_masked_finite, dim=-1)

    # Fixed illustrative logits: not outputs of a trained model.
    vocab = ["ils", "nous", "regardent", "sommes", "<eos>"]
    toy_logits = {
        "<bos>": [0.2, 1.0, -1.0, -2.0, -3.0],
        "ils": [-2.0, -1.0, 1.2, 0.0, -3.0],
        "regardent": [-3.0, -3.0, -2.0, -2.0, 1.3],
        "nous": [-3.0, -2.0, -3.0, 1.1, -1.0],
        "sommes": [-3.0, -3.0, -3.0, -2.0, 1.2],
    }
    target = ["ils", "regardent", "<eos>"]
    teacher_inputs = ["<bos>"] + target[:-1]
    teacher_forced = []
    for step, (decoder_input, label) in enumerate(zip(teacher_inputs, target)):
        predicted = vocab[int(torch.argmax(torch.tensor(toy_logits[decoder_input], dtype=torch.float64)).item())]
        teacher_forced.append({
            "step": step,
            "decoder_input_from_gold_prefix": decoder_input,
            "target_label": label,
            "argmax_from_fixed_logits": predicted,
        })

    autoregressive = []
    decoder_input = "<bos>"
    stopped_on_eos = False
    max_steps = 6
    for step in range(max_steps):
        predicted = vocab[int(torch.argmax(torch.tensor(toy_logits[decoder_input], dtype=torch.float64)).item())]
        autoregressive.append({"step": step, "decoder_input_from_previous_prediction": decoder_input,
                               "argmax_from_fixed_logits": predicted})
        if predicted == "<eos>":
            stopped_on_eos = True
            break
        decoder_input = predicted
    assert stopped_on_eos

    result = {
        "scope": "Hand-set one-query Q/K/V and fixed decoder-logit lookup only; no encoder, learned parameters, corpus, training, translation benchmark, or claim of trained output.",
        "environment": {"python": platform.python_version(), "torch": torch.__version__,
                        "device": str(queries.device), "dtype": str(queries.dtype)},
        "attention": {
            "shapes": {"queries": list(queries.shape), "keys": list(keys.shape),
                       "values": list(values.shape), "scores": list(scores.shape),
                       "weights": list(weights.shape), "context": list(context.shape)},
            "query": rounded(queries[0, 0]),
            "keys_including_pad": rounded(keys[0, :, 0]),
            "values_including_pad": rounded(values[0]),
            "valid_key_count": int(valid_lens[0].item()),
            "scores_scaled_dot_product": rounded(scores[0, 0]),
            "weights_after_valid_key_mask": rounded(weights[0, 0]),
            "weight_sum": round(float(weights.sum().item()), 12),
            "weighted_context": rounded(context[0, 0]),
            "pad_value_excluded": True,
            "independent_python_scalar_reference": {"valid_weights": [round(x, 12) for x in py_weights],
                                                     "context": [round(x, 12) for x in py_context],
                                                     "max_torch_difference_lt_1e-14": True},
        },
        "empty_key_boundary": {
            "valid_len_zero": "rejected",
            "error": empty_key_result,
            "finite_minus_1e6_all_masked_counterexample": rounded(finite_sentinel_bad_result[0, 0]),
            "counterexample_note": "D2L's finite sentinel makes every all-masked logit equal; softmax is uniform, not a valid empty-key attention distribution. This prototype explicitly rejects the row.",
        },
        "teacher_forcing_vs_autoregressive": {
            "gold_target_including_eos": target,
            "teacher_forcing_input_shift": teacher_inputs,
            "vocabulary_order": vocab,
            "fixed_logits_by_previous_token": toy_logits,
            "teacher_forced_steps": teacher_forced,
            "autoregressive_steps": autoregressive,
            "autoregressive_stopped_on_eos": stopped_on_eos,
            "max_steps_guard": max_steps,
            "note": "Logits are hand-written solely to demonstrate shifted gold-prefix inputs versus previous-prediction inputs. They are not from a trained Seq2Seq model. EOS ends this toy loop; PAD masking of target loss is outside this prototype.",
        },
        "checks": "PASS: scaled QK scores, mask excludes PAD key, valid weights sum to one, weighted context matches independent scalar calculation, empty valid-key row rejected, fixed-logit autoregressive loop terminates at EOS.",
    }
    print(json.dumps(result, ensure_ascii=False, indent=2, allow_nan=False))


if __name__ == "__main__":
    main()
執行環境為 Python 3.10.12、PyTorch 2.3.1+cu118,使用 CPU 和 torch.float64。命令為 python3 seq2seq_attention_mechanics.py;這個原型在上面限定的前提下,以獨立純量計算核對 softmax 權重與 context,也測試有效 key 數為 0 時會拒絕該輸入。它不是完整 Seq2Seq,也沒有學習或預測翻譯。
原型中的手設 logits 刻意讓 Teacher Forcing 的第一步(餵 <bos>)以 nous 為最高分,但正確標籤是 ils;這不是訓練錯誤率,而是展示「餵 gold prefix」不等於「輸出就等於 gold」。自回歸則沿著模型自己前一步的輸出,走到 nous → sommes → <eos>。實際學習後的 logits 會由模型參數和輸入狀態決定;這份查表沒有那些條件。
來源與實作邊界
- 六張原圖取自固定版 D2L 英文教材,依該版書籍授權 CC BY-SA 4.0 提供;圖說各自標作者、章節來源、轉換/裁切與改作授權。可直接對照四個原始章節:Encoder–Decoder、Seq2Seq、Attention Scoring Functions、Bahdanau Attention。D2L 範例程式碼另有授權,不在本圖像素材範圍。
- 原始方法可參閱 Bahdanau、Cho、Bengio 的 Neural Machine Translation by Jointly Learning to Align and Translate,以及 Sutskever、Vinyals、Le 的 Sequence to Sequence Learning with Neural Networks。D2L 教材範例和 Bahdanau 原論文不是逐項相同的網路:教材此處用單向 GRU encoder、以 Encoder 最後 state 初始化 Decoder,並用 additive attention;原論文方法的 encoder 是雙向,decoder 初始化與輸出層也有不同設計。本文不把教材圖說成原論文圖,也未重現論文翻譯實驗。
- 本文的手算及程式走的是 scaled dot-product;例子
d_k=1,縮放因子剛好是 1。它和前述 Bahdanau additive score 公式是不同的 scoring function,不要將兩者混稱成同一段實作。 - PyTorch 的 softmax 沿指定維度正規化,bmm 處理三維 batch matrix multiplication。程式只在有限浮點分數、shape 相符且每個 query 至少有一個有效 key 的條件下展示這個小例;沒有宣稱它是涵蓋所有 dtype、異常值、任意 sparse mask 或空 batch 的通用 attention API。
- 對來源端 PAD 的 score mask 與目標端 PAD 的 loss ignore 是不同步驟。這份原型只實作前者;target loss mask 是教材和官方 API 的文件概念,本次沒有在原型中計算或測試。
什麼時候這個拆解有用?
如果你要檢查一份 Seq2Seq 程式,先對照三件事:Encoder 和 Decoder 之間傳遞什麼;訓練的 Decoder input 是否比 target labels 右移一格;生成時是否回饋自己的輸出。加入 Attention 後,再確認 query、keys、values 各自取自哪個狀態,以及 padding score 是否在 softmax 前被遮掉。
這些檢查能說明資料怎麼流過模型、一次加權如何算出 context;它們不能單獨證明翻譯正確、權重就是因果解釋,也不能保證 Attention 一定勝過固定 state。真正的翻譯效果仍須在合適資料切分、明確評估規則與對照模型下測量。本文的手設例沒有做這些比較。
留言0
登入後就能留言。
登入