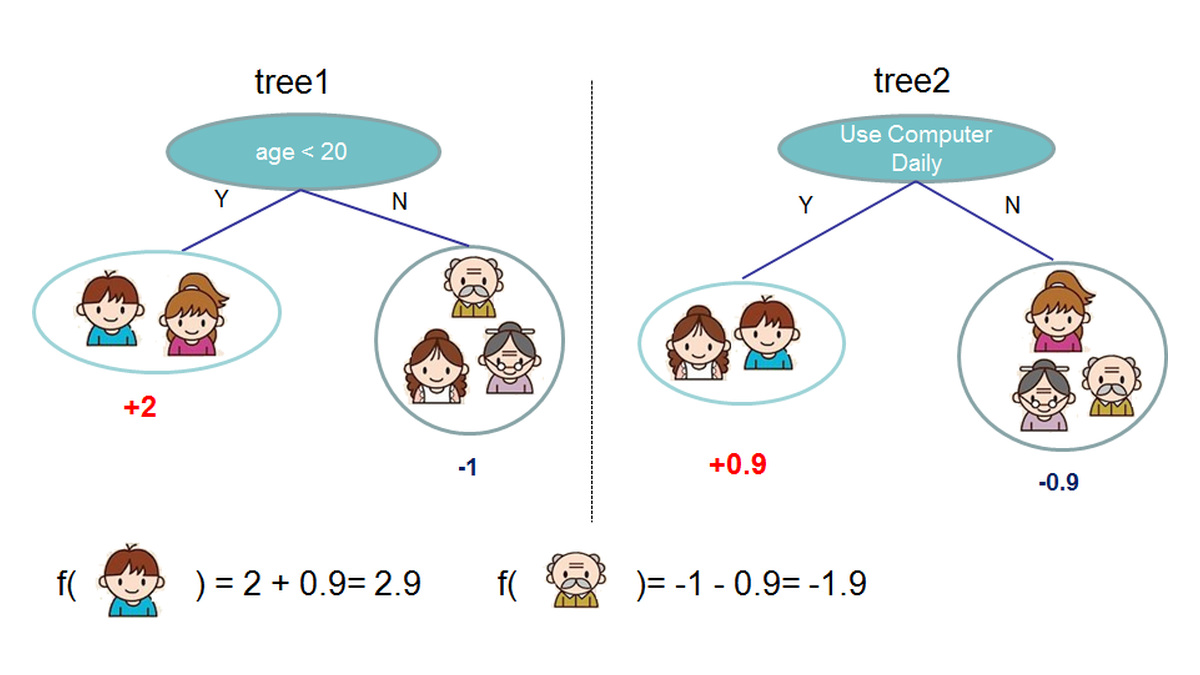
XGBoost:表格資料的重要基準模型
沿Boosting原理拆解XGBoost的梯度、Hessian、正則化葉分數與切分增益,再以XGBoost 2.1.0實跑合成表格迴歸,分清驗證early stopping與最終測試。
SERIES · 20 篇
從資料準備與經典機器學習開始,理解深度學習、電腦視覺、語言模型、生成模型與實務應用。以逐步圖解、具體例子與可檢查的依據說明技術的用途和限制。
沿Boosting原理拆解XGBoost的梯度、Hessian、正則化葉分數與切分增益,再以XGBoost 2.1.0實跑合成表格迴歸,分清驗證early stopping與最終測試。
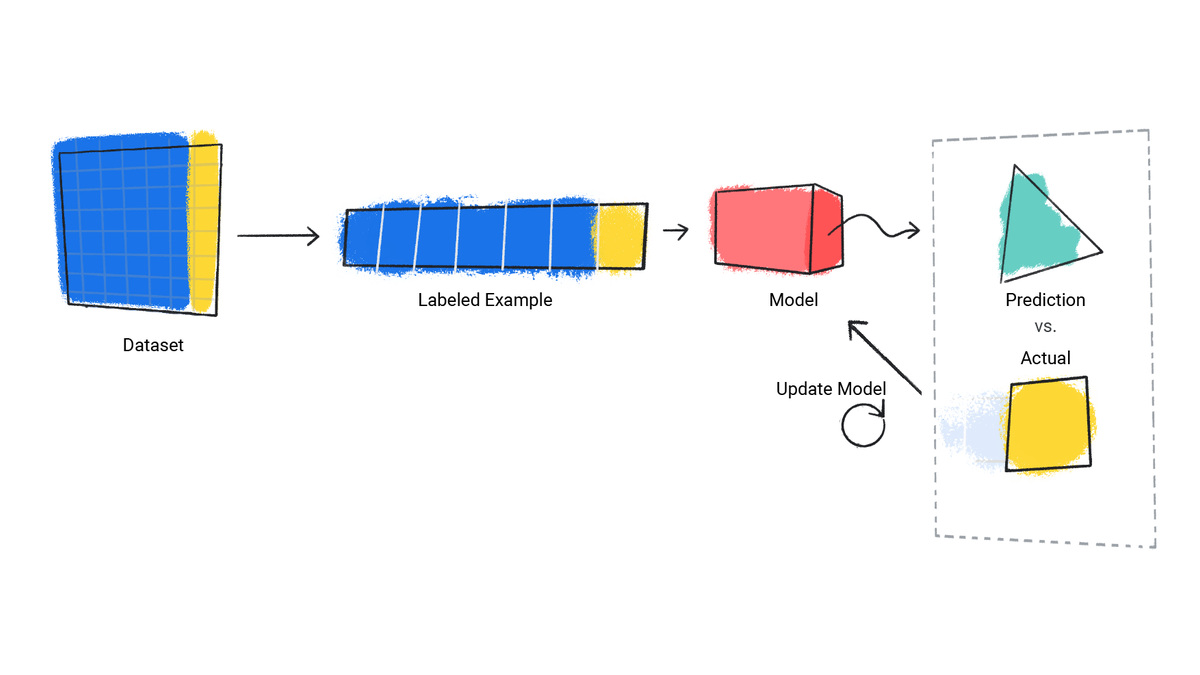
用訂單與配送情境理解資料科學、AI、機器學習和深度學習的關係,逐步拆開特徵、標籤、模型訓練與評估,並分辨回歸、分類、分群與生成任務。
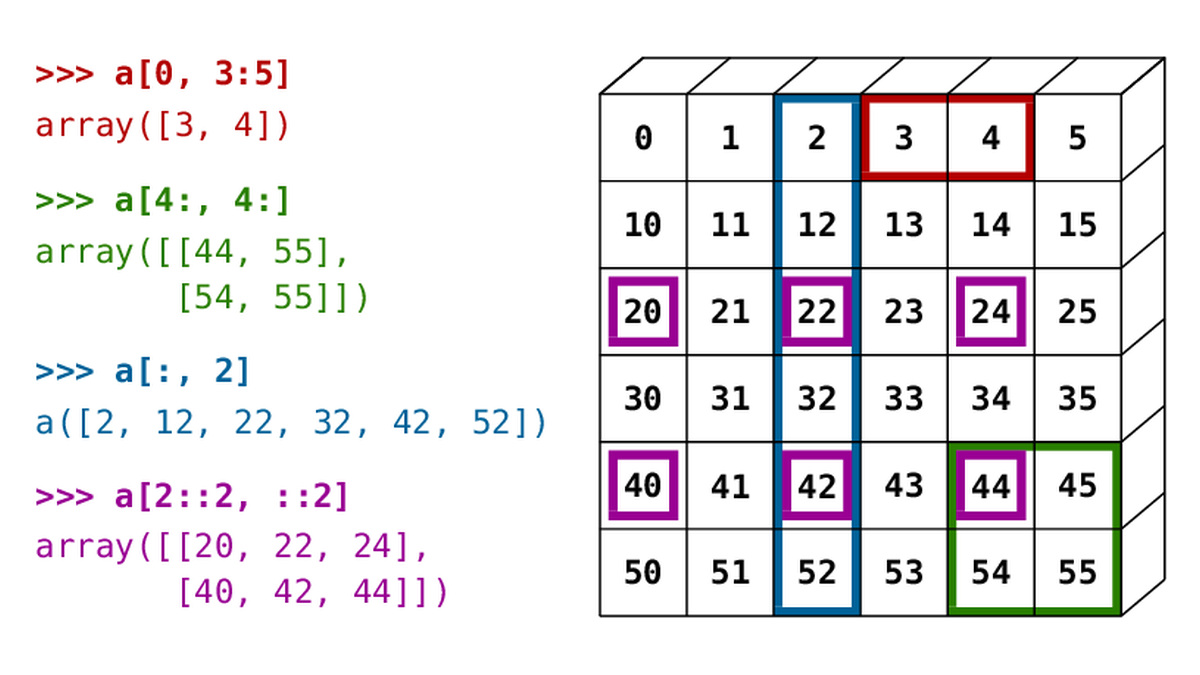
從完整提供的五筆訂單 CSV 開始,用 Python、pandas 與 NumPy 讀檔、分辨 Series 和 DataFrame、篩選列欄、計算訂單金額與檢查缺失值,並看懂 shape、切片、轉置和 reshape。
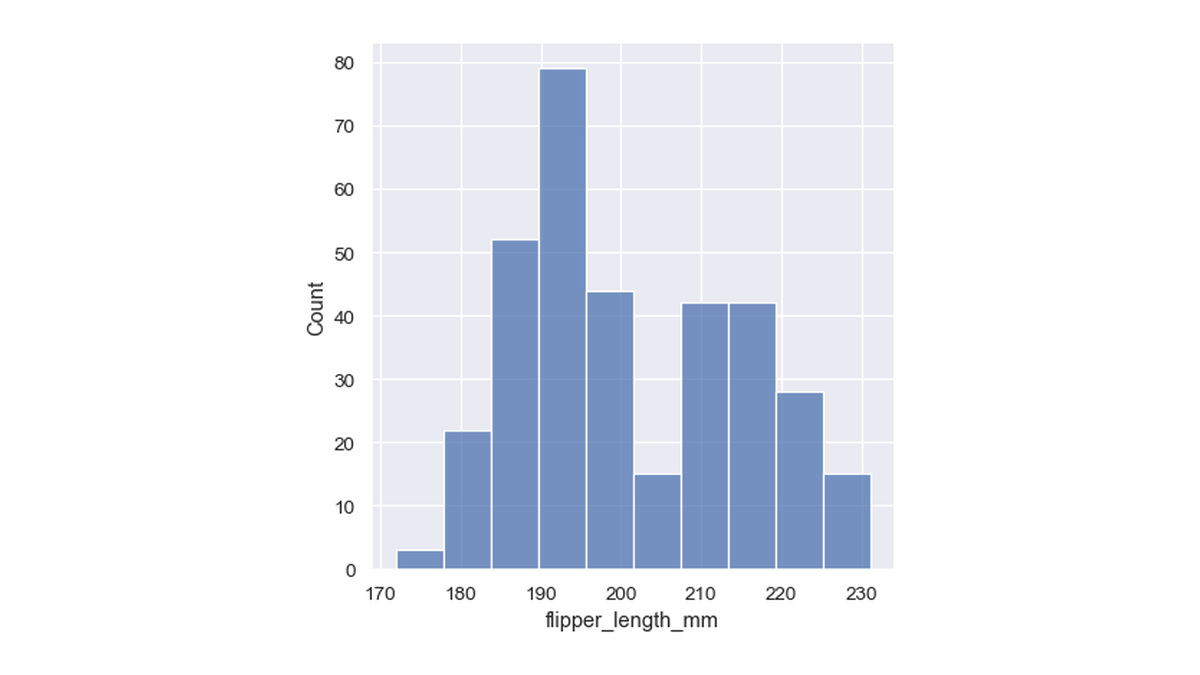
用配送時間與延遲預警的教學設例,拆解平均值、直方圖、KDE、抽樣波動、條件機率和貝氏定理。看懂樣本數的作用,以及為什麼抓到八成延遲,不代表收到預警就有八成機率延遲。
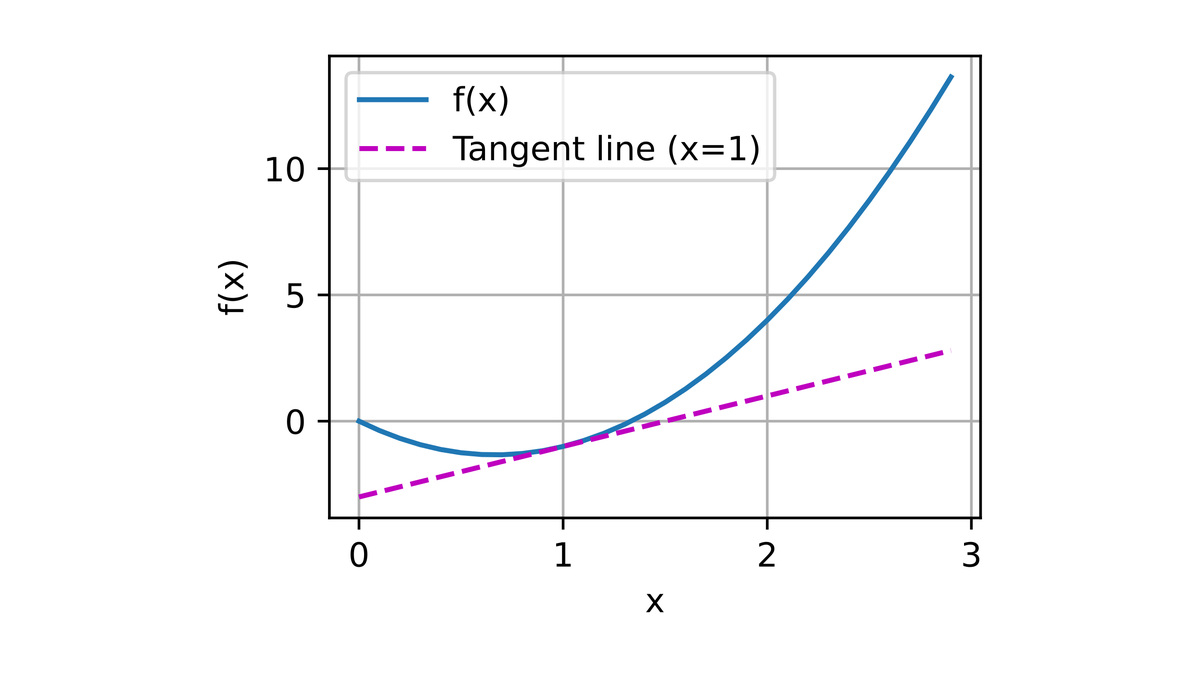
從訂單特徵與加權預測理解純量、向量、矩陣、點積、矩陣乘法、轉置與reshape,再用局部斜率、梯度和學習率拆解一次損失下降的計算與限制。
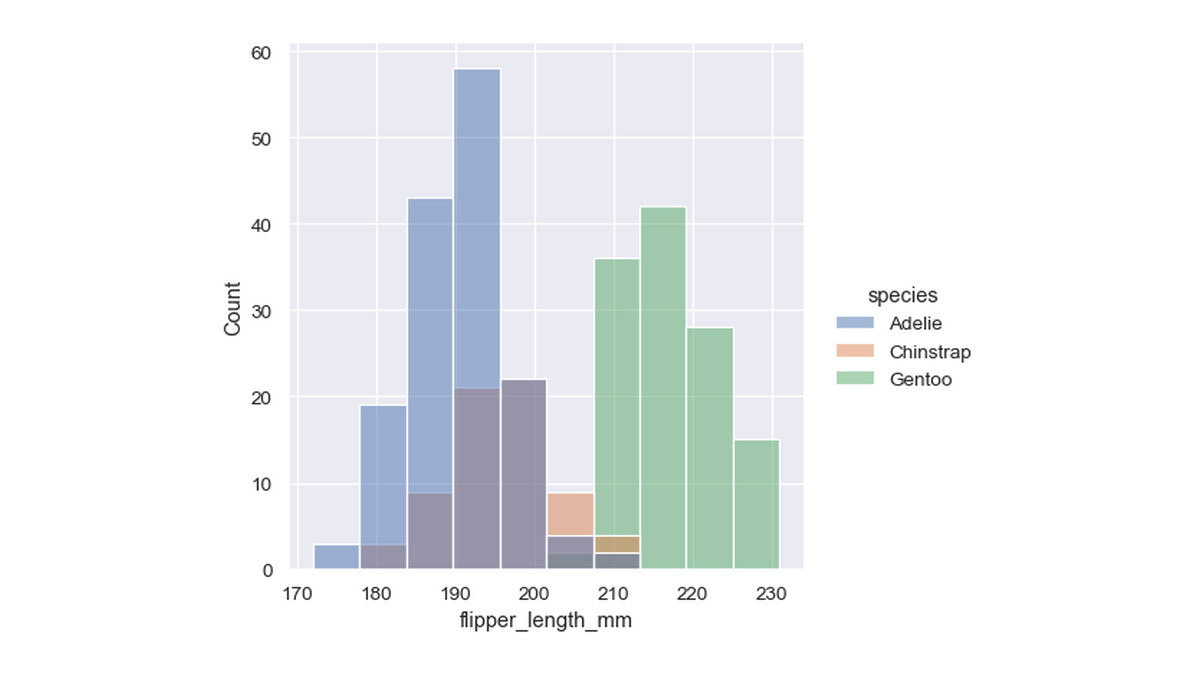
從觀測單位、缺失與類別筆數開始,逐步讀懂直方圖、分組分布、正規化與散點圖,並用配送組成改變的算例說明整體平均為什麼可能誤導。
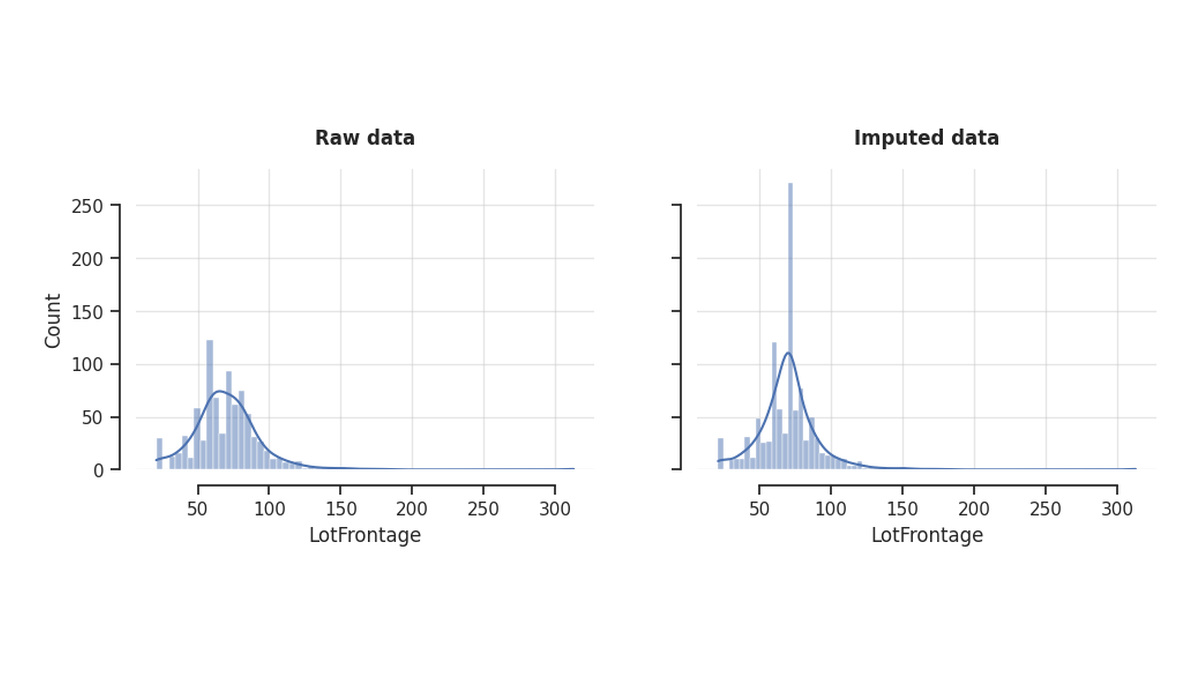
用訂單情境拆解缺失值、重複紀錄、錯誤值與合理極端值,對照均值填補、缺失類別、任意常數與截尾原圖,理解清理規則、訓練資料擬合和評估限制。
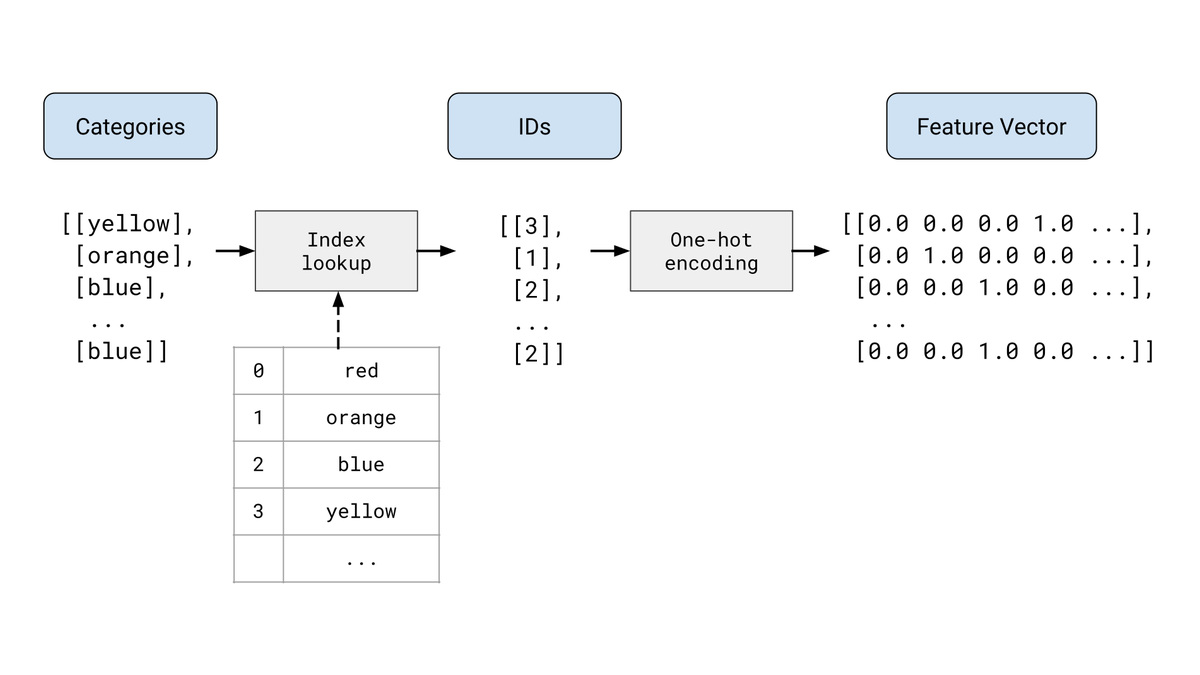
拆解one-hot編碼、未知類別、稀疏表示、min-max與Z-score縮放、對數轉換、截尾、分箱及特徵選擇,理解模型如何看待資料,以及如何避免前處理洩漏。
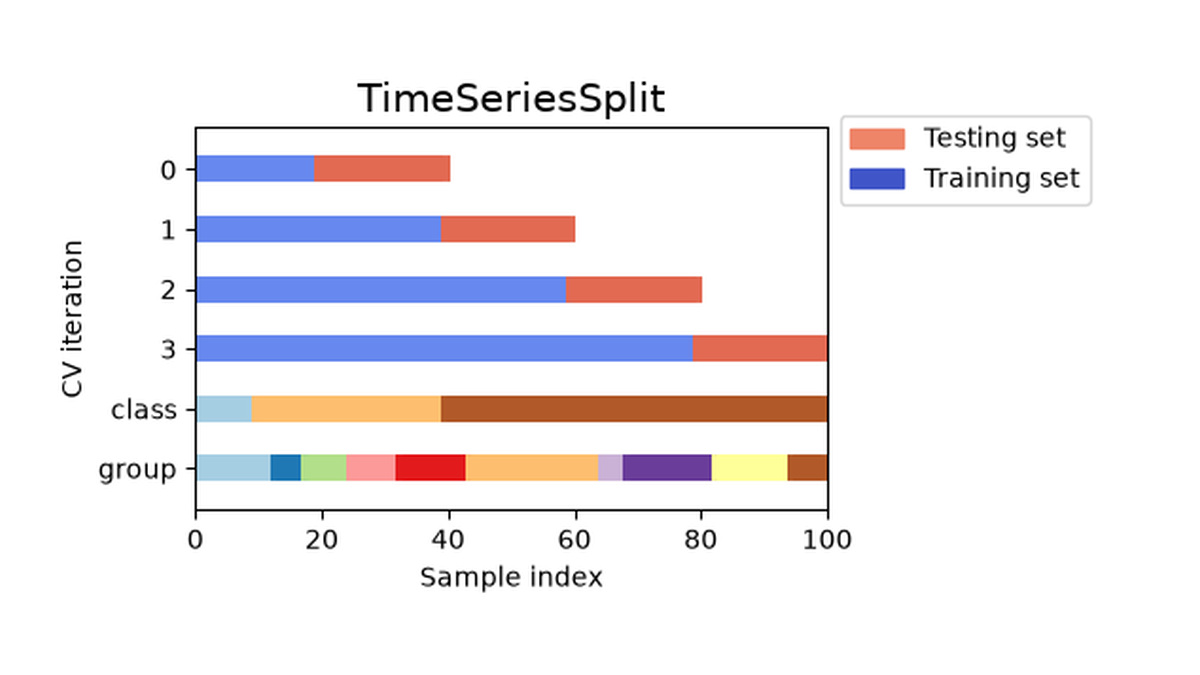
用訂單、顧客群組與時間情境拆解訓練、驗證、測試和交叉驗證,對照KFold、分層、群組與時間切分原圖,理解前處理、重複樣本與未來資訊如何造成資料洩漏。
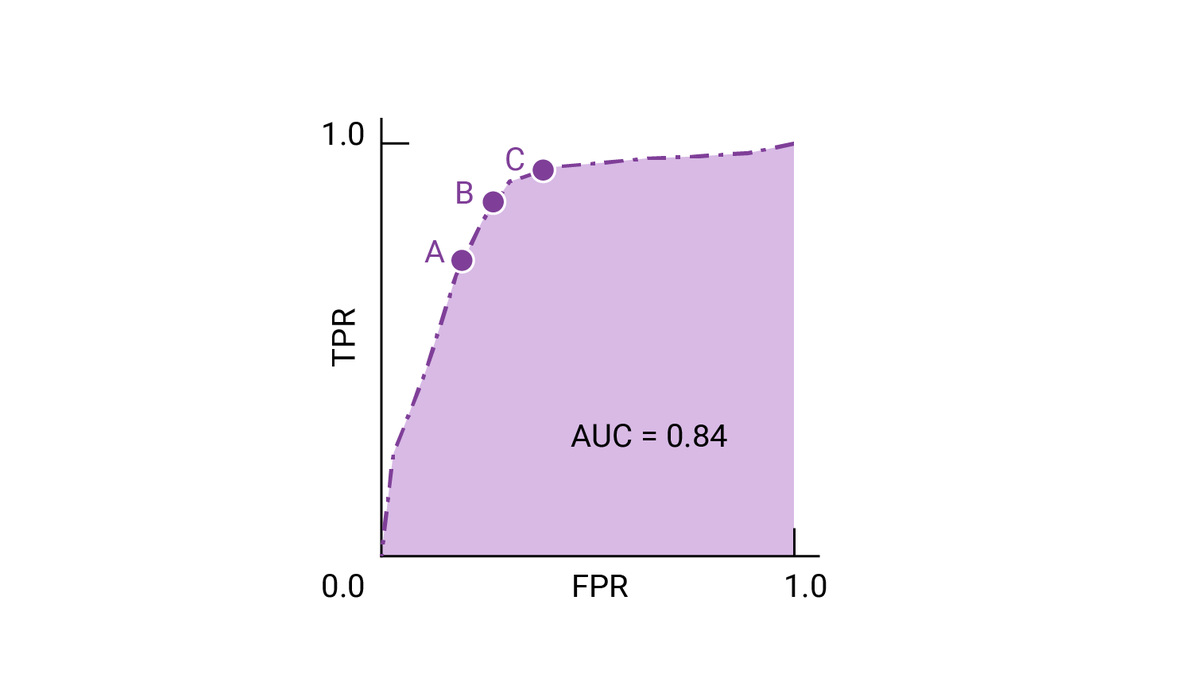
從延遲預警教學數表拆解混淆矩陣、Accuracy、Precision、Recall、FPR與F1,再對照原圖理解閾值、ROC-AUC、PR曲線與AP的分母、用途及限制。
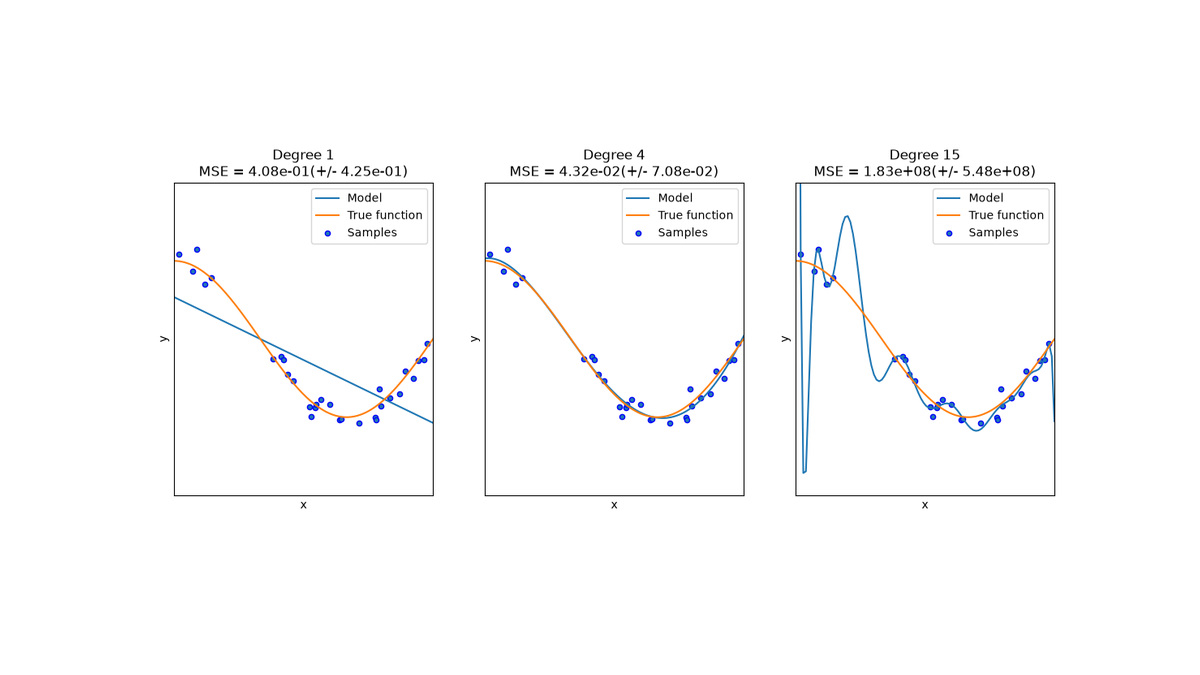
用可手算的配送基準開始,理解公平比較、交叉驗證、欠擬合與過擬合、偏差變異、驗證與學習曲線,再從類別及子群誤差找出模型改善方向。
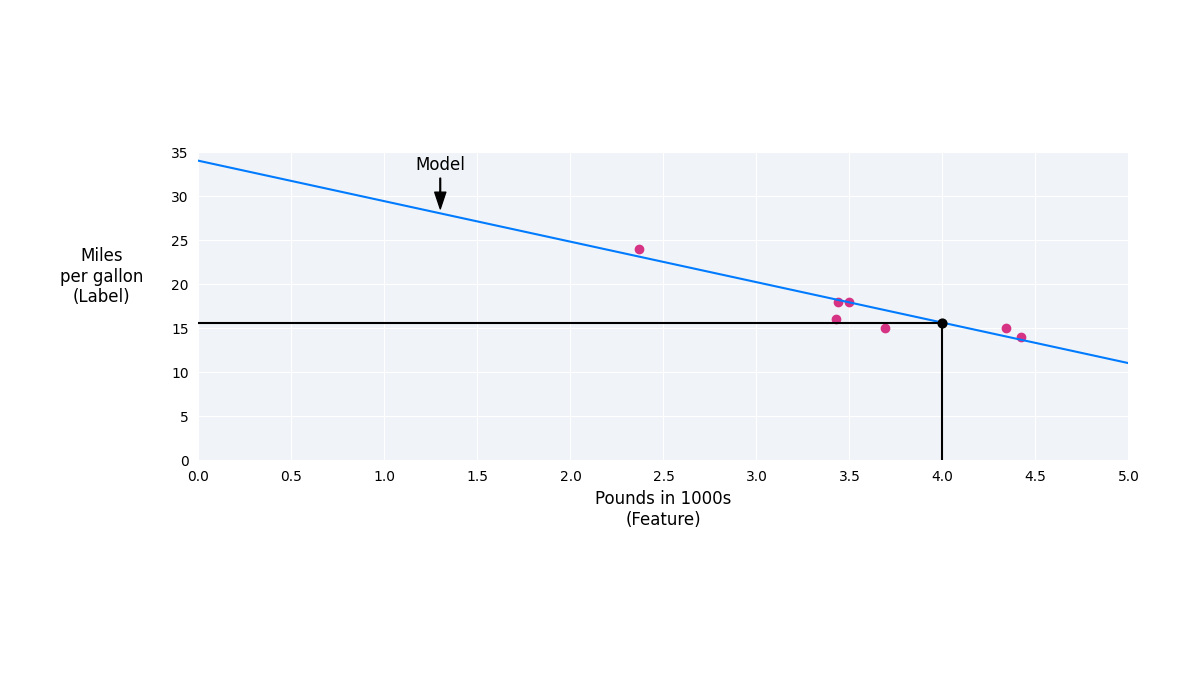
用三筆可手算的配送教學資料理解線性迴歸、斜率截距、殘差、MAE與MSE,再以NumPy最小平方法核對,對照原圖拆解多特徵、梯度下降、收斂與泛化限制。
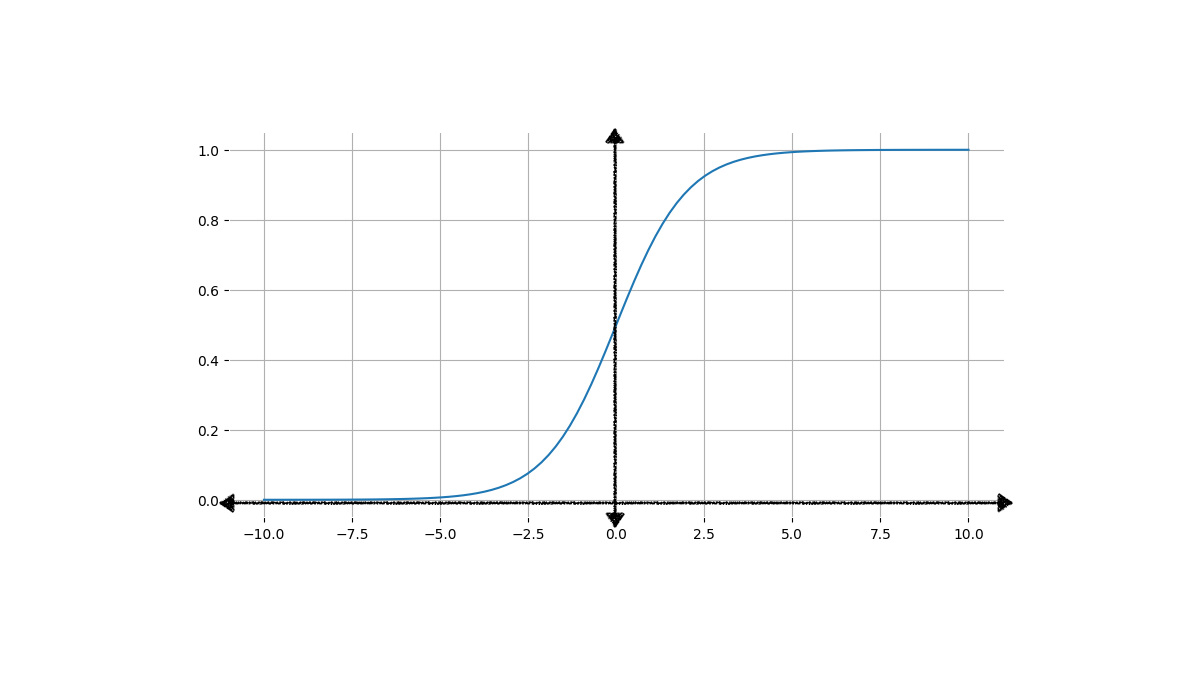
用距離與延遲的教學算例拆解羅吉斯迴歸:線性log-odds、sigmoid、odds ratio、二元交叉熵與最大概似,再以原圖理解閾值、排名與機率校準的不同。
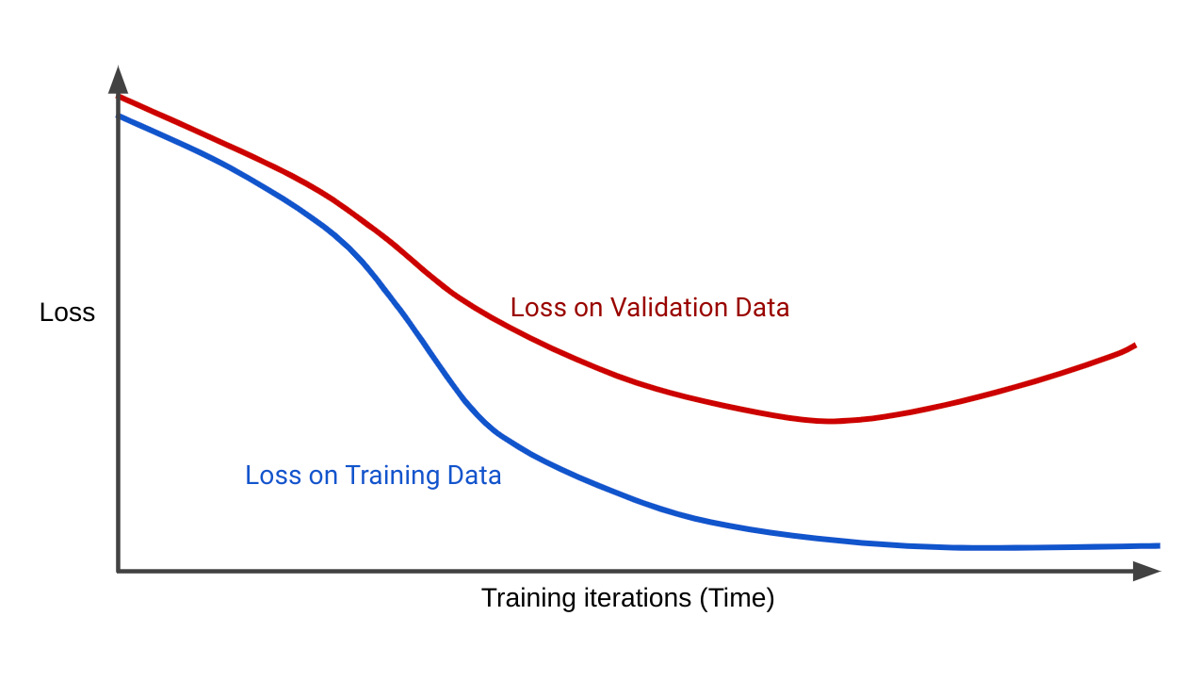
以原始教學圖與可手算的單係數範例,拆解過擬合、L1/L2、Ridge、Lasso與Elastic Net,理解為什麼縮放、資料切分與驗證比把權重變小更重要。
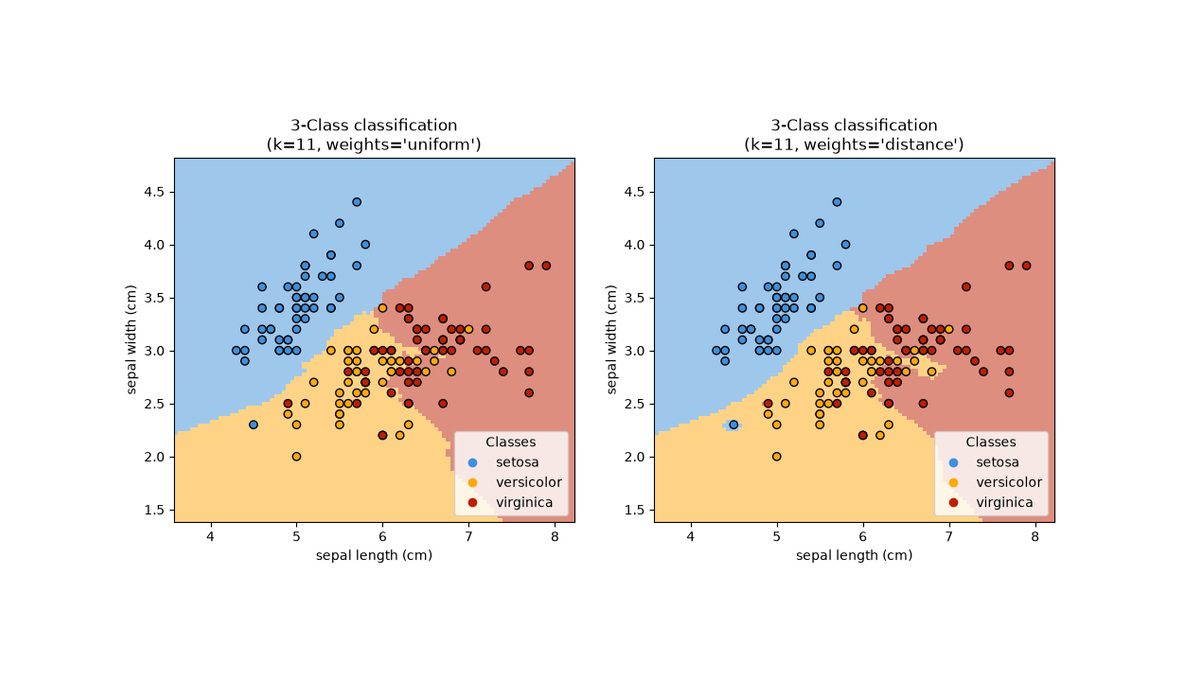
用可手算的三鄰居範例拆解KNN分類與迴歸,對照官方原圖理解距離加權、標準化與NCA,再檢查高維資料、預測成本、機率與資料洩漏。
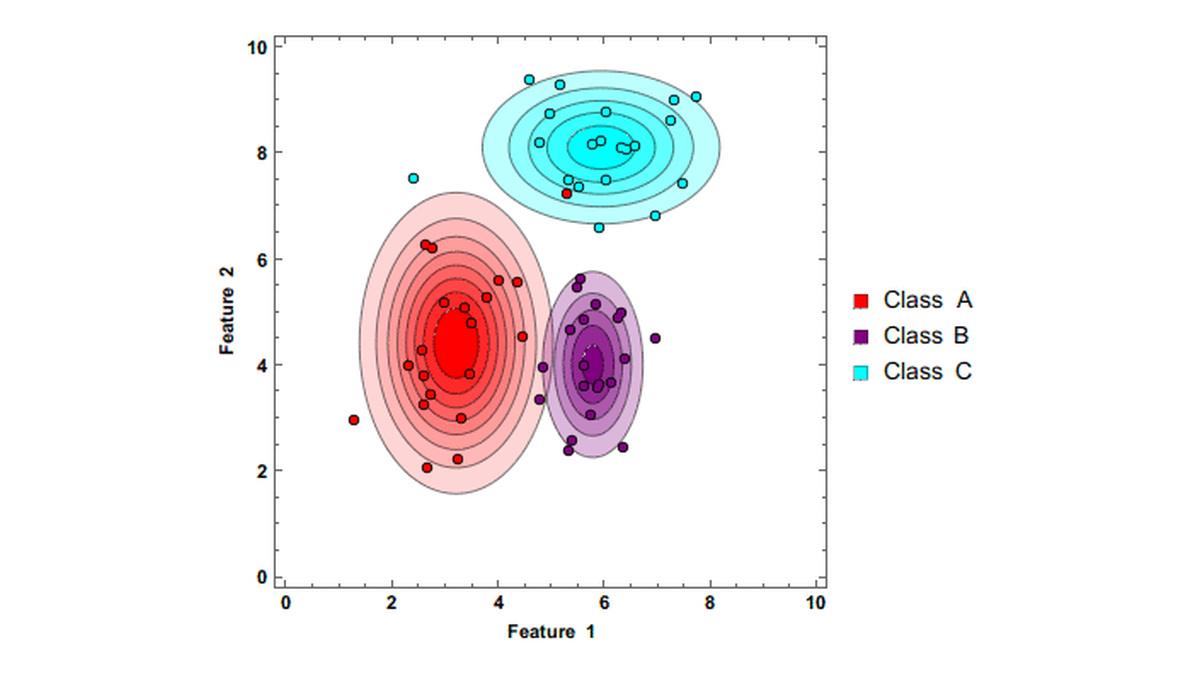
用自訂十封郵件算出Bernoulli Naive Bayes,再對照原始動畫拆圖與GaussianNB校準圖,理解條件獨立、先驗、平滑、log分數與不同資料分布的取捨。
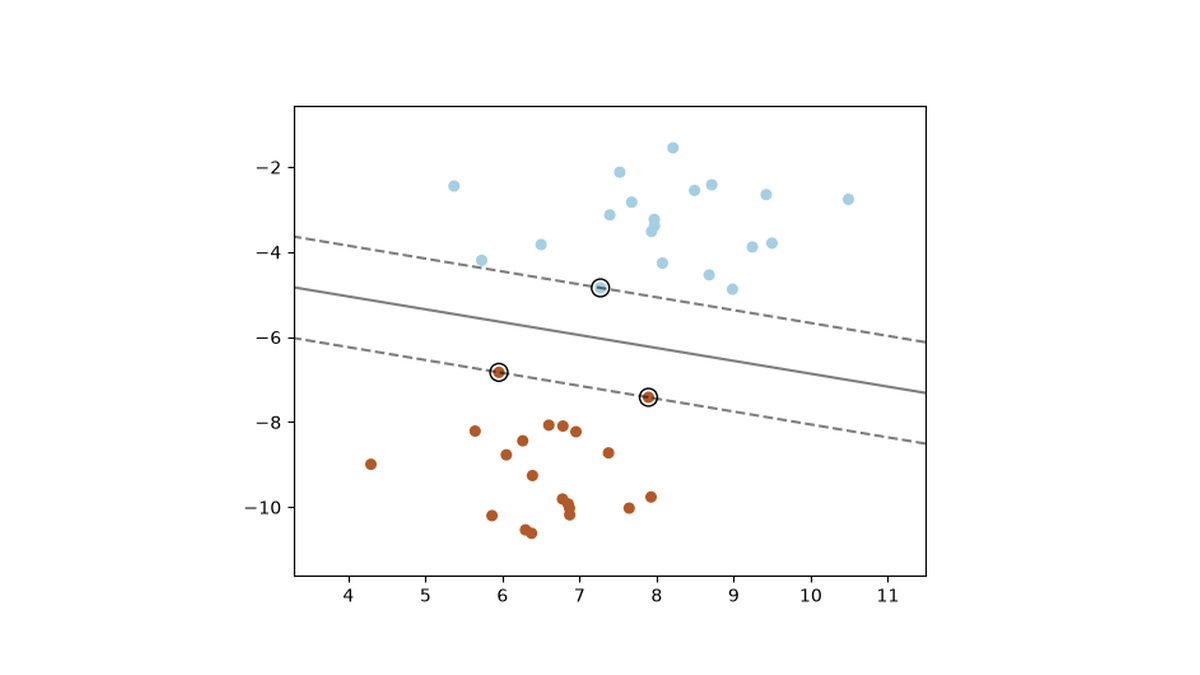
用四個可手算的點拆解SVM間隔、hinge loss與C,再對照官方原圖理解線性、多項式、RBF與sigmoid核,檢查gamma、縮放、驗證與計算成本。
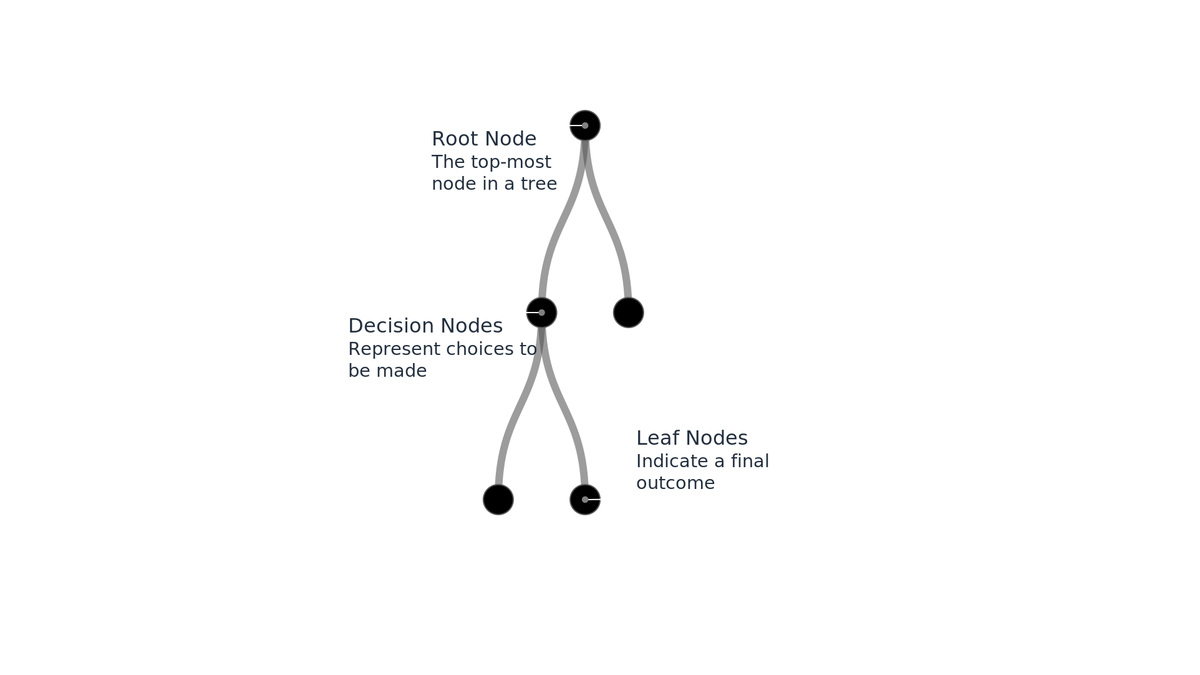
用六筆可手算資料拆解決策樹如何比較切點,對照原圖理解資訊增益、分類與迴歸、貪婪搜尋及剪枝,並檢查來源熵圖的bits與nats差別。
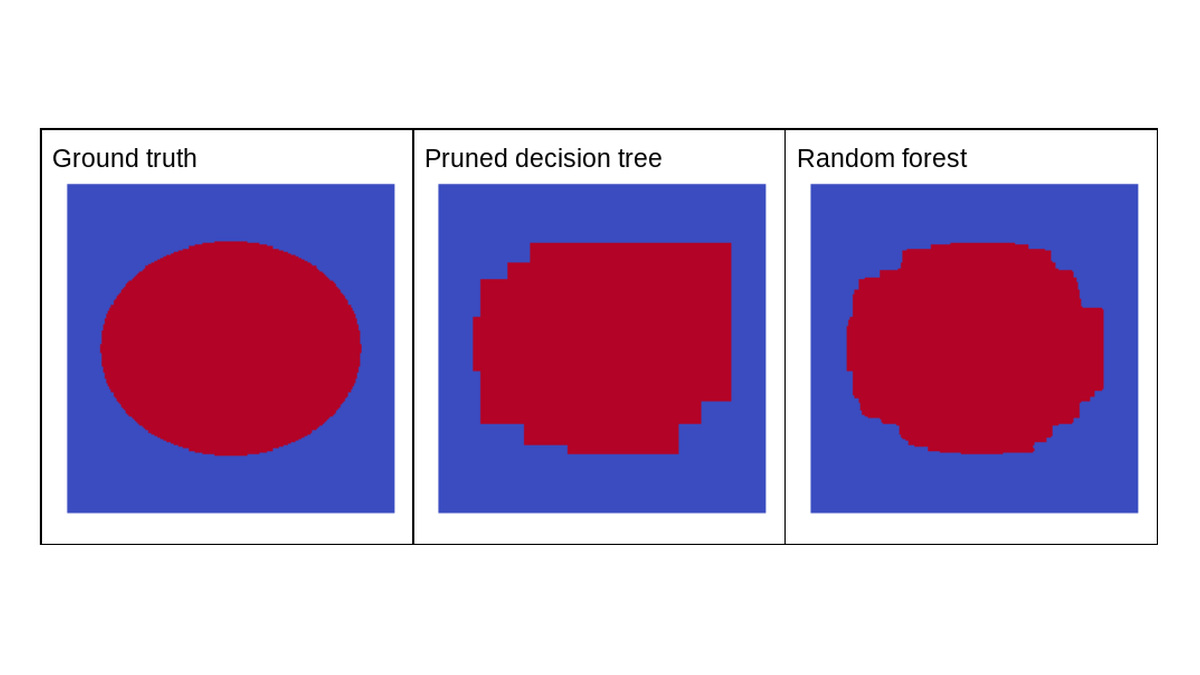
拆解Random Forest的資料重抽樣、逐節點特徵抽樣與預測聚合,對照七組原圖理解變異與OOB,再以實際執行的Iris小範例檢查訓練、OOB及測試結果。
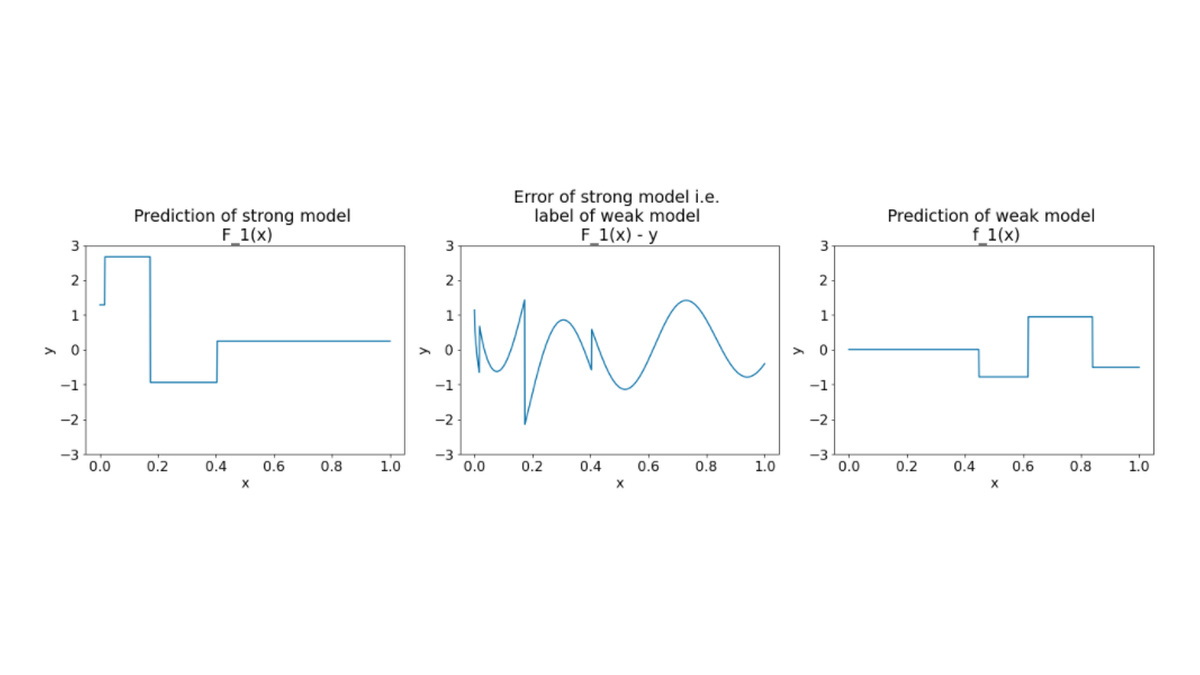
以六筆資料實跑兩輪殘差小樹,對照原圖拆解Gradient Boosting的梯度、符號與學習率,再手算AdaBoost樣本權重,理解輪數、過擬合與驗證。
沿Boosting原理拆解XGBoost的梯度、Hessian、正則化葉分數與切分增益,再以XGBoost 2.1.0實跑合成表格迴歸,分清驗證early stopping與最終測試。