
同樣拿到一張訂單表,你可能想知道三件事:上週為什麼比較晚送到、下一張訂單會送多久,以及哪些顧客的購買習慣相近。
它們都在用資料,但需要的答案不同。第一題要整理與比較已發生的事情;第二題要對還沒看到的結果做預測;第三題要從資料裡找結構。若再加上一題「幫顧客寫一封配送通知」,就連輸出的形式也變了。
學資料科學的起點,是先把這些問題分開。否則工具還沒裝好,就已經在比較不適合放在一起的技術。
這篇先建立一張讀懂後續文章的地圖:哪些名詞是範圍、哪些是方法,模型怎麼從資料學習,以及遇到具體需求時,應該先問哪幾個問題。
AI、機器學習與深度學習,是不同大小的範圍
AI,也就是人工智慧,是一個很大的研究與應用範圍,包含讓系統進行辨識、推理、規劃與生成等工作的方法。其中有些方法依賴人寫好的知識或規則,有些則會從資料學習。
機器學習是 AI 中從資料學習規律的一群方法;深度學習又是機器學習中,以多層神經網路學習表示與完成任務的一支。 深度學習並沒有離開機器學習,也不代表其他方法過時。
那資料科學放在哪裡?這個系列把它當成一套圍繞資料工作的實務:定義問題、確認資料如何取得、整理資料、分析與建模,再把結果轉成能檢查的判斷。它會使用統計、程式設計和領域知識,也可能使用機器學習。
例如,你發現配送變慢,是因為報表把「付款到出貨」和「出貨到簽收」混在同一欄。把時間定義拆清楚,再按倉庫比較,可能已經能解決問題。這項工作有資料科學的價值,即使完全沒有訓練神經網路。
| 名詞 | 先用這個問題理解 | 配送情境中的例子 |
|---|---|---|
| 資料科學 | 如何用資料回答一個可檢查的問題? | 找出延遲集中在哪些時段、倉庫或訂單條件 |
| AI | 系統要完成哪一種辨識、推理或生成工作? | 辨識包裹照片,或產生配送說明 |
| 機器學習 | 能否從過去資料學出對新案例有用的規律? | 用歷史訂單預測新訂單的配送時間 |
| 深度學習 | 是否以多層神經網路學習表示和任務? | 從包裹影像學習瑕疵特徵 |
這張表是比較工作的切入點,不是互斥分類。一個包裹影像專案,可以同時是資料科學專案、AI 應用、機器學習與深度學習系統。
同一張資料表,問法不同,學習任務就不同
假設我們在訂單建立時,知道配送距離、品項數、下單時段與倉庫。等訂單完成後,還會知道實際配送時間。
先問「模型要交出什麼」:
| 想回答的問題 | 預期輸出 | 常見任務 |
|---|---|---|
| 這張訂單大約幾分鐘送到? | 一個連續數值,例如 35 分鐘 | 回歸(regression) |
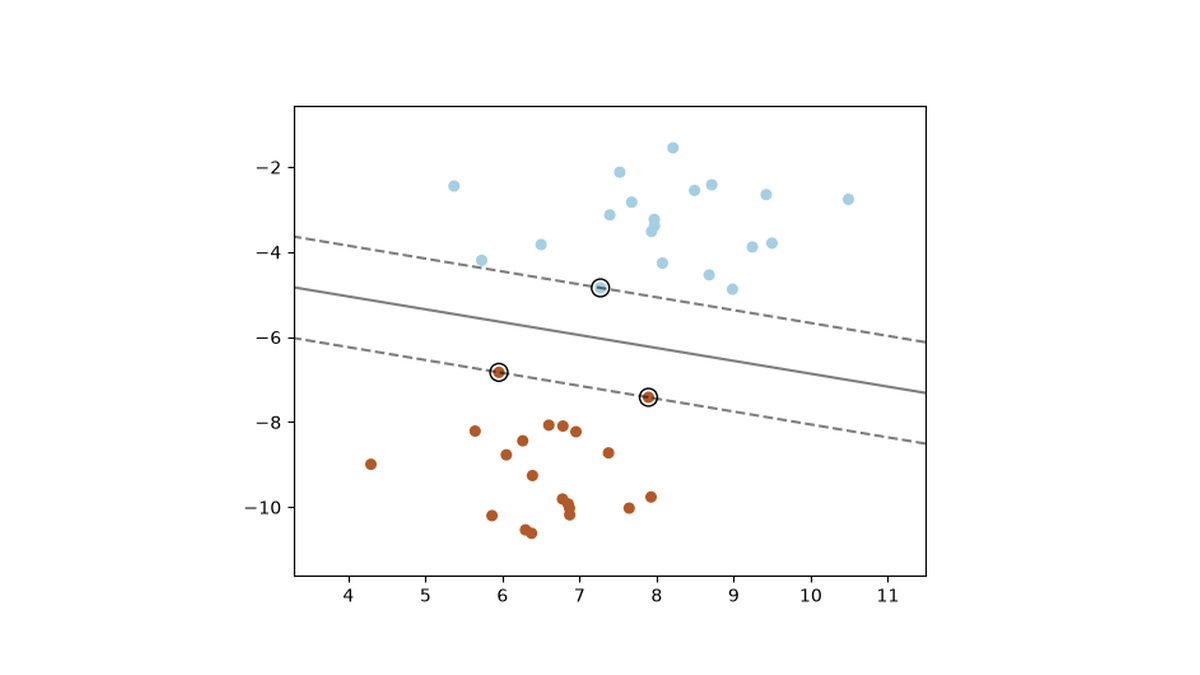
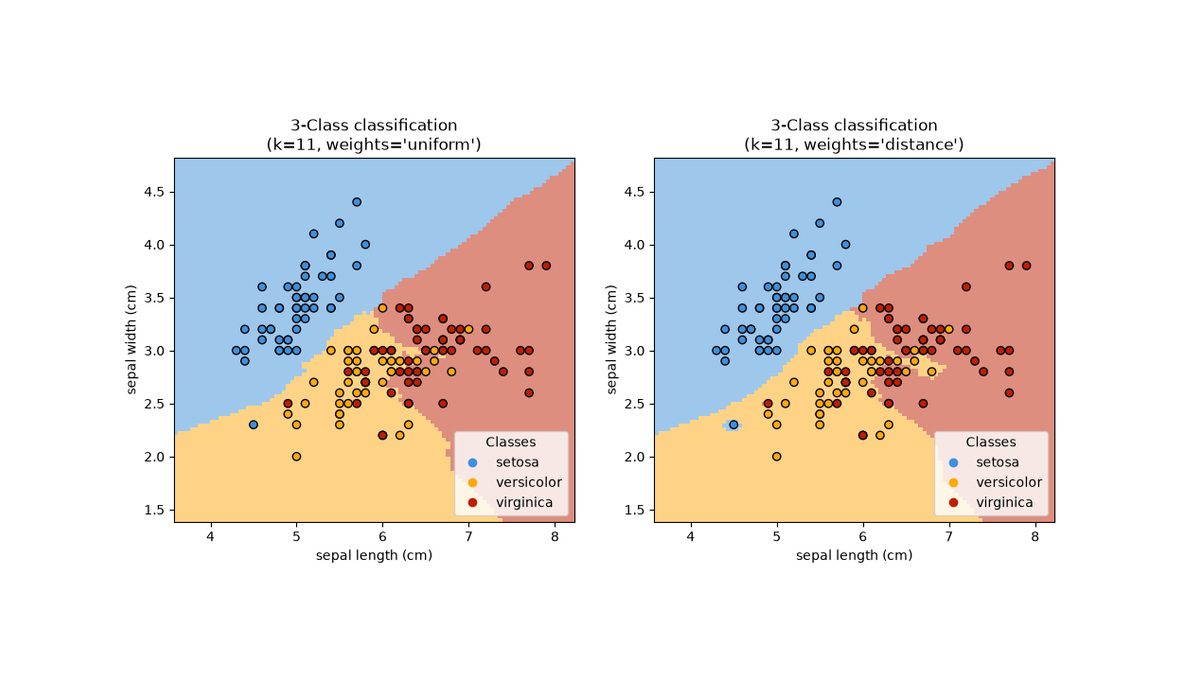
| 這張訂單會不會超過約定時間? | 類別,或對類別的分數/機率估計 | 分類(classification) |
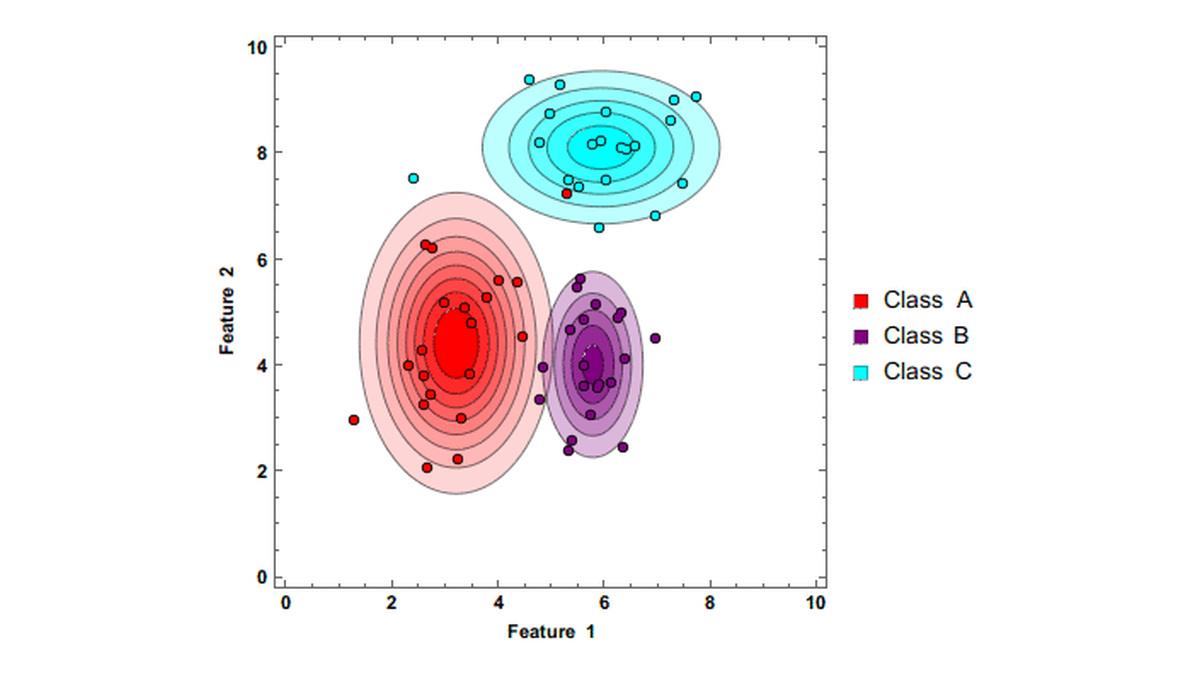
| 哪些訂單或顧客的行為相近? | 一組依相似性得到的分群 | 分群(clustering) |
| 怎麼把配送狀態寫成通知? | 一段新文字 | 生成(generation) |
分類模型可以輸出數字,例如延遲分數 0.7;因此不能只看「輸出是不是數字」來區分分類與回歸。要看這個數字代表的是時間、金額等量,還是某個類別的分數。分數能否解讀成可靠機率,還要另外檢查。
生成與分類也不是互斥的技術陣營:同一個語言模型可以產生通知,也可以依提示輸出分類結果。但兩者的任務與驗收標準仍不同。通知要檢查事實、語意與遺漏;延遲預警要檢查漏報、誤報,以及採取行動的成本。
監督式學習:把「題目」和「已知結果」分開
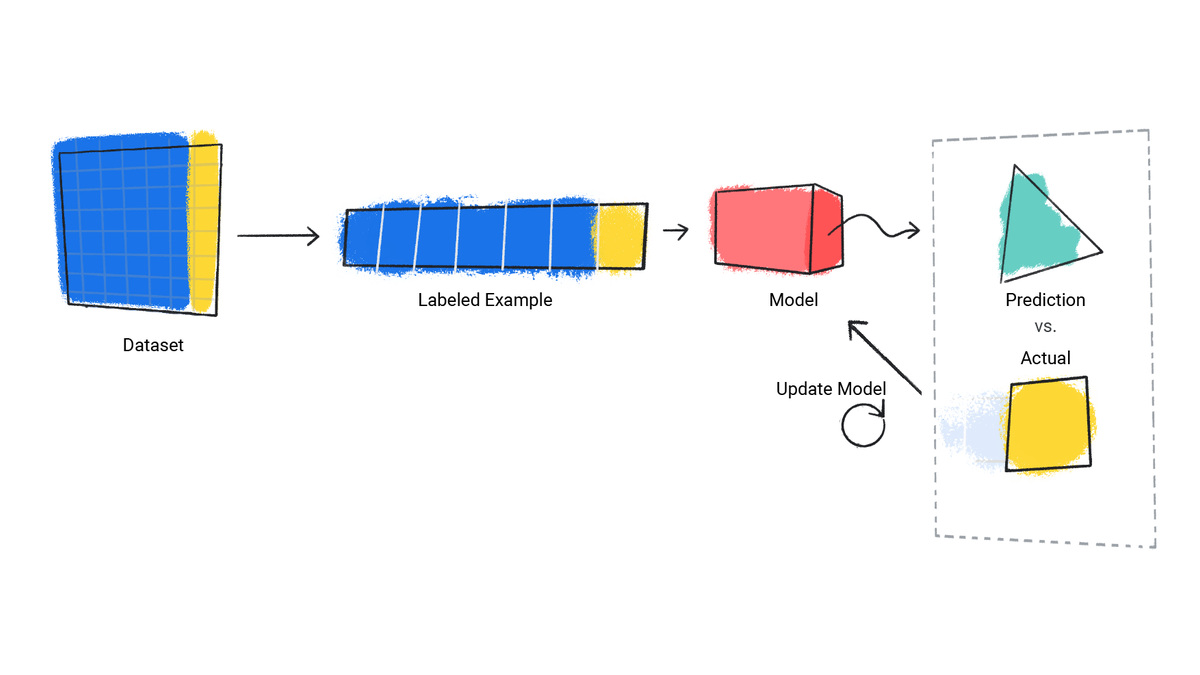
預測配送時間時,每一張歷史訂單是一個樣本(example)。模型在預測當下能使用的欄位,叫特徵(features);希望預測的結果,叫標籤(label)。
在這裡,特徵可以是距離和下單時段,標籤則是完成後才知道的配送分鐘數。這是監督式學習的典型起點:過去的樣本帶有結果,讓模型學習輸入與結果之間的關係。Google 的監督式學習教材以天氣資料示範同一個分工。
新訂單剛建立時,配送結果還沒發生。這時資料有特徵,卻沒有可供模型讀取的真實標籤。
這裡有一個比選模型更早的檢查:這個欄位在實際預測時,真的已經存在嗎? 如果拿「簽收時間」去預測配送時間,離線成績可能很好,使用時卻拿不到這個欄位。模型等於在練習時偷看答案。第 08 篇會專門拆解這種資料洩漏。
模型怎麼學?把預測、誤差與更新拆開看
模型不是把整張表變成一團神祕的智慧。可以先把它想成一個帶有可調設定的函數:輸入特徵,產生預測。
在一個簡化的回歸例子中,模型先用目前的參數估出時間,再把估計值和真正的配送時間比較。兩者差多少、什麼錯誤要罰比較重,交給損失函數(loss function)定義。
假設某張歷史訂單實際花了 40 分鐘,模型猜 25 分鐘。這筆資料會對訓練提供「估得太短」的訊息;學習演算法再依整體目標決定怎麼調整。不能只把這張訂單修到完全正確,卻讓其他訂單的預測全面變差。
接著,模型會接觸更多訓練樣本。有些方法透過梯度調整參數;決策樹則學習在哪個欄位、哪個條件下分割資料。它們都能從資料建立規律,但內部操作不同。
訓練分數很好,為什麼還不能說模型有效?
因為目標是預測未來的新訂單,不是背熟昨天的表格。
評估時,先把一批沒有拿來訓練的資料留下來。模型只看這批資料的特徵,做完預測後,評估程式才拿真實標籤計算誤差。模型的參數不應在這個測試步驟中,依測試標籤繼續調整。
配送資料還多一個時間問題:要模擬「用過去預測未來」,常需要按時間切分,而不是把不同日期隨機混在一起。真正的驗證方式要對應使用情境。資料切分、交叉驗證與誤差分析會在後面分篇處理。
現在先記住兩個詞:訓練(training)是在學規律;推論(inference)是用學好的模型處理新輸入。能做出推論,與推論有沒有用,是兩個需要分別驗證的問題。
沒有標籤,也能找規律;但群集不會自己告訴你意義
假設手上只有顧客的購買次數、平均訂單金額與商品類別,沒有「這個人屬於哪一群」的標準答案。你仍可以依選定的特徵和距離,把相近的資料放在一起。
得到三群之後,還要回頭看:是哪些特徵讓它們分開?換一種縮放或相似性定義,結果會不會大幅改變?群集是否有助於原本的決策?
如果你把群集 1 命名為「高價值顧客」,那是後續詮釋,不是演算法已經證明的事實。這也是無監督式學習和預先定義類別的分類任務,很容易混淆的地方。
至於「今天要派哪台車,才能讓長期總延遲最少」,又涉及行動如何影響後續狀態和回饋,可能需要排程最佳化、模擬或強化學習等方法。它也不是多加一欄標籤,就自然變成普通分類問題。
要開始一個資料科學題目,先寫下這四句話
在比較線性模型、樹模型或神經網路之前,先把需求寫成能被檢查的形式:
- 我要在什麼時候,對哪一個對象做判斷? 例如:訂單建立時,估計這張訂單的配送分鐘數。
- 那個時間點能取得哪些資料? 距離和倉庫也許已知,簽收時間還不知道。
- 什麼結果算有幫助? 例如,比「一律猜過去典型時間」的簡單基準更準;還要觀察尖峰時段是否特別失準。
- 哪些錯誤最不能接受? 提早通知和延後通知的成本,可能很不相同。
這四句話寫得出來,接下來才知道要整理什麼資料、拿哪個方法當基準,以及怎麼判定改進。
這個系列會從表格資料與經典機器學習出發,走到神經網路、電腦視覺、注意力與語言模型,再談生成模型和實務應用。這是一條理解技術的閱讀路徑;早期方法並不因新模型出現,就失去使用與比較的價值。
下一篇〈先讀懂資料:Python、NumPy 與 pandas 的最小工具箱〉,我們會真的打開一份小訂單表,先把資料的列、欄、型態與維度看清楚。
來源與延伸閱讀
- Google,What is Machine Learning?:任務分類與分群原圖。
- Google,Supervised Learning:樣本、特徵、標籤、訓練、評估與推論原圖。
- Wikimedia Commons,AI-ML-DL.svg:包含關係原圖,依CC BY-SA 4.0再利用。
- Google教材原圖依CC BY 4.0再利用,見Google網站政策。手機版為原圖局部裁切,沒有改寫原圖數值。
本文的訂單情境與任務比較為教學設例,未使用企業資料,也未宣稱已訓練配送模型。
封面沿用本篇已註明來源的配圖,僅等比縮放並加白邊以保留全圖;圖片原有的署名與授權條件同樣適用於封面版本。
留言0
登入後就能留言。
登入