
看到一封郵件包含「優惠」和連結,就能判定它是垃圾郵件嗎?先別急著把某個字當成證據:要看這個特徵在不同類別各有多常見,也要看類別原本的比例。
Naive Bayes把這件事做得很明確。它先估計每個類別的先驗比例,再把特徵在該類別下的條件機率組合起來。它的簡化是假設:知道類別後,特徵彼此條件獨立。這個假設常不完全符合真實資料,但可以把原本很難估的聯合分布拆成較容易估計的部分。
這篇會手算一個十封郵件的例子,分清未正規化分數與後驗機率,再用原圖看資料累積與機率校準。這是理解分類器的教學,不是可直接拿來封鎖真實郵件的系統。
先把機率的分母分清楚
「垃圾郵件裡有多少包含優惠」與「包含優惠的郵件裡有多少是垃圾郵件」,分母不同,數字通常也不同。條件機率的圖可以先幫我們看這件事。
圖1|這是一般事件示意,不是本篇郵件資料。P(A∩B₂)=0.12,P(B₂)=0.16,P(A)=0.52;因此P(A|B₂)=0.75,但P(B₂|A)約0.2308。相同交集除以不同的條件事件,結果不同。來源:Gnathan87,Conditional probability,Wikimedia Commons,CC0,原SVG未改。
在分類裡,我們想問的是:看到輸入x之後,各類別c有多可能?貝氏定理把它寫成:
P(c | x) = P(c) × P(x | c) / P(x)

P(c):看到這筆輸入之前的類別先驗
P(x | c):假定類別為c,這組特徵出現的可能性
P(c | x):觀察輸入後的類別後驗
對同一筆x比較類別時,分母P(x)相同,所以只比較分子就能選類別。若要給各類別總和為1的機率,則需要再正規化,不能直接把分子叫機率。
Naive這個字,指的是哪個假設
假設有兩個特徵x₁、x₂。一般情況下,要估計它們在每類別內的聯合分布P(x₁,x₂|c)。Naive Bayes改用:
P(x₁, x₂ | c) ≈ P(x₁ | c) × P(x₂ | c)

類別分數s_c = P(c) × ΠⱼP(xⱼ | c)
預測類別 = 分數最大的類別
模型後驗 = s_c / Σₖs_k
這是假設在固定類別後,特徵可以分開處理;不是宣稱所有郵件裡的所有字都互不相關。例如,即使在垃圾郵件中,「限時」與「優惠」仍可能一起出現,便違反這個條件獨立的簡化。
簡化讓資料需求下降:我們可以分別估計每個特徵在各類別中的行為,不必為所有特徵組合存一張龐大的表。但如果多個特徵其實重複表達同一個訊號,相乘就可能重複計入證據,讓機率過於接近0或1。
分類仍可能有用,原因是「哪一類分數較大」與「分數是否對應可靠機率」是不同要求。這不保證Naive Bayes一定適合你的資料,仍要比較獨立驗證結果。
用十封自訂郵件算一次
先做一個Bernoulli Naive Bayes:每個特徵只有有/沒有。x₁表示是否包含「優惠」,x₂表示是否有連結。
以下全部為本站自訂教學資料。相同特徵組合可以有多封郵件;不是觀察真實使用者的郵件。
- (1,1)四封、(1,0)一封、(0,0)一封
- 6
- 5
- 4
- (1,1)一封、(0,1)一封、(0,0)兩封
- 4
- 1
- 2
用訓練類別比例估先驗:P(S)=0.6、P(N)=0.4。直接估x₁在垃圾類的出現比例會是5/6;但若某個特徵從沒在一類出現,相乘時就會把該類分數歸零。
本例採每個二元結果各加1的Laplace平滑:
P(xⱼ=1 | c) = (該類含此特徵的封數 + 1) / (該類郵件數 + 2)
P(xⱼ=0 | c) = 1 − P(xⱼ=1 | c)
分母加2,因為二元特徵有0和1兩種結果,各加一次。這裡只平滑特徵條件機率,類別先驗仍用原本6/10與4/10。
| 條件 | 垃圾S | 正常N |
|---|---|---|
| P(x₁=1|類別) | 6/8=0.75 | 2/6≈0.3333 |
| P(x₂=1|類別) | 5/8=0.625 | 3/6=0.5 |
| P(x₂=0|類別) | 3/8=0.375 | 3/6=0.5 |
現在新郵件「有優惠、沒有連結」,即x=(1,0):
s_S = 0.6 × 0.75 × 0.375 = 0.16875
s_N = 0.4 × (1/3) × 0.5 ≈ 0.0666667

P_model(S | x) = s_S / (s_S+s_N) = 81/113 ≈ 0.716814
分數選垃圾類。模型後驗約0.7168,是在這份訓練資料、平滑與獨立假設下的結果;不是「這封郵件有71.68%已被證實是垃圾」。若要依此自動刪信,還要驗證誤刪正常信的代價、機率品質與適合的決策閾值。
原始動畫拆成四步:更多資料改變哪些估計
Jacopo Bertolotti的原始動畫用三類、兩個連續特徵,展示資料逐筆累積後模型形狀的改變。我們取四個原始幀,而不是重畫曲線。
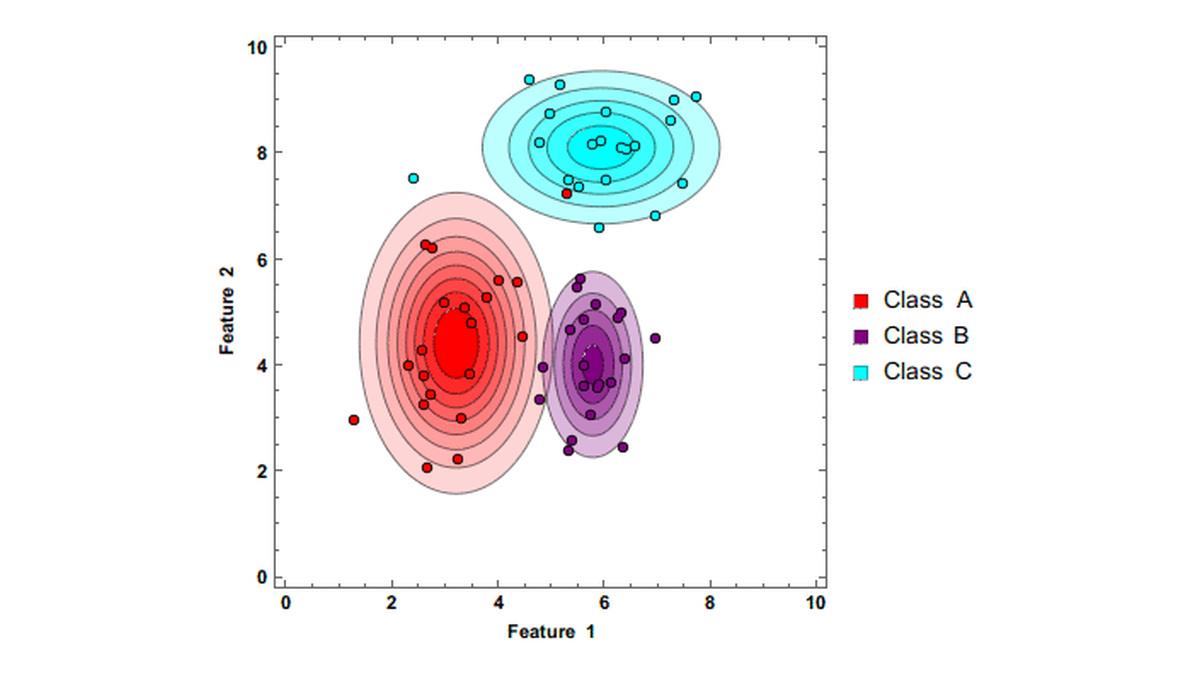
這組圖採Gaussian Naive Bayes的形式:每個類別的每一維以高斯密度估計,再把兩個維度的密度與類別比例相乘。紅色A、紫色B、青色C代表來源的三類;它們不是前面的垃圾與正常郵件。
圖2|取原GIF第10幀,代表累積10筆來源模擬觀測後;少量樣本下,中心與寬度容易受現有點的位置影響。色塊是類別先驗乘兩維密度的等高線,尚未除以所有類別分數總和;不是已正規化的類別後驗。來源:Jacopo Bertolotti,Naive Bayes Classifier,CC0,直接取幀轉PNG。
圖3|第20幀,新增點後重新估每類的比例、各維平均與變異。形狀改變不表示模型一定更準,圖中沒有獨立測試成效。來源與未正規化密度等高線定義同圖2。
圖4|第40幀,讓讀者比較同一組來源資料累積過程,而不是比較四種不同演算法。橢圓形等高線不是參數的信賴區間。來源與分數定義同圖2。
圖5|第60幀,完整來源共有三類、各20點。來源生成的A類本身含特徵相關性,分類器仍將兩個邊際密度相乘,因此不能拿這張圖證明真實資料條件獨立。來源與分數定義同圖2。
在這個Gaussian模型中,每類的每個特徵有自己的平均與變異;不是所有類別共用同一個高斯,也不要求整批資料混合後仍是常態。對連續值使用的是密度,精確某個實數的機率不是把密度值直接當成事件機率。
這段動畫依資料重估參數,與「給定一筆新輸入,計算類別後驗」又是兩個不同層次。它沒有展示參數的完整貝氏後驗抽樣;不要因為名稱含Bayes,就替動畫加上它沒有做的推論。
同一名稱,資料型態要選對
| 常見變體 | 特徵怎麼表示 | 要留意什麼 |
|---|---|---|
| Bernoulli NB | 各特徵是否出現,值為0或1 | 不出現也提供資訊;本篇郵件例屬此類 |
| Multinomial NB | 詞彙等事件的非負計數 | 重複次數會改變分數,分母依類別的總詞數與詞彙量計算 |
| Gaussian NB | 每類、每特徵的連續值密度 | 高斯形狀與條件獨立可能不合,近零變異也需要處理 |
Multinomial常搭配文字計數,也有人用非負TF-IDF權重;後者不能再照字面解釋為純粹「抽了幾次字」。不要先把數值標準化成可能含負數的表示,再直接餵給要求非負輸入的模型。
平滑的分母也不能混用。Bernoulli針對「每封是否出現」,本例是類別封數加2;Multinomial針對詞彙計數,常見做法是該類總詞數加α乘詞彙量。兩者不是把同一個表格改一個名稱。
實務上,斷詞、詞彙表、文件頻率與任何用標籤選特徵的步驟都只能在訓練折擬合。資料切分要保留同來源重複郵件、時間與使用者群組等結構,不能讓幾乎一樣的郵件同時出現在兩邊。
分得開,不代表機率說得準
先看scikit-learn官方的另一組合成資料。它有三個空間群集,卻只有兩個類別;中間群集約一半正類、一半負類。
圖6|來源產生50,000點、保留90%作測試,這張畫的是剩餘訓練點;點大小由來源的樣本權重決定。紫色是類別0、紅色是類別1;三個群集不等於三個分類標籤。來源:scikit-learn developers,Probability calibration of classifiers,BSD 3-Clause,原圖未改。
兩類各包含不同群集,單一GaussianNB的類別條件分布未必能吻合。原頁比較未校準、sigmoid與isotonic後處理,並用保留資料算加權Brier loss。
圖7|橫軸是按未校準GNB機率排序的樣本索引,縱軸是P(y=1),不是常見可靠度圖的「平均預測機率」橫軸。黑線是分組後的實際正類比例;圖例0.104、0.084、0.109是來源加權Brier loss,越低越好,不是準確率或某點機率。來源同圖6,原圖未改。
這組來源結果中,isotonic在中間區域較接近0.5,且Brier loss較低;sigmoid反而沒有改善整體Brier loss。它說明校準方法也要驗證,不能推成isotonic在所有資料都最佳。Brier loss同時受機率校準與辨別能力等因素影響,也不能當成純校準誤差。
來源未校準基礎模型與校準流程還有訓練方式、折數及樣本權重處理差異,因此不是只改一個因素、用來保證方法增益的控制實驗。本篇引用它看機率行為,不把差值當作可保證的成效。基本GaussianNB並非一律不支援sample_weight;不要把原範例的一行歷史註解當作現行API定義。
自己的校準器必須用未參與對應基礎模型擬合的預測來訓練,並留下最終評估資料。較完整的概念可回看分類機率與校準。
用log把許多乘法改成加法
特徵多時,許多小數相乘可能讓浮點數下溢。比較類別可以改算:
log s_c = log P(c) + Σⱼlog P(xⱼ | c)
log單調遞增,因此分數排序不變。若要還原模型後驗,可先減去最大的log分數,再取exp並正規化,以避免直接對很大的負數取exp。
下面用標準函式庫重新計算本文郵件例。資料逐筆列出,先算類別比例與平滑條件機率,再用log計分。這不是重跑來源動畫或校準實驗。
from math import exp, log

training = [("S", 1, 1)] * 4 + [("S", 1, 0), ("S", 0, 0)]
training += [("N", 1, 1), ("N", 0, 1), ("N", 0, 0), ("N", 0, 0)]
query = (1, 0)
log_scores = {}
for label in ("S", "N"):
    rows = [row[1:] for row in training if row[0] == label]
    p_one = [(sum(row[j] for row in rows) + 1) / (len(rows) + 2)
             for j in range(2)]
    score = log(len(rows) / len(training))
    for present, p in zip(query, p_one):
        score += log(p if present else 1 - p)
    log_scores[label] = score
    print(label, "p_one:", [round(p, 6) for p in p_one],
          "score:", round(exp(score), 8))
anchor = max(log_scores.values())
weights = {label: exp(score - anchor) for label, score in log_scores.items()}
posterior = {label: value / sum(weights.values()) for label, value in weights.items()}
print("posterior:", {label: round(p, 6) for label, p in posterior.items()})
print("prediction:", max(log_scores, key=log_scores.get))
會得到S的分數0.16875、N約0.06666667,模型後驗S約0.716814、N約0.283186,選S。真正上線前,仍需要基準與誤差分析,尤其要查正常郵件被誤判的情況。
Naive Bayes值得學,因為它把「先驗、條件分布與分類規則」清楚分開。學會這三件事,才能辨識哪裡是資料提供的證據,哪裡是模型為了能算而做的假設。
來源與圖片授權
本文的十封郵件、平滑計算與log程式為本站自訂教學,未聲稱真實郵件測試或重跑來源實驗。
- scikit-learn:Naive Bayes,作變體、條件獨立與估計方法依據。
- Gnathan87:Conditional probability,圖1依CC0使用,原SVG未改。
- Jacopo Bertolotti:Naive Bayes Classifier,原作者以CC0公開;圖2–5為原GIF第10、20、40、60幀直接保存PNG,未重畫或改動點與座標。來源程式中的等高線是未正規化密度分數,不冒稱已是後驗。
- scikit-learn developers:Probability calibration of classifiers,圖6–7依BSD 3-Clause使用;完整聲明如下。
BSD 3-Clause License

Copyright (c) 2007-2026 The scikit-learn developers.
All rights reserved.

Redistribution and use in source and binary forms, with or without
modification, are permitted provided that the following conditions are met:

* Redistributions of source code must retain the above copyright notice, this
  list of conditions and the following disclaimer.

* Redistributions in binary form must reproduce the above copyright notice,
  this list of conditions and the following disclaimer in the documentation
  and/or other materials provided with the distribution.

* Neither the name of the copyright holder nor the names of its
  contributors may be used to endorse or promote products derived from
  this software without specific prior written permission.

THIS SOFTWARE IS PROVIDED BY THE COPYRIGHT HOLDERS AND CONTRIBUTORS "AS IS"
AND ANY EXPRESS OR IMPLIED WARRANTIES, INCLUDING, BUT NOT LIMITED TO, THE
IMPLIED WARRANTIES OF MERCHANTABILITY AND FITNESS FOR A PARTICULAR PURPOSE ARE
DISCLAIMED. IN NO EVENT SHALL THE COPYRIGHT HOLDER OR CONTRIBUTORS BE LIABLE
FOR ANY DIRECT, INDIRECT, INCIDENTAL, SPECIAL, EXEMPLARY, OR CONSEQUENTIAL
DAMAGES (INCLUDING, BUT NOT LIMITED TO, PROCUREMENT OF SUBSTITUTE GOODS OR
SERVICES; LOSS OF USE, DATA, OR PROFITS; OR BUSINESS INTERRUPTION) HOWEVER
CAUSED AND ON ANY THEORY OF LIABILITY, WHETHER IN CONTRACT, STRICT LIABILITY,
OR TORT (INCLUDING NEGLIGENCE OR OTHERWISE) ARISING IN ANY WAY OUT OF THE USE
OF THIS SOFTWARE, EVEN IF ADVISED OF THE POSSIBILITY OF SUCH DAMAGE.
封面沿用Jacopo Bertolotti原GIF的第60幀,僅等比縮放並加白邊保留全圖,依相同CC0條件使用。
留言0
登入後就能留言。
登入