
模型拿到新訂單,能不能做出可靠預測?要回答這個問題,不能只看它對已經學過的資料猜得多準。
更麻煩的是,你可能確實把資料分成兩份,分數仍然過度樂觀:同一個人的相近紀錄分到兩邊、填補平均值時先看過所有資料,或把訂單完成後才知道的資訊當成輸入。程式照樣能執行,評估卻已經失去原本要測的能力。
這篇先分清訓練、驗證與測試的用途,再沿著不同切分圖判斷:我們究竟在模擬哪一種「沒看過」?本文情境與表格都是教學設定,來源圖是原教材的示意與合成資料,不是本站模型實驗。
先問:上線時遇到的是哪一種新資料?
「新訂單」可能是熟客的下一筆訂單、新顧客的第一筆訂單,也可能是下個月、新城市或不同資料系統的訂單。它們不是同一種泛化問題。
如果服務一直在同一批顧客中運作,過去顧客資訊可能是合法輸入;若要證明能服務完全沒見過的新顧客,就不能讓同一顧客的其他紀錄提前出現在訓練裡。切分方式需要反映你想做出的能力主張。
因此,開始前先寫一句:「使用截至某時點可得的資訊,預測哪些對象、哪個未來結果。」這句話會決定切分單位、時間邊界與可用欄位。
訓練、驗證、測試,各自影響哪些決定?
訓練資料用來擬合模型參數;驗證資料用來比較方案,例如模型種類、特徵、超參數與停止時機;測試資料則保留到方案選定後,評估整套流程對新資料的表現。
資料多時,可以固定留出一份驗證集;資料較少時,也可以在開發資料內輪流切分做交叉驗證。核心是分工清楚,不是每個專案都必須建立三個同名檔案。
測試後若發現重大問題,當然可以修正;只是原測試結果已影響新版本,不能再把同一份資料當成完全未碰過的最終證據。應保留版本與變更紀錄,並在可行時用新的保留資料評估。
K-fold:輪流保留一折,不是每輪都訓練同一個模型
K-fold把開發資料分成K份。每一輪用其中一份評估,剩下的份數訓練;換到下一輪時,重新擬合模型與需要學習的前處理,再彙總各輪分數。
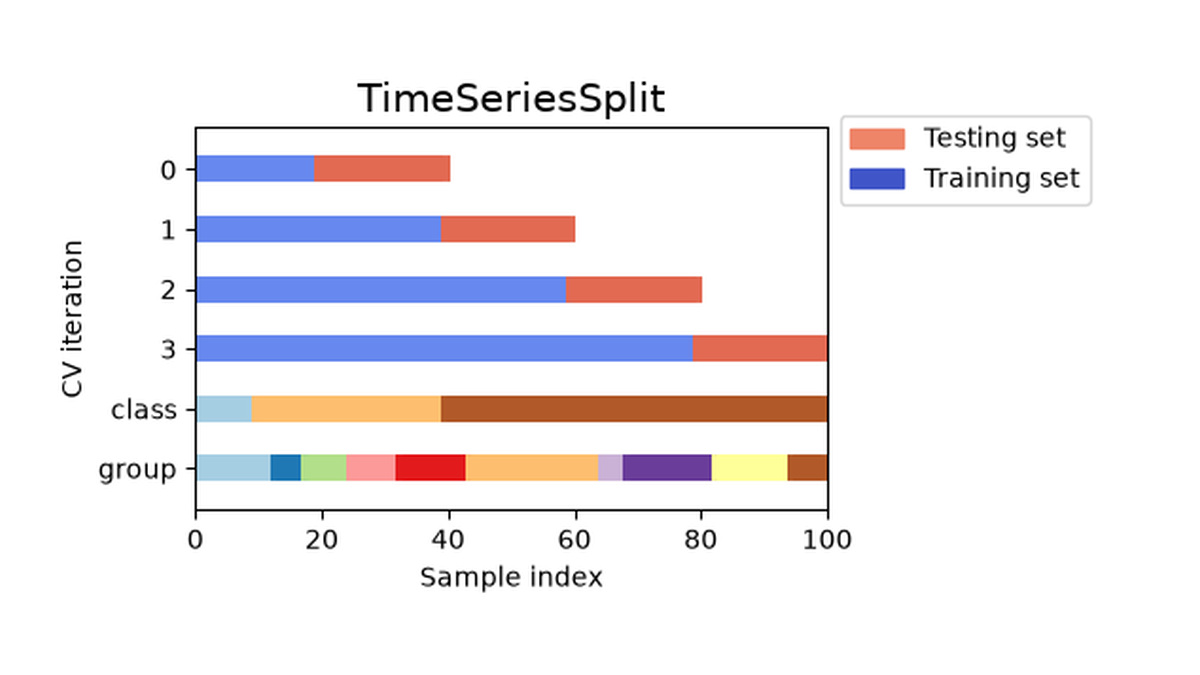
本篇CV圖例的「Testing set」是該輪保留折。當它用來調整模型時,功能上是驗證資料,不是最後獨立測試集。 套件或文章使用test這個字,不會自動替它建立獨立性。
KFold本身不會替你檢查時間與群組。打亂可以改變切分分布,但不能解決同一個人跨兩邊、重複樣本跨兩邊,或未來資訊回流的問題。
分層:顧到類別比例,仍沒有顧到人或時間
如果延遲訂單很少,任意切分可能讓某一折幾乎沒有延遲案例,指標難以比較。分層切分會嘗試在各折保留接近整體的類別比例。
分層不能創造少數類別樣本。若只有幾筆正例,分再多折也不會讓每折都有充足證據。它還可能讓不同折的比例更相似,因此折間分數較穩,不應把這種穩定當成所有實際情境的不確定性都變小。
群組切分:把同一個對象的相關紀錄留在同一邊
假設每位顧客各有兩筆資料:
| 顧客 | 訓練資料 | 保留評估資料 | 正在評估什麼? |
|---|---|---|---|
| A、B、C都跨兩邊 | 各自第一筆 | 各自第二筆 | 可能是已見顧客的另一筆紀錄;時間仍需另外確認 |
| A、B只在訓練,C只在保留 | A與B的全部紀錄 | C的全部紀錄 | 對未見過顧客的泛化 |
第二種問題需要以顧客為群組切分,不能單純按資料列隨機分配。醫療影像中的同一病人、感測資料中的同一設備、同一原圖裁出的多個片段,都有類似需求。
群組定義也需要對準使用情境。按顧客切分可以限制顧客重疊,卻不能保證不同顧客的紀錄沒有共同的促銷事件或時間相關性。若同時要模擬未見顧客與未來月份,就要一起處理兩種限制,而不是從幾個splitter中挑一個就算完成。
時間切分:先有過去,才有未來
預測下個月時,應模擬只能使用當時已知資訊。例如先用1–6月訓練、7月驗證、8月測試;這是切分角色示例,不是通用的月份比例。
使用時間切分前,要先按時間整理資料。資料不等間隔時,同樣筆數的測試折可能跨越不同長度的期間,不能只看折數就認為可比較。
還需要檢查標籤可得時間。若一筆訂單在6月底建立,配送結果到7月才完整可得,模擬6月底訓練時不能偷用這個答案。滾動統計、跨期視窗與延遲標籤可能需要額外間隔或排除重疊;單純排好日期不會自動解決。
也沒有哪個固定間隔能消除所有洩漏。應依特徵回看範圍、標籤觀察窗與真實更新節奏決定,再確認不同折之間到底共享了什麼。
三條常見洩漏路徑:答案、前處理與紀錄重疊
第一條是輸入帶到答案。例如下單時預測延遲,卻使用實際完成時間、最後退款狀態或事後產生的「配送異常已結案」欄。即使切分比例正確,資料也不符合預測時點。
第二條是前處理先看過保留資料。例如在所有資料上估計平均值、縮放參數、PCA方向或依標籤挑特徵,才切成訓練與測試。保留資料的分布或答案已影響輸入流程。
正確的順序是先切分,在該輪訓練資料上 fit,再對保留資料 transform。驗證、測試與上線套用的是同一組已擬合參數,不是每一份資料各自重新擬合。Pipeline可以固定這個順序,但不會替你修復錯誤時間欄位或群組。
第三條是同一筆、近似複本或高度相關片段分到兩邊。應依來源識別碼與業務定義處理,必要時把相關樣本當群組一起切;不要看到測試分數不好,才刪掉難題,也不要只因特徵值相同,就把不同的真實觀察當重複資料。
調整與最終評估要分開,交叉驗證也會被過度使用
試的方案越多,越可能挑中剛好適合目前驗證資料的設定。交叉驗證可以減少依賴某一次切分,不能讓無限次試驗都保持獨立。需要時可使用巢狀交叉驗證:內層選方案,外層評估整個選擇過程;計算成本也會增加。
最後的測試集仍只代表它涵蓋的對象與期間。模型在舊城市表現好,不等於新城市一樣好;上線後資料與流程變動,還要持續監控。評估可信的意思是清楚知道它測了什麼,而不是永遠保證未來。
報分數時,把切分設計一起交代
一個可檢查的結果應包含預測時點、樣本單位、時間範圍、群組規則、訓練/驗證/測試用途、前處理擬合範圍,以及模型選擇是否看過最後測試。還要知道少數類別與重要子群在評估中有多少樣本。
「隨機切80/20、準確率很高」不足以說明上述問題。如果切分模擬的情境和真正使用不同,漂亮的分數也可能只回答了一個比較容易的問題。
下一篇會進一步拆開準確率、Precision、Recall與閾值。但在比較指標之前,先確認它們建立在正確的保留資料上;換一個指標,救不了已洩漏的評估。
來源與圖像授權
- Google,Dividing the original dataset:圖1–3教材自製示意,依CC BY 4.0使用,原圖未改,見網站政策。本文另區分時間、群組與不同部署目標,不將任何固定比例當成必要條件。
- scikit-learn developers,Visualizing cross-validation behavior:圖4–8與合成資料的切分程式,依BSD 3-Clause使用,原圖未改。
- scikit-learn developers,Cross-validation:圖9–10、分層/群組/時間切分與模型選擇觀點,完整BSD聲明附於文末。
- scikit-learn,Common pitfalls and recommended practices:前處理一致性與資料洩漏;本文沒有重跑原頁的分類實驗。
本文顧客表與月份安排為獨立教學情境,沒有宣稱完成真實上線成效或特定分數的驗證。
圖像授權聲明
以下保留scikit-learn原圖完整BSD聲明;原作者沒有為本站背書。
BSD 3-Clause License

Copyright (c) 2007-2026 The scikit-learn developers.
All rights reserved.

Redistribution and use in source and binary forms, with or without
modification, are permitted provided that the following conditions are met:

* Redistributions of source code must retain the above copyright notice, this
  list of conditions and the following disclaimer.

* Redistributions in binary form must reproduce the above copyright notice,
  this list of conditions and the following disclaimer in the documentation
  and/or other materials provided with the distribution.

* Neither the name of the copyright holder nor the names of its
  contributors may be used to endorse or promote products derived from
  this software without specific prior written permission.

THIS SOFTWARE IS PROVIDED BY THE COPYRIGHT HOLDERS AND CONTRIBUTORS "AS IS"
AND ANY EXPRESS OR IMPLIED WARRANTIES, INCLUDING, BUT NOT LIMITED TO, THE
IMPLIED WARRANTIES OF MERCHANTABILITY AND FITNESS FOR A PARTICULAR PURPOSE ARE
DISCLAIMED. IN NO EVENT SHALL THE COPYRIGHT HOLDER OR CONTRIBUTORS BE LIABLE
FOR ANY DIRECT, INDIRECT, INCIDENTAL, SPECIAL, EXEMPLARY, OR CONSEQUENTIAL
DAMAGES (INCLUDING, BUT NOT LIMITED TO, PROCUREMENT OF SUBSTITUTE GOODS OR
SERVICES; LOSS OF USE, DATA, OR PROFITS; OR BUSINESS INTERRUPTION) HOWEVER
CAUSED AND ON ANY THEORY OF LIABILITY, WHETHER IN CONTRACT, STRICT LIABILITY,
OR TORT (INCLUDING NEGLIGENCE OR OTHERWISE) ARISING IN ANY WAY OUT OF THE USE
OF THIS SOFTWARE, EVEN IF ADVISED OF THE POSSIBILITY OF SUCH DAMAGE.
封面沿用本篇已註明來源的配圖,僅等比縮放並加白邊以保留全圖;圖片原有的署名與授權條件同樣適用於封面版本。
留言0
登入後就能留言。
登入