
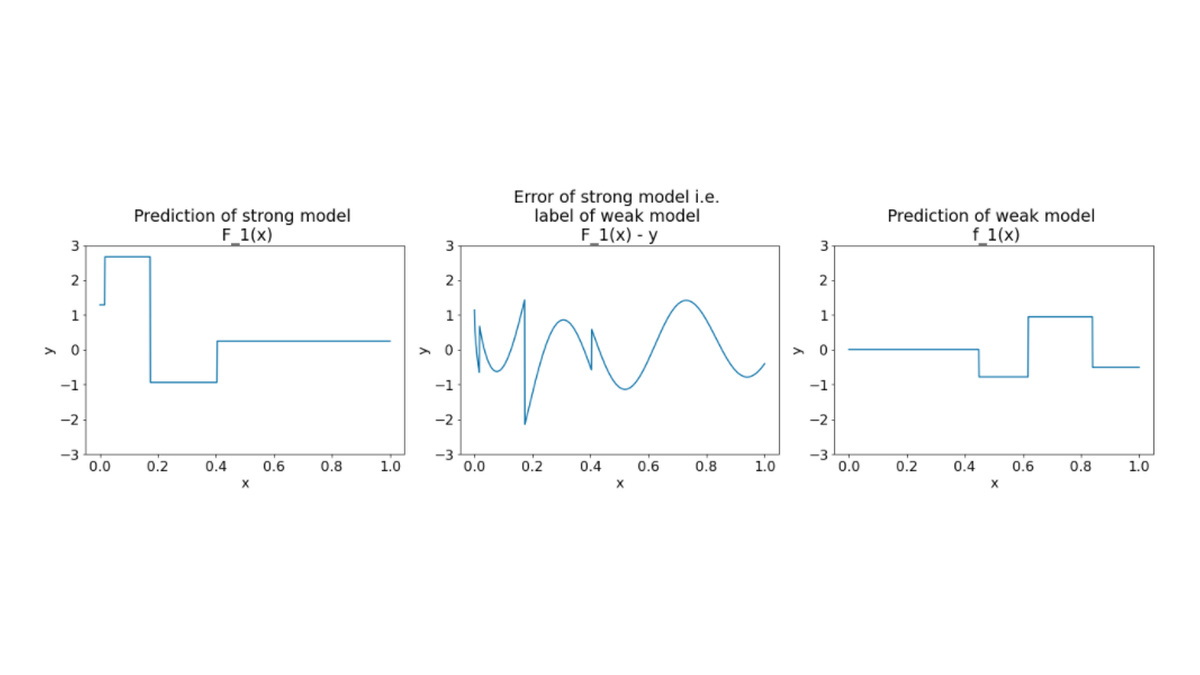
Random Forest讓不同的樹各自學,再聚合答案。Boosting換了一個方向:先看目前整個模型還缺什麼,再訓練下一個模型,逐輪補上。
標題說「補錯」,指的是補目前集成模型的不足,不是只找上一棵樹分錯的幾筆資料。不同Boosting方法對「不足」的定義也不同:Gradient Boosting用損失的梯度,AdaBoost則透過樣本權重與弱分類器權重來推進。
這篇先從平方誤差下的殘差修正出發,實跑兩輪小樹,再分清兩種Boosting與驗證的關係。減少訓練誤差是過程,改善新資料預測才是我們要檢查的結果。
第一個模型可以很簡單
以迴歸為例,我們要預測連續數值y。先給一個初始預測F₀(x),再逐輪加入小模型hₘ(x):
Fₘ(x) = Fₘ₋₁(x) + η hₘ(x)
η是學習率,也常稱shrinkage。每次只沿新模型的方向走一部分,而不是一次完全接受它的修正。
在平方誤差下,一個常見初始模型是訓練目標的平均。接著計算每筆殘差:
rᵢ = yᵢ − Fₘ₋₁(xᵢ)
拿原特徵x當輸入、殘差r當新的訓練目標,讓小樹學「哪一類輸入還應往上或往下修多少」。它仍然使用所有參與該輪的樣本,不只是分類錯誤的樣本。
六筆資料,兩輪看得見的變化
以下全部為本站自訂教學資料,x沒有業務單位:
- 10
- 12
- 15
- 25
- 28
- 30
先預測平均20,六筆殘差是−10、−8、−5、5、8、10,訓練MSE為63。
第一輪用只有一層切分的迴歸樹擬合殘差。它在x=3.5切開,左葉平均殘差約−7.666667,右葉約7.666667。取η=0.5:
左半預測 = 20 + 0.5×(−7.666667) ≈ 16.166667
右半預測 = 20 + 0.5×7.666667 ≈ 23.833333
沒有一次修到葉內平均,也不必讓每筆殘差歸零。第二輪重算目前殘差,再擬合一棵新小樹;這次仍選3.5,兩葉修正約−3.833333與3.833333。
| 階段 | x=1、2、3的預測 | x=4、5、6的預測 | 訓練MSE |
|---|---|---|---|
| 初始常數 | 20 | 20 | 63 |
| 第一輪後 | 約16.166667 | 約23.833333 | 約18.916667 |
| 第二輪後 | 14.25 | 25.75 | 約7.895833 |
這些數字會在後面的完整程式實際算出。因為只有六筆訓練資料,沒有保留測試,這張表只說明更新流程,不能當作泛化成效。
為什麼叫Gradient Boosting
對單筆½平方損失:
L(y,F) = ½(y−F)²
對F微分:∂L/∂F = F−y
負梯度:−∂L/∂F = y−F = 殘差
因此,剛才擬合殘差,正是在學每筆損失下降的方向。更一般的Gradient Boosting,是讓新模型近似目前損失對預測的負梯度,再用適當步幅或葉值更新。
換損失時,新的訓練目標不一定還是簡單的y−F。例如二元log loss、以原始分數F經sigmoid得到p時,負梯度對應y−p;更新的是分數模型,而不是任意把機率直接相加。這和分類機率的分數/機率區別相連。
「弱模型」通常限制了每次修正的表達能力,例如淺樹;它不是說每棵樹可以完全亂猜,卻仍保證集成會變好。
讀原圖時,先確認誤差的正負號
Google的來源示例使用不同記號:把誤差定義成F−y,訓練小樹f去擬合它,再做F新=F舊−f。它和本篇用y−F、再加h的方向一致,不能把一邊的訓練目標與另一邊的更新符號混搭。
圖1|來源以一個數值特徵x對應合成y,作為逐輪擬合的目標。它不是本篇六筆資料,也不是帶有獨立測試標籤的業務實驗。來源:Google,Gradient Boosted Decision Trees,CC BY 4.0,原圖未改。
圖2|左邊F₀仍為0,中間是F₀−y,右邊f₀擬合這個誤差;來源再從強模型減去f₀。左圖不是已完成第一次修正的預測。來源同圖1,原圖未改。
圖3|左邊改為F₁,中間F₁−y,右邊下一個修正f₁。注意新樹在學剩餘問題,並沒有從頭另學一個完整y再和前者等權平均。來源同圖1,原圖未改。
圖4|上排原圖標F₂、下排F₁₀;每排依序是強模型、F−y誤差及弱模型。後期強模型更接近原目標,殘留誤差縮小。以圖上實際標籤區分階段,不把原文的「第幾次迭代」說法混成更新前後同一時刻。來源同圖1,原圖未改。
這組來源示意從0開始、沒有使用shrinkage,弱樹最大深度3;本篇六點則從平均20開始、深度1、η=0.5。初始常數與限制不同,因此不應期待兩組曲線或數值對得上。
學習率小,不等於可以無限加樹
學習率控制每次新模型的貢獻。較小η常需要更多輪才能達到類似擬合程度;若輪數不一起考慮,只把η調小也可能欠擬合。
輪數增加後,模型可能繼續改善訓練損失,卻開始追逐雜訊。應用驗證資料選擇輪數或early stopping,而不是只看到訓練下降就一直加。
圖5|來源在diabetes迴歸資料保留10%測試,使用500棵深度4樹、learning_rate=0.01;在此平方誤差設定下,圖的deviance對應所算MSE。藍色訓練曲線持續下降,紅色test曲線趨平;不是accuracy或本站六點實驗。來源:scikit-learn developers,Gradient Boosting regression,BSD 3-Clause,原圖未改。
原圖可以提醒我們觀察兩種曲線,但自己的選參不能反覆看最後test。先在開發資料用驗證或交叉驗證選擇,再用保留測試作最後檢查;也不從這個資料集的數字推論任何醫療應用。
除了輪數與學習率,還可以限制深度、葉數、每葉樣本,或使用樣本/特徵抽樣。
圖6|此來源另用4,000筆、10維的合成二元資料,保留80%作test,最多400輪、每樹最多4葉。縱軸由程式算2×log loss;不同於圖5迴歸MSE,也不是分類錯誤率。這組結果說明learning_rate與subsample等設定需要一起比較,不是所有資料都由某條曲線永遠勝出。來源:scikit-learn developers,Gradient Boosting regularization,BSD 3-Clause,原圖未改。
隨機抽樣可以出現在Boosting裡,但每輪的新目標仍取決於目前集成。看到subsample這個參數,不能就把它等同於獨立訓練的Random Forest。
AdaBoost:另一種讓後面模型更關注難例的方法
AdaBoost常以樣本權重控制弱分類器的訓練:分錯的樣本在下一輪相對更重要;同時依弱分類器表現,決定它在最後集成的權重。
這可以直接透過加權訓練完成,不一定要真的把資料重新抽成一份副本。它和Gradient Boosting直接擬合損失梯度的描述不同,不要把所有Boosting一律說成「只訓練分錯的資料」。
以經典二元、標籤y與弱分類器h皆為±1的一輪為例,若加權錯誤率ε介於0與0.5:
α = ½ ln[(1−ε)/ε]
新樣本權重 ∝ 舊權重 × exp(−α y h)
假設四筆原本各重1/4,弱分類器只錯第二筆,ε=1/4,α約0.549306。更新並正規化後,第二筆重1/2,另外三筆各1/6。分對的樣本仍然存在,只是相對權重下降。
這是指定的二元教學公式;多類SAMME等變體的係數與條件不同,不能把½係數直接套到所有API。ε為0或不滿足弱學習條件時,也不能不加處理地套這個算式。
圖7|來源2,000筆、10維、3類合成資料,70%訓練,SAMME搭配最多8葉的小樹,最多300輪;縱軸是test的1−accuracy。這不是前面的四筆二元例,也不是本篇實跑;虛線為單弱樹,點線為Dummy基準,後期仍有起伏。來源:scikit-learn developers,Multi-class AdaBoosted Decision Trees,BSD 3-Clause,原圖未改。
如果錯誤來自髒標籤或不可辨的樣本,持續增加它們的相對影響也可能傷害模型。Boosting不會自動辨識哪個難例值得學、哪個是資料問題。
實跑兩輪殘差小樹
沿用Random Forest篇的實測環境:WSL、Python 3.10.12、NumPy 1.26.3、scikit-learn 1.5.1。以下真的呼叫DecisionTreeRegressor擬合兩輪殘差,沒有使用工具完整GradientBoostingRegressor;目的是讓更新步驟直接可見。
import numpy as np
from sklearn.metrics import mean_squared_error
from sklearn.tree import DecisionTreeRegressor

X = np.arange(1, 7, dtype=float).reshape(-1, 1)
y = np.array([10, 12, 15, 25, 28, 30], dtype=float)
prediction = np.full_like(y, y.mean())
learning_rate = 0.5
models = []
print("initial:", prediction.tolist(), "MSE:", round(mean_squared_error(y, prediction), 6))
for stage in range(1, 3):
    residual = y - prediction
    weak = DecisionTreeRegressor(max_depth=1, random_state=0)
    weak.fit(X, residual)
    models.append(weak)
    prediction += learning_rate * weak.predict(X)
    print("stage:", stage, "threshold:", weak.tree_.threshold[0],
          "predictions:", np.round(prediction, 6).tolist(),
          "MSE:", round(mean_squared_error(y, prediction), 6))
在上述環境,第一輪切點3.5、MSE約18.916667;第二輪仍切3.5、MSE約7.895833,預測與前表相同。若要對新X預測,需要保留初始常數、每棵小樹與學習率,依同一順序相加;不是只用最後那棵樹。
這段只在六個訓練點展示機制,沒有驗證或測試資料,因此不能用來選實務輪數,也未驗證泛化。正式工具還會依損失最佳化葉值、處理抽樣與其他細節,本篇不是完整Boosting套件的替代實作。
下面另外重算剛才固定弱分類器的AdaBoost權重,不訓練新的分類器:
from math import exp, log

labels = [1, 1, -1, -1]
weak_predictions = [1, -1, -1, -1]
weights = [0.25] * 4
error = sum(w for w, y_i, h_i in zip(weights, labels, weak_predictions) if y_i != h_i)
alpha = 0.5 * log((1 - error) / error)
updated = [w * exp(-alpha * y_i * h_i)
           for w, y_i, h_i in zip(weights, labels, weak_predictions)]
normalizer = sum(updated)
print("binary epsilon:", error, "alpha:", round(alpha, 6))
print("normalized weights:", [round(w / normalizer, 6) for w in updated])
輸出權重約0.166667、0.5、0.166667、0.166667,與手算一致。這裡的樣本權重、弱模型的集成權重α與Gradient Boosting學習率η,是不同位置的數字,不能混作同一個參數。
最後檢查的是損失、資料與選擇流程
先確定要預測什麼、用哪個損失,再考慮樹的複雜度、學習率和輪數。模型可以在訓練集逐步補得更細,但若資料切分洩漏,連驗證曲線都可能給錯訊號。
保留公平比較與誤差分析,看整體與重要群體,並和簡單基準比較。下一篇XGBoost會在這個逐輪加樹的架構上,進一步討論目標函數、二階資訊與樹複雜度;不是從另一套完全無關的原理開始。
來源與圖片授權
本站新增六點兩輪小樹實跑與四點AdaBoost權重算例。七張來源圖的完整實驗未由本站重跑,圖中各自的資料、損失與迭代記號依原圖說明。
- Google:Gradient Boosted Decision Trees,圖1–4依CC BY 4.0及網站政策使用;原圖採F−y並減去修正,和本文殘差符號明確區分。
- scikit-learn developers:Gradient Boosting regression、Gradient Boosting regularization、Multi-class AdaBoost。圖5–7依BSD 3-Clause使用,完整聲明如下。
BSD 3-Clause License

Copyright (c) 2007-2026 The scikit-learn developers.
All rights reserved.

Redistribution and use in source and binary forms, with or without
modification, are permitted provided that the following conditions are met:

* Redistributions of source code must retain the above copyright notice, this
  list of conditions and the following disclaimer.

* Redistributions in binary form must reproduce the above copyright notice,
  this list of conditions and the following disclaimer in the documentation
  and/or other materials provided with the distribution.

* Neither the name of the copyright holder nor the names of its
  contributors may be used to endorse or promote products derived from
  this software without specific prior written permission.

THIS SOFTWARE IS PROVIDED BY THE COPYRIGHT HOLDERS AND CONTRIBUTORS "AS IS"
AND ANY EXPRESS OR IMPLIED WARRANTIES, INCLUDING, BUT NOT LIMITED TO, THE
IMPLIED WARRANTIES OF MERCHANTABILITY AND FITNESS FOR A PARTICULAR PURPOSE ARE
DISCLAIMED. IN NO EVENT SHALL THE COPYRIGHT HOLDER OR CONTRIBUTORS BE LIABLE
FOR ANY DIRECT, INDIRECT, INCIDENTAL, SPECIAL, EXEMPLARY, OR CONSEQUENTIAL
DAMAGES (INCLUDING, BUT NOT LIMITED TO, PROCUREMENT OF SUBSTITUTE GOODS OR
SERVICES; LOSS OF USE, DATA, OR PROFITS; OR BUSINESS INTERRUPTION) HOWEVER
CAUSED AND ON ANY THEORY OF LIABILITY, WHETHER IN CONTRACT, STRICT LIABILITY,
OR TORT (INCLUDING NEGLIGENCE OR OTHERWISE) ARISING IN ANY WAY OUT OF THE USE
OF THIS SOFTWARE, EVEN IF ADVISED OF THE POSSIBILITY OF SUCH DAMAGE.
封面沿用Google圖3等比縮放加白邊。手機圖2–4依原圖每列左至右、各列上至下的順序重排為單欄,保留各圖標題、階段標籤、座標與完整曲線;改作依相同CC BY 4.0使用,未重畫數值。
留言0
登入後就能留言。
登入