
把一張圖片送進模型,先變成較短的向量,再還原回圖片:這看起來像壓縮。但如果把向量換成一個隨機抽來的數值,模型還會產生合理的圖片嗎?第一件事做得好,並不能直接回答第二件事。
Autoencoder(AE,自編碼器)讓 encoder 和 decoder 合作,學習從輸入到重建的映射。Variational Autoencoder(VAE,變分自編碼器)則把這條路徑放進機率模型:潛在變數從哪個分布來?輸入對應的 latent 有多不確定?decoder 描述的又是什麼觀測分布?
要看清「壓縮」和「生成」的差別,關鍵不只是中間多了一個抽樣步驟,而是訓練目標與生成時的起點。前一篇 GPT 到 GPT-3 把文字機率拆成逐 token 條件分布;本篇轉向另一條生成路線:透過看不到的 latent variable 描述觀測值。接著用一個能完全重建、卻不適合從指定 prior 抽樣的自訂反例,再拆開 VAE 的三種分布、ELBO 與重參數化。最後的 Python 小例只有固定一維 Gaussian 算術,沒有神經網路訓練、圖片資料或生成品質比較。
重建得回來,為什麼還不能隨機生成?
先看最基本的 deterministic AE:
z = encoder(x)      輸入 → 固定 latent code
x_hat = decoder(z)  latent code → 重建值

訓練:最小化資料上的 reconstruction loss(x, x_hat)
encoder 與 decoder 都有可學習參數。給定同一筆輸入及固定模型,這種 encoder 產生同一個 code。若把 latent 維度設得較小,模型必須在有限維度裡保留對重建有用的資訊;但 bottleneck 的存在,並沒有指定「所有 latent 應該服從什麼分布」。這裡討論的是基本 deterministic AE,不是把所有 denoising、稀疏或其他自編碼器都歸成同一種目標。
用一個完全手設、沒有訓練的線性反例看得更清楚。資料在一條線段上:x=(t, 2t),其中 t 介於 0 和 1。令:
encoder:f(x) = x₁ + 10
 decoder:g(z) = (z−10, 2(z−10))
每一筆資料的 code 都落在 10 到 11,而 g(f(x)) 恰好等於原輸入,重建誤差為零。可是,如果生成時另行決定從標準常態 N(0,1) 抽 z,大部分值會在 0 附近,decoder 便輸出大約 (-10,-20),遠離原來的資料線段。
問題不在此 decoder 算錯,而是訓練與抽樣的範圍沒有接起來。重建目標只約束資料被編碼到的位置;自行挑一個 prior,不會自動讓它抽到模型學會解碼的區域。AE 仍可作為其他生成方法的一部分,但「有 encoder、decoder 而且能重建」本身不是 prior sampling 品質保證。
也不要把 latent 維度直接換算成檔案壓縮率。784 個 8-bit 像素的原始儲存量是 784 bytes;32 個 float32 值則是 128 bytes。這只是兩種表示的原始容量,還沒有計入量化、熵編碼、格式標頭、模型權重以及還原誤差要求。較少維度不等於已做成更省空間的檔案格式,也不保證每個維度都對應可命名的語意。
VAE 的三種分布:誰負責推回去,誰負責生出來?
VAE 的生成故事先從 latent 出發:由 prior 抽 z,再由 decoder 的條件分布產生 x。但訓練資料給我們的是 x,看不到它背後的 z;因此需要一個近似推論模型,從觀測值反推 latent 分布。
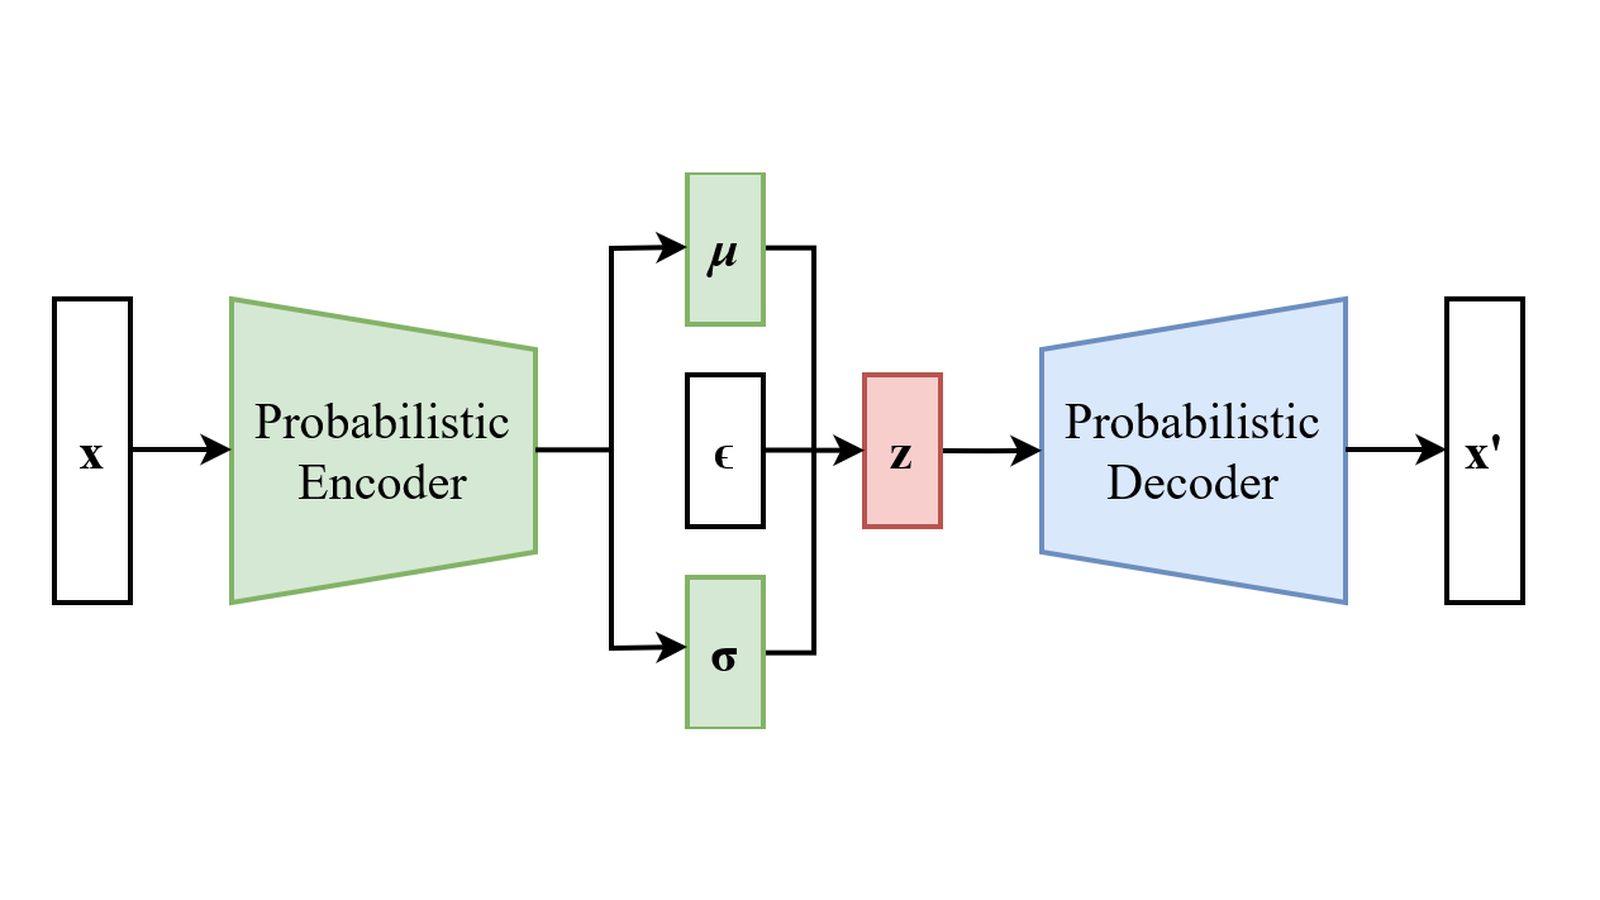
p(z),priorqφ(z|x) 是 encoder/recognition model,不是 prior,也不等於通常難算的真實 posterior pθ(z|x)。在常見對角 Gaussian 設定,encoder 輸出的是每筆資料的 mean 與 variance 參數,再從該分布取得 latent;它不是只把 x 映射成一個固定 code。
decoder 也不只是「輸出一張圖片」。在機率模型裡,它輸出或決定的是觀測分布的參數。例如 Gaussian likelihood 可以由 decoder 決定 mean;Bernoulli likelihood 可以由 decoder 決定各二元觀測的機率。資料類型與 likelihood 的選擇,會影響 reconstruction loss 的形式。
生成新資料時,可以走 z ~ p(z) → x ~ pθ(x|z),不必先拿一筆輸入經 encoder。若在重建時改用 q 的 mean,或顯示 decoder likelihood 的 mean,那是在選擇一種代表值;它與「從完整分布抽一個樣本」不是同一個操作。下方原型只算固定 decoder mean 與 NLL,沒有真的抽生成樣本。
這些角色來自 Kingma 與 Welling 的原始方法 §2.1–2.4、§3。這份論文最初於 2013 年提出、於 ICLR 2014 發表;本文採用正確的分布角色與高斯公式,不把早期版本個別記法當成所有 VAE 的規格。
ELBO 是 log likelihood 的下界,負號改變界的方向
如果生成模型已定義 p(z) 和 pθ(x|z),觀測到 x 的 marginal likelihood 要把所有 latent 的貢獻積分起來:
pθ(x) = ∫ pθ(x|z) p(z) dz
對複雜 decoder,這個積分及真實 posterior 往往不好直接求解。引入 qφ(z|x) 後,可以得到 evidence lower bound,簡稱 ELBO:
ELBO(x) = E_q[log pθ(x|z)] − KL(qφ(z|x) || p(z))

log pθ(x) = ELBO(x) + KL(qφ(z|x) || pθ(z|x))
第二式中,KL 非負,所以 ELBO 不大於 log pθ(x)。若把要最大化的 ELBO 乘上負號,改成常見的最小化目標:
negative ELBO = E_q[−log pθ(x|z)] + KL(qφ(z|x) || p(z))

negative ELBO >= −log pθ(x)
第一項是期望 reconstruction NLL;第二項把每筆資料的近似 posterior 與生成 prior 連起來。它不是把所有 mean 都硬設成 0、variance 都硬設成 1 的指令,而是與重建項一起最佳化的目標。要完全捨棄輸入資訊還是保留哪些資訊,與模型、資料和訓練都有關,不能只看有沒有 KL。
兩個式子裡出現的 KL 要分清。loss 的 KL(q || prior) 是目標的一部分;衡量 ELBO 與 log likelihood 差距的是 KL(q || true posterior)。它們右側的分布不同,數值也通常不同。不能拿 loss 裡那個 KL 當作「這次 ELBO 距離真實 log likelihood 還有多少」。
這個 bound 說的是期望形式的 ELBO。若用抽樣近似期望,某一次單項值不保證仍然位於相同界的一側;本文三個手選 epsilon 更不是 Gaussian 抽樣,不能把它們平均後冒稱得到 Monte Carlo ELBO。後面會用數值把這層差別說清。
重建 NLL 不是永遠等於 MSE,KL 也有方向
假設一維 decoder likelihood 是 Gaussian:mean 為 mθ(z),固定 observation standard deviation 為 τ。它的負對數密度為:
−log pθ(x|z) = 0.5 log(2π τ²) + (x−mθ(z))² / (2τ²)
本文 log 均為自然對數。以下一維觀測的 NLL 是密度的負對數,以此設定下的 nats 表示。
在固定 τ 的情況,平方誤差前有固定比例,加上與 mean 無關的正規化常數。若只最佳化 decoder mean,拿掉這些常數或正比例可以保留單獨重建項的最小點;但 VAE 還要加 KL,任意縮放重建項而不對應調整其他項,便會改變兩者的相對強度。若 τ 也要學習,更不能把依賴 τ 的項直接丟掉。
因此,實作時要看重建是對 features 求和還是平均、對 latent samples 怎麼處理、最後 batch 如何平均。把像素數從幾百改到幾萬,卻只改一邊的 reduction,數字看起來仍叫「reconstruction + KL」,目標比例卻可能已變。連續 likelihood 的 NLL 是密度的負對數,一般也可以是負值,不能從本篇正數例子推所有 NLL 都非負。
對標準常態 prior,若 q(z|x)=N(μ, σ²),一維解析 KL 是:
KL(q || N(0,1)) = 0.5(μ² + σ² − 1 − log σ²)
多維對角 Gaussian 則把各維對應項加起來。這個方向是 q 到 prior,不是 prior 到 q;兩個 mean/variance 不同時,反過來一般不會一樣。原論文後版 Appendix B 提供高斯 KL 推導;後版附錄的版本與早期主文分開引用。
重參數化:固定的是 epsilon,不是切斷參數的路徑
若直接把 z 當成抽樣函式交回的一個常數,就看不到 encoder 參數如何改變這個 z。對 Gaussian,可以把依賴參數的隨機變數改寫成:
ε ~ N(0,1)
z = μφ(x) + σφ(x) ε

若 encoder 輸出 l = log σ²:
σ = exp(l/2)
z = μ + exp(l/2) ε
抽樣來源改成不依賴 φ 的 epsilon,而 z 對 μ 與 l 仍可微。做一次 pathwise 微分時,固定這次 epsilon,沿 z 到 decoder、loss 的路徑套用鏈式法則:
∂z/∂μ = 1
∂z/∂l = 0.5 σ ε
這不是把「隨機」拿掉,也不是要求 epsilon 永遠等於 0。真正訓練可在每次計算依設定抽新的 epsilon,用可微目標估計梯度;本篇則刻意固定 −1、0、1,讓每一條計算路徑都能手算與差分核對。它們是教學輸入,不是一次抽到的 Gaussian draws。
reparameterization 讓梯度能處理這類連續分布的路徑,不保證 optimizer 必然收斂,也不保證生成品質、latent 語意或每個隨機變數都能直接套同一高斯公式。
一維小例:把 z、NLL、KL 與期望分開算
固定一筆觀測 x=1,採用:
q(z|x) = N(0.3, 0.7²)
p(z)   = N(0,1)
p(x|z) = N(1.2z−0.1, 0.5²)
這裡的 0.7 是 latent posterior 的標準差;0.5 是 observation likelihood 的標準差,兩者角色不同。所有數值都直接指定,沒有 encoder 訓練或 decoder 權重學習。
KL 與 epsilon 無關:把 μ=0.3、σ²=0.49 代入上式,得到約 0.14667494393873243。再看三個固定 epsilon 產生的 z 與 decoder mean:
以第一列為例,x−mean=1.58,平方誤差為 2.4964,除以 2×0.25 後加高斯正規化常數,就得到 NLL 約 5.2185913526447285。這個 mean 離觀測值較遠,因此此固定 likelihood 的 NLL 較高。
三項用來看「同一個 q 下,不同 z 對重建的影響」。它們不是三張生成圖片,NLL 的大小也不是人眼品質分數。尤其不能把最小的那列當作整個 negative ELBO。
對這個線性 Gaussian,期望平方誤差可以解析計算:
E_q[(x−(wz+b))²] = (x−(wμ+b))² + w²σ²
                  = 0.74² + 1.2²×0.49
                  = 1.2532

E_q[Gaussian NLL] ≈ 2.732191352644727
KL(q || prior)   ≈ 0.14667494393873243
negative ELBO    ≈ 2.8788662965834595
期望中的第二項是 latent 變動經 decoder 放大後的貢獻,不能只拿 z=μ 的重建誤差取代整個期望。程式另用 [-8,8]、步長 0.001,把各 z 的 NLL 乘上 q 密度作梯形積分,再除以該區間的積分質量核對,在這組 mean/variance 下,積分質量接近 1,期望 NLL 與解析結果相差約 9.77×10⁻¹⁵。這是有限區間的數值交叉核對,不是任意分布或尾部都沒有誤差的證明。
這個例子還能手算 marginal:由 z~N(0,1),得到 x~N(−0.1, 1.69);代入 x=1,其 marginal NLL 約為 1.539290963352637。期望 negative ELBO 2.878866297 確實較大;但 ε=1 那列單項 0.392466297 卻較小,直接說明「每個固定 epsilon 的單項都構成上界」並不成立。這個 marginal 是另外的解析對照,不是下方 JSON 的輸出欄位。
兩者差距約 1.339575333,是 KL(q || true posterior);它也不是剛才 q 到 prior 的 0.146674944。這兩個 KL 在同一小例裡就有明顯差別。
用完整程式檢查 pathwise gradient
令 l=log σ²,對每個固定 epsilon,程式求的是該單項 NLL 加解析 KL 的導數:
dNLL/dz = (decoder_mean−x) w / τ²

dLoss/dμ = dNLL/dz + μ
dLoss/dl = (dNLL/dz)(0.5 σ ε) + 0.5(σ²−1)
例如 ε=0 時,z=0.3、mean=0.26,dNLL/dz=(0.26−1)×1.2/0.25=−3.552,加上 KL 的 μ 導數 0.3,得到 dLoss/dμ=−3.252。此時 ∂z/∂l=0,所以 log variance 的導數只剩 KL 項 −0.255。另外兩個 epsilon 則會多出重建項經 σ 傳回的梯度。
程式以固定 epsilon、步長 10⁻⁶ 的中心差分核對 μ 與 log variance;保存輸出的最大絕對誤差約 1.574×10⁻¹⁰。這是在確認固定路徑的微分,不是拿三個固定值估計完整期望梯度,更沒有執行參數更新。
將完整程式存為 vae_reparameterization.py,在已有 Python 3 的環境執行:
python3 vae_reparameterization.py > stdout.json
已保存的實際環境為 Python 3.10.12,僅標準函式庫,無套件安裝、模型下載或亂數。依原型獨立審閱,fresh run 與保存 stdout 逐 byte 相同,並另以不同微分/積分方法核對;這是本環境的有限算術證據,不宣稱所有平台最後浮點位數都相同。
#!/usr/bin/env python3
"""Fixed scalar Gaussian VAE mechanics; deterministic, standard library only."""
import json
import math
import platform


X = 1.0
MU = 0.3
SIGMA = 0.7
W = 1.2
B = -0.1
OBS_SIGMA = 0.5
EPSILONS = (-1.0, 0.0, 1.0)


def terms(mu, logvar, epsilon):
    sigma = math.exp(0.5 * logvar)
    z = mu + sigma * epsilon
    decoder_mean = W * z + B
    variance = OBS_SIGMA**2
    nll = 0.5 * math.log(2.0 * math.pi * variance)
    nll += 0.5 * (X - decoder_mean) ** 2 / variance
    kl = 0.5 * (mu**2 + sigma**2 - 1.0 - logvar)

    d_nll_dz = (decoder_mean - X) * W / variance
    dmu = d_nll_dz + mu
    dlogvar = d_nll_dz * 0.5 * sigma * epsilon + 0.5 * (sigma**2 - 1.0)
    return {
        "sigma": sigma,
        "z": z,
        "decoder_mean": decoder_mean,
        "gaussian_nll": nll,
        "kl": kl,
        "negative_elbo_sample": nll + kl,
        "pathwise_gradient_mu": dmu,
        "pathwise_gradient_logvar": dlogvar,
    }


def central_difference(function, value, step=1e-6):
    return (function(value + step) - function(value - step)) / (2.0 * step)


def density(z, mu, sigma):
    return math.exp(-0.5 * ((z - mu) / sigma) ** 2) / (sigma * math.sqrt(2.0 * math.pi))


def gaussian_nll_at_z(z):
    mean = W * z + B
    return 0.5 * math.log(2.0 * math.pi * OBS_SIGMA**2) + 0.5 * (X - mean) ** 2 / OBS_SIGMA**2


def main():
    logvar = math.log(SIGMA**2)
    rows = []
    fd_errors = []
    for epsilon in EPSILONS:
        result = terms(MU, logvar, epsilon)
        result["epsilon_fixed_not_sampled"] = epsilon
        fd_mu = central_difference(lambda m: terms(m, logvar, epsilon)["negative_elbo_sample"], MU)
        fd_lv = central_difference(lambda lv: terms(MU, lv, epsilon)["negative_elbo_sample"], logvar)
        result["central_difference_gradient_mu"] = fd_mu
        result["central_difference_gradient_logvar"] = fd_lv
        fd_errors.append(max(abs(fd_mu - result["pathwise_gradient_mu"]), abs(fd_lv - result["pathwise_gradient_logvar"])))
        rows.append(result)

    expected_nll = 0.5 * math.log(2.0 * math.pi * OBS_SIGMA**2)
    expected_nll += 0.5 * ((X - (W * MU + B)) ** 2 + W**2 * SIGMA**2) / OBS_SIGMA**2
    kl = 0.5 * (MU**2 + SIGMA**2 - 1.0 - logvar)
    expected_negative_elbo = expected_nll + kl

    # Independent density-weighted trapezoid quadrature over z in [-8, 8].
    lo, hi, step = -8.0, 8.0, 0.001
    n = round((hi - lo) / step)
    weighted_sum = 0.0
    mass_sum = 0.0
    for i in range(n + 1):
        z = lo + i * step
        trapezoid_weight = 0.5 if i in (0, n) else 1.0
        p = density(z, MU, SIGMA)
        weighted_sum += trapezoid_weight * p * gaussian_nll_at_z(z)
        mass_sum += trapezoid_weight * p
    numerical_mass = mass_sum * step
    numerical_expected_nll = weighted_sum * step / numerical_mass

    output = {
        "scope": "deterministic_scalar_reparameterization_example_not_a_trained_VAE",
        "runtime": {"python": platform.python_version(), "dependencies": "Python standard library only"},
        "fixed_parameters": {
            "x": X, "q_mu": MU, "q_sigma": SIGMA, "q_logvar": logvar,
            "decoder_w": W, "decoder_b": B, "likelihood_sigma": OBS_SIGMA,
            "epsilons_are_hand_chosen_not_gaussian_draws": list(EPSILONS),
        },
        "fixed_epsilon_samples": rows,
        "gradient_check": {
            "method": "central finite differences with fixed epsilon and step 1e-6",
            "max_abs_error_over_mu_and_logvar": max(fd_errors),
        },
        "expected_objective": {
            "expected_gaussian_nll_closed_form": expected_nll,
            "kl_q_to_unit_normal": kl,
            "negative_elbo_closed_form": expected_negative_elbo,
            "quadrature": {
                "method": "trapezoid integral of q(z|x) density times scalar Gaussian NLL",
                "interval": [lo, hi], "step": step,
                "integrated_probability_mass": numerical_mass,
                "expected_gaussian_nll": numerical_expected_nll,
                "absolute_difference_from_closed_form": abs(numerical_expected_nll - expected_nll),
            },
        },
        "limitations": [
            "No neural network, learned encoder/decoder, dataset, training, Monte Carlo quality estimate, or latent traversal.",
            "The three fixed epsilon values illustrate the path, not draws from a Gaussian or an estimate of sample quality.",
            "The expected NLL is checked analytically and by numerical integration for this scalar Gaussian setup only.",
        ],
    }
    print(json.dumps(output, indent=2, sort_keys=True))


if __name__ == "__main__":
    main()
輸出時先核對 fixed_parameters 的兩個 sigma,再看 fixed_epsilon_samples 是手選 epsilon,最後看 expected_objective 的解析期望與積分結果。只見到 finite difference 誤差很小,並不能說模型已學會重建;這支程式根本沒有學習模型。
重建、生成與 latent 是否有用,要分開驗證
在實際專案,先決定你需要的結果。如果要把既有資料映射成較短表示再還原,可以先評估重建誤差、保留的重要結構與真正儲存成本;如果要從 prior 生成,就還需要檢查從該 prior 抽樣的結果,而不能只展示輸入經 encoder 後的漂亮重建。
同樣地,VAE 有 KL 也不保證 latent 有用。常見的 posterior collapse 指近似 posterior 接近 prior、模型忽略 latent 的情況;不能把它直接當成「生成圖片都差不多」或一般 mode collapse 的同義詞。可以同時觀察每筆或每維 KL、改變 latent 是否影響 decoder、重建與生成等證據,但不能只由單個總 loss 宣判原因。這裡只介紹失敗模式,沒有實測任何 VAE 的 collapse。He 等人的原論文摘要 說明了 ignored latent 與 posterior mimicking prior 的定義;本文不引用其方法成效比較。
本篇的固定 q 與 decoder 沒有學習,因此不具備判斷 representation quality、資料多樣性或 latent traversal 效果的證據。它提供的是可核算的機制:由哪個分布取得 z、loss 包含什麼、梯度沿哪條路回去,以及何時談的是期望、何時只是單項。
若要判斷自己是否分清 AE 與 VAE,可以回到開頭的問題:重建很好,是否代表任意選一個 prior 都能生成?答案需要看訓練如何把 q、prior 與 decoder 接起來,並實際檢查抽樣,而不能只由瓶頸比較短或 loss 名稱裡有 reconstruction 得出結論。
來源與延伸閱讀
- VAE 方法:Kingma 與 Welling,Auto-Encoding Variational Bayes,2013 v1 PDF,本篇依 §2.1–2.4、§3 的生成模型、variational bound、重參數化與 Gaussian 例;arXiv 版本頁 可追溯年份及修訂。Gaussian KL 另參 v11 Appendix B,版本與早期主文區分。本文沒有重刊原論文圖像。
- Posterior collapse:He、Spokoyny、Neubig、Berg-Kirkpatrick,Lagging Inference Networks and Posterior Collapse in Variational Autoencoders,本篇只用官方摘要的 ignored latent/posterior mimics prior 定義,不引用其方法成效或重跑 benchmark。
- 圖 1:Chervinskii,Autoencoder structure 原作品頁;圖 2:Juanciño,Figura 05 autoencoder 原作品頁;圖 3:EugenioTL,VAE Basic 原作品頁;圖 4 及封面:EugenioTL,Reparameterized Variational Autoencoder 原作品頁。四個不同作品均由各自作品頁提供 CC BY-SA 4.0,本文所列圖像改作維持相同授權並各別署名;沒有以教材授權外推原論文或其他第三方圖像權利。
- 本文的原創教學是串接重建與 prior sampling 的差別、自訂可完全重建的 AE 反例、拆解兩種 KL 與兩種 sigma,並解讀固定 Gaussian 原型的可核算機制。沒有資料集訓練、learned encoder/decoder、真實抽樣、latent traversal、生成影像或品質排名;完整程式與保存輸出對應的算術範圍已在正文說明。
留言0
登入後就能留言。
登入