
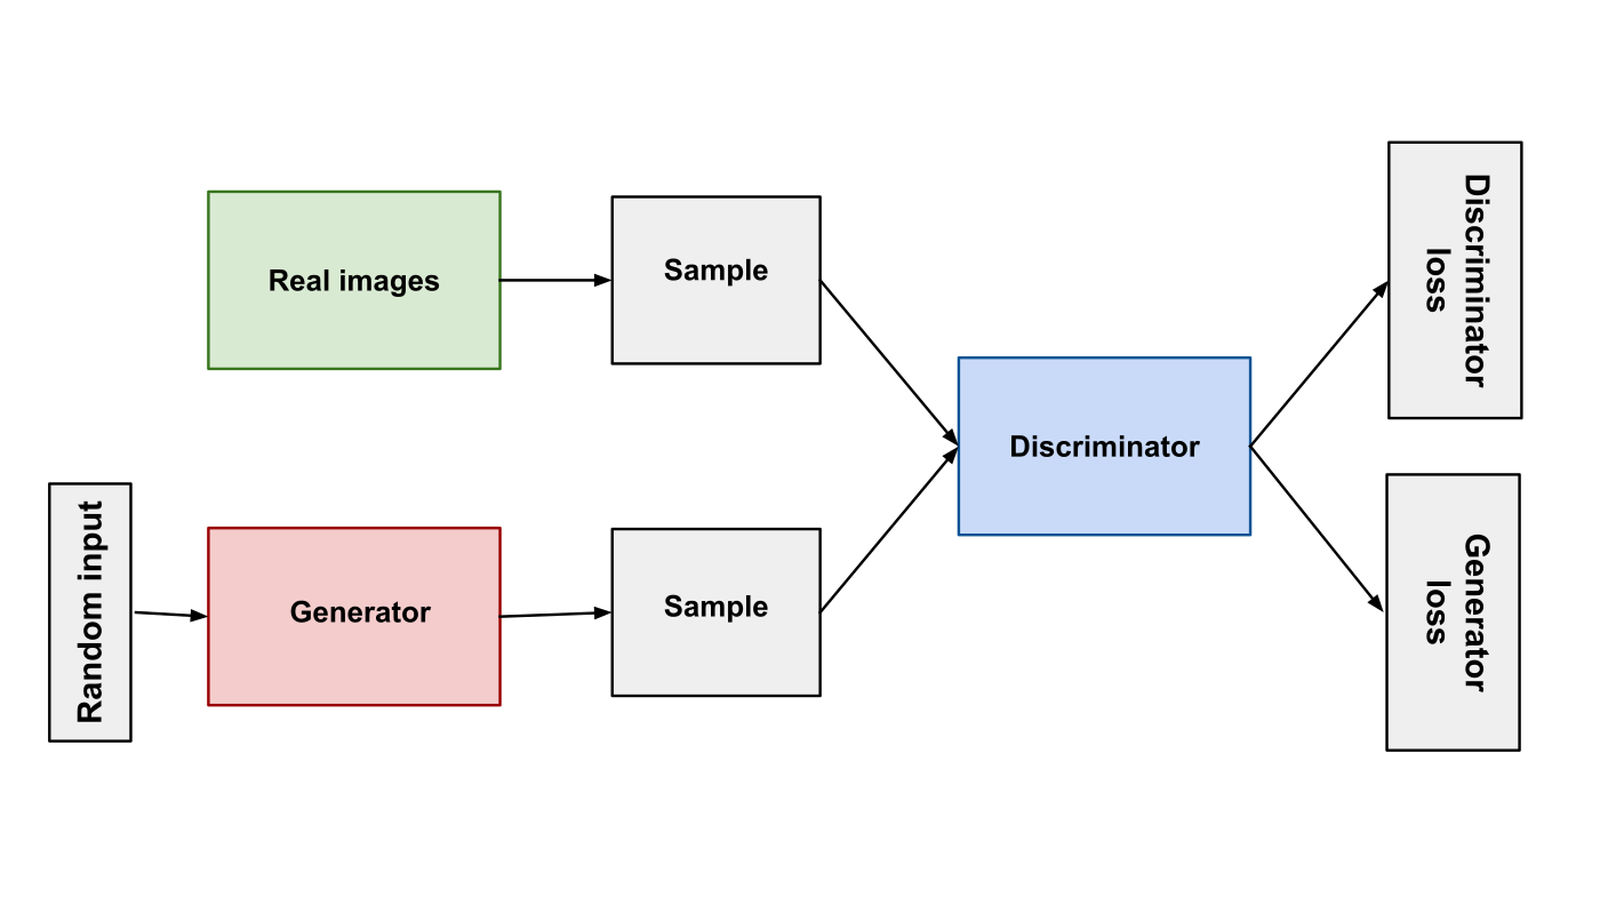
如果手上有一批真實資料,想學會產生相似的新樣本,要怎麼告訴模型「這次做得像不像」?GAN 的做法是讓另一個可學習的模型提供訊號:生成器負責產生樣本,判別器負責分辨樣本來自資料還是生成器,兩者交替改變參數。
但「互相競爭」還沒有說清楚訓練。更新判別器時,生成器要不要收到梯度?更新生成器時,判別器若不更新,還需要參與反向傳播嗎?同一張假樣本為什麼在不同階段會用到不同的 target?
本篇先用原圖拆開資料流與目標,再以四個可學習標量,實際執行一次 D 更新與一次 G 更新。這確實有梯度與 SGD 參數更新,並非只有畫出流程;範圍則限於固定小例,不是完整影像 GAN 訓練、生成品質或收斂實驗。前一篇 AE 與 VAE 從 likelihood 與重建談生成;這篇改由學得的判別訊號來引導生成器。
一個產生樣本,一個判斷來源
基本 GAN 有兩個模型。Generator(G,生成器)把 noise/latent z 映射成資料空間的樣本 G(z);Discriminator(D,判別器)讀取一筆樣本,輸出「來自真實資料」的分數。在原始 GAN 的機率記法裡,D(x) 介於 0 和 1。
這裡的 real 指來自指定資料來源,並不等於內容絕對正確、沒有偏差或不含雜訊;fake 指由 G 產生,也不自動等於對人類沒有價值。這是用來定義訓練問題的來源標籤。
與基本 deterministic AE 不同,這條生成路徑不必先拿某筆 x 編成它自己的 latent code,再要求逐筆還原。G 從指定 noise 分布取得輸入;訓練時希望整體生成分布接近資料分布,而不是要求每個 z 與某張真實圖片有固定的一對一重建標籤。
D 提供的訊號會隨訓練而變。當 G 改變,D 遇到的假樣本也改變;當 D 改變,G 接下來收到的梯度也改變。這是它與對固定目標函式做一般參數最佳化的重要差別,不能只把兩個各自下降的 loss 當成完成任務。
真假 target 屬於哪個階段?
先固定 G,讓 D 學會判別來源。最常見的二元約定是 real target=1、fake target=0;同一個 D 會處理兩種輸入,並非分成「看真圖的 D」與「看假圖的另一個 D」。
原始 GAN 的 value function 可以寫成:
min_G max_D V(D,G)

V(D,G) = E_real[log D(x)] + E_noise[log(1−D(G(z)))]
D 最大化 V:把 real 的 D 值往 1 推,把 fake 的 D 值往 0 推。如果實作統一採最小化 loss,D 就最小化負號版本:
L_D = −mean_real log D(x)
      −mean_noise log(1−D(G(z)))
本篇原型取兩個 batch 各自的 mean 再相加。若 real 與 fake 筆數相等,把它們拼接後只做一次 mean,數值會少一半;那是另一種 reduction,不是這裡同一個 loss。比例也會影響固定 learning rate 下的更新量。
程式讓 D 回傳未經 sigmoid 的 logit s,透過 binary_cross_entropy_with_logits 計算穩定的 sigmoid 加 BCE,而不是先 sigmoid 再把結果當 logits 傳進去。沒有額外權重時,單項公式為:
BCEWithLogits(s, y) = softplus(s) − y·s
softplus(s) = log(1+exp(s))

∂BCE/∂s = sigmoid(s) − y
正文使用自然對數。這條簡單導數,接下來同時用來核對 D 與 G 的梯度。原論文 §3 與 Algorithm 1 定義了原始對抗目標與交替更新;PyTorch 2.3.1 的 BCEWithLogitsLoss 原始碼 則交代本篇 API 的 logits 與 reduction 約定。
G 的 non-saturating loss,為什麼另選 target=1?
在原始 minimax 形式中,固定 D 後,G 最小化 log(1−D(G(z)))。這會鼓勵 D 把生成樣本判得更像 real;但當 G 很差、D 對 fake 的判斷接近 0 時,這個 G 目標可能給出很弱的梯度。
原始 GAN 論文 §3 就提出替代做法:改為最大化 log D(G(z)),也就是最小化 non-saturating loss:
L_G_nonSat = −mean_noise log D(G(z))
這相當於在 G 這個目標裡,對 D(G(z)) 使用 target=1。意思是 G 想讓生成物被 D 當真;它沒有把 D 訓練資料裡 fake 的來源標籤改成 real,也沒有要求在這一步順便把 D 訓練成接受所有假樣本。
令 fake logit 為 s、D=sigmoid(s),兩種最小化形式的 logit 導數是:
原 minimax G: log(1−D)    → 導數 −D
non-saturating:−log D    → 導數 D−1
當 D 非常確定 fake 是假,第一列直接顯示 non-saturating 的優點:相同 logit 下,梯度幅度大得多。第三列也提醒它並非在每個 logit 都比較大。這只是對 logit 的局部導數;真正 G 參數梯度還要乘上穿過 D 與 G 的 Jacobian,不能從單個導數幅度保證整個模型訓練穩定。
兩個 G 目標不是數值相同的 loss。原論文討論它們具有相同固定點,但這不代表可以混用 loss 數值,或把原 minimax 的所有理論公式直接當作 non-saturating loss 的恆等式。
兩個更新階段,梯度路徑怎麼分?
更新 D 時,當前 G 只是提供 fake 樣本。原型計算 fake=G(z),再把 fake.detach() 傳給 D,讓這個 D loss 對 G 的路徑在 fake 處中斷。接著只呼叫 D optimizer 的 step。
更新 G 時剛好不同:需要保留 G(z)→D→G loss 的可微路徑,才能知道生成樣本往哪裡改能讓 D 更接受它。此時原型將 D 參數的 requires_grad 設為 False,固定 D 參數;但 D 的 forward 仍參與可微計算,梯度可以相對於它的輸入傳回 G。
若把 G 階段的整個 D forward 放在 torch.no_grad() 裡,這個例子所需的路徑便被關閉,不能再靠此 G loss 把梯度傳回 G。requires_grad_(False)、detach() 和 no_grad() 各控制不同範圍,不能互相當成「反正都不要更新 D」的同義操作。PyTorch 2.3.1 no_grad 原始碼 說明了此 context 對梯度記錄的作用。
還要分清「沒有 step」與「沒有算參數梯度」。只對 G optimizer step,即使算出 D 的參數梯度也不會由該 optimizer 更新 D;本例進一步凍結 D 參數並先清空舊 grad,讓檢查更明確。requires_grad 也不等於 .eval():若換成含 BatchNorm、dropout 的模型,其模式與 buffers 還需另行安排。本篇標量模型沒有那些層,不把這兩步擴張成所有 GAN 的完整狀態管理範本。
真正走一次 SGD:D 先更新,G 再使用更新後的 D
這次只固定兩個 noise 值與兩個 real 標量,沒有從資料分布抽樣:
z = [−1, 1]
real = [0.8, 1.2]

G(z) = a·z+c,起始 a=0.4、c=−0.1
D logit(x) = w·x+b,起始 w=1.2、b=−0.3
D probability(x) = sigmoid(w·x+b)
因此起始 fake 是 [-0.5, 0.3];real logits 為 [0.66, 1.14],fake logits 為 [-0.9, 0.06]。程式的 D forward 回傳的是 logit,不要把例如 1.14 當成超出範圍的機率。
以單項導數 sigmoid(s)−y 接上 logit 的鏈式法則:
∂L_D/∂w = mean_real[(D(x)−1)x] + mean_fake[D(fake)·fake]
∂L_D/∂b = mean_real[D(x)−1]    + mean_fake[D(fake)]
保存的數值是 real mean BCE 約 0.34706565920109705,fake mean BCE 約 0.5323754939041144,兩者相加 L_D≈0.8794411531052115。梯度與 learning rate 0.05 給出的實際 D 更新為:
這一步 G 的兩個參數仍是 0.4、−0.1,grad 都是 None;是因為 fake detach 後不再把 D loss 傳回 G。
接著固定更新後的 w₁、b₁,重算 D(G(z)),不能假裝 D 還是原來的數值。對 G 的 non-saturating mean BCE,令每筆誤差信號 e=sigmoid(w₁(az+c)+b₁)−1:
∂L_G/∂a = mean[e·w₁·z]
∂L_G/∂c = mean[e·w₁]
這時 L_G≈0.9571396633237046。D loss 是兩個 mean 相加,G loss 是一個 mean,且這個 G loss 使用更新後的 D;不能由 0.957 大於 0.879 就判定 G 比 D 學得差。以 learning rate 0.1 執行真正的 G optimizer step:
此時 D 的參數仍保持上表更新後的值,grad 為 None,但 G 明確得到非零梯度。這便是「凍結 D 參數,仍保留對輸入梯度」的實際證據。
程式用 autograd、直接以 Python math 展開的鏈式法則,以及固定輸入的中心差分核對四個梯度,再對照 parameter−learning_rate×gradient 與實際 SGD 結果。這四個標量確實更新了;它們沒有因此證明完整資料分布已學會,更沒有影像、多樣性或長期收斂的證據。
D 都輸出 0.5,就表示 G 成功了嗎?
不一定。假設一個完全沒學會判別的 D 對任何輸入都輸出 0.5,無論 G 產生什麼,它也都會輸出 0.5。只看 D 猜不出來,不能排除 D 欠擬合、沒更新成功,或評估資料本身出了問題。
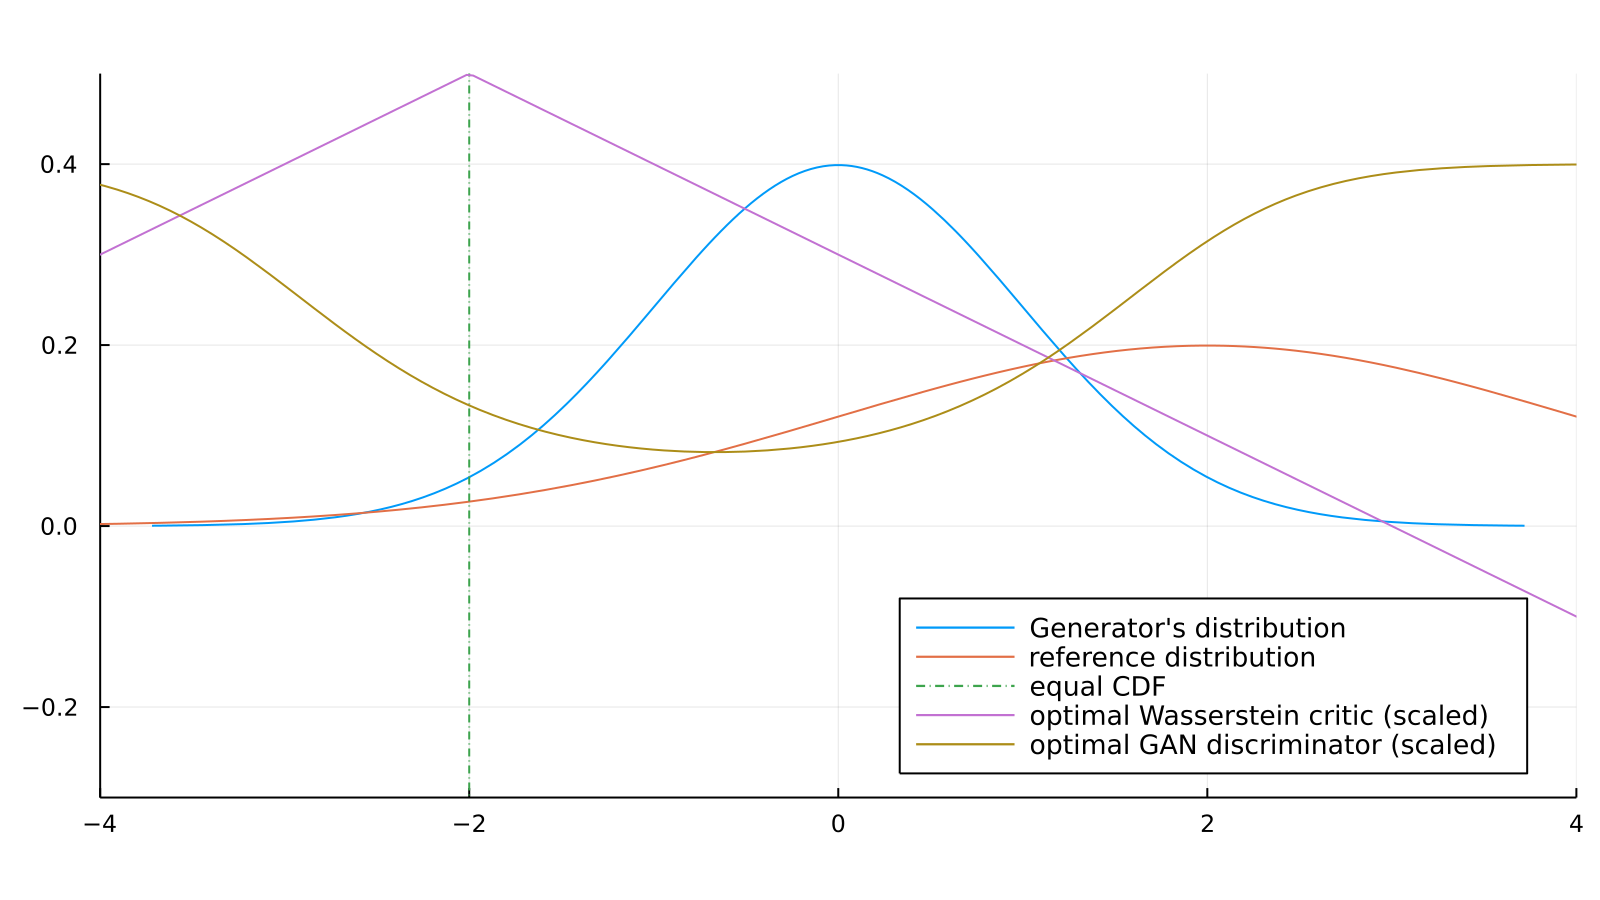
原始理論的條件更精確。固定 G、允許 D 在理想分布與足夠容量下達到最優時,在資料與生成密度總和非零的區域:
D*(x) = p_data(x) / (p_data(x)+p_g(x))
若兩個分布相同,這個最優 D 才是 1/2。把最優 D 代回原 minimax value,得到:
C(G) = max_D V(D,G)
     = −log(4) + 2·JSD(p_data || p_g)
JSD 是 Jensen–Shannon divergence,非負,在兩個分布相同時為零;於是這個理想 criterion 的全域最小值對應 p_g=p_data。這不是說只要某次 D loss 接近某個數字,就已量出 JSD,更不是 non-saturating G loss 的數值公式。
原論文 §4–4.2 在非參數、理想容量的設定討論這些結果。收斂論述還要求每一步 D 到達對當前 G 的最優,並直接在分布空間以足夠小的改善步驟更新 p_g。真實訓練改的是有限 MLP 的參數,可能有多個 critical points;論文本身就提醒,這些理論保證不會直接跟著搬過去。
因此,圖中兩模型交替更新是一個可實作機制;「普通 alternating SGD 必然到達理想均衡」則是另外一個沒有由此得到的保證。也不能把有限樣本上的 D accuracy 接近 50%,直接當作兩分布相同的證明。
讀來源訓練圖:先看 real 是哪來的,再看 loss 的定義
下面兩張是 D2L 原頁保存的 PyTorch 教學輸出。它們用二維高斯資料讓生成與判別可視化,沒有影像、照片或本站重跑。先看作為 real reference 的資料:
來源先從 1000 個 2D normal rows 產生訓練資料,data=X@A+b,母體 covariance 是 [[1.01,1.95],[1.95,4.25]]。G 是 Linear(2,2),D 則是 2→5→3→1 的 MLP,中間兩層 Tanh。這樣的線性 G 配 Gaussian noise,有機會描述此例的 Gaussian 目標;不能直接把結果外推到複雜影像分布。
來源把 G/D 的 weights 與 biases 初始化為 normal_(0,0.02),Adam 只明設 learning rate,其他使用來源當時 framework defaults;此段 code 沒有設定隨機 seed,圖是其保存的特定結果,不是本文保證逐點重現的輸出。
它的 D loss 先對 real、fake 各求 BCE sum,再把兩項相加除以 2;每個 epoch 累計後除以處理的 examples 數。G loss 是 target=1 的 BCE sum,epoch 累計同樣除以 examples 數。這與本文標量原型的「real mean 加 fake mean,沒有再除以 2」不同。
若 D 對所有輸入都為 0.5,單項 BCE 都是 log 2≈0.693147。來源這種 D 正規化會得到約 0.693147;本篇原型的兩個 mean 相加則會得到約 1.386294,G 的 non-saturating mean loss 為約 0.693147。可見不先對齊定義,直接比較兩張圖的 loss 高低沒有意義。來源兩條曲線接近 0.693,連同散點可以幫助理解這個例子,仍不足以單獨證明一般 GAN 成功、穩定或完整覆蓋資料分布。
執行完整程式,檢查更新範圍與 before/after
將下方完整程式存為 gan_minimax_updates.py,在已有 Python 與 PyTorch 的環境執行:
python3 gan_minimax_updates.py > stdout.json
保存的實際執行環境是 Python 3.10.12、PyTorch 2.3.1+cu118,所有張量在 CPU、float64 計算,沒有亂數或模型下載。套件 wheel 名稱含 cu118,不表示這次用過 GPU。這裡提供的是已裝環境的執行與算術核對,不宣稱全新 pip 安裝、其他平台或 GPU 已測。
原型只執行固定輸入的一次 D step 與一次 G step。輸出的 checks 會檢查 autograd/手算/差分與 SGD 是否一致,但閱讀時也要對照 discriminator_step、generator_step 的參數前後值,以及另一模型的 grad 是否為 None;只有看到一排 True,還不等於理解更新路徑。
"""A deterministic scalar GAN update example; not a neural-network training run."""
import json
import math
import platform

import torch
import torch.nn as nn
import torch.nn.functional as F

DTYPE = torch.float64
DEVICE = torch.device("cpu")


class ScalarGenerator(nn.Module):
    def __init__(self):
        super().__init__()
        self.a = nn.Parameter(torch.tensor(0.4, dtype=DTYPE, device=DEVICE))
        self.c = nn.Parameter(torch.tensor(-0.1, dtype=DTYPE, device=DEVICE))

    def forward(self, z):
        return self.a * z + self.c


class ScalarDiscriminator(nn.Module):
    def __init__(self):
        super().__init__()
        self.w = nn.Parameter(torch.tensor(1.2, dtype=DTYPE, device=DEVICE))
        self.b = nn.Parameter(torch.tensor(-0.3, dtype=DTYPE, device=DEVICE))

    def forward(self, x):
        # Return logits. BCEWithLogitsLoss applies a numerically stable sigmoid+BCE.
        return self.w * x + self.b


def f(x):
    return float(x.detach().cpu()) if isinstance(x, torch.Tensor) else float(x)


def sigmoid_scalar(x):
    # Stable scalar sigmoid without autograd.
    if x >= 0:
        e = math.exp(-x)
        return 1.0 / (1.0 + e)
    e = math.exp(x)
    return e / (1.0 + e)


def softplus_scalar(x):
    # Stable log(1 + exp(x)); used for independent loss/finite-difference checks.
    return max(x, 0.0) + math.log1p(math.exp(-abs(x)))


def bce_logit_scalar(logit, target):
    return softplus_scalar(logit) - target * logit


def mean(xs):
    return sum(xs) / len(xs)


def d_loss_scalar(w, b, z_values, real_values, a_value, c_value):
    fake_values = [a_value * z + c_value for z in z_values]
    real_loss = mean([bce_logit_scalar(w * x + b, 1.0) for x in real_values])
    fake_loss = mean([bce_logit_scalar(w * x + b, 0.0) for x in fake_values])
    # The two batch means are summed; this is not one mean over a 2B concatenation.
    return real_loss + fake_loss


def central_difference(fn, value, h=1e-6):
    return (fn(value + h) - fn(value - h)) / (2.0 * h)


z = torch.tensor([-1.0, 1.0], dtype=DTYPE, device=DEVICE)
real = torch.tensor([0.8, 1.2], dtype=DTYPE, device=DEVICE)
G = ScalarGenerator()
D = ScalarDiscriminator()

# --- Discriminator step: hold G fixed and detach fake samples. ---
a0, c0 = f(G.a), f(G.c)
w0, b0 = f(D.w), f(D.b)
fake0 = G(z)
real_logits0 = D(real)
fake_logits0 = D(fake0.detach())
d_real_loss = F.binary_cross_entropy_with_logits(
    real_logits0, torch.ones_like(real_logits0), reduction="mean"
)
d_fake_loss = F.binary_cross_entropy_with_logits(
    fake_logits0, torch.zeros_like(fake_logits0), reduction="mean"
)
d_loss = d_real_loss + d_fake_loss
D.zero_grad(set_to_none=True)
d_loss.backward()
d_grads_torch = {"w": f(D.w.grad), "b": f(D.b.grad)}

# Independent scalar chain-rule derivatives, using only Python math.
real_x = [0.8, 1.2]
z_values = [-1.0, 1.0]
fake_x0 = [a0 * zi + c0 for zi in z_values]
d_dw_manual = mean([
    (sigmoid_scalar(w0 * x + b0) - 1.0) * x for x in real_x
]) + mean([
    sigmoid_scalar(w0 * x + b0) * x for x in fake_x0
])
d_db_manual = mean([
    sigmoid_scalar(w0 * x + b0) - 1.0 for x in real_x
]) + mean([
    sigmoid_scalar(w0 * x + b0) for x in fake_x0
])
d_w_fd = central_difference(lambda w: d_loss_scalar(w, b0, z_values, real_x, a0, c0), w0)
d_b_fd = central_difference(lambda b: d_loss_scalar(w0, b, z_values, real_x, a0, c0), b0)

D_LR = 0.05
d_optimizer = torch.optim.SGD(D.parameters(), lr=D_LR)
d_before = {"w": f(D.w), "b": f(D.b)}
d_optimizer.step()
d_after = {"w": f(D.w), "b": f(D.b)}
d_update_expected = {
    "w": d_before["w"] - D_LR * d_grads_torch["w"],
    "b": d_before["b"] - D_LR * d_grads_torch["b"],
}
g_grads_none_after_d = G.a.grad is None and G.c.grad is None
g_params_after_d = {"a": f(G.a), "c": f(G.c)}
assert g_grads_none_after_d and g_params_after_d == {"a": a0, "c": c0}  # fake detached; G unchanged

# --- Non-saturating generator step: freeze D parameters, but keep its input path. ---
D.zero_grad(set_to_none=True)
for parameter in D.parameters():
    parameter.requires_grad_(False)

G.zero_grad(set_to_none=True)
fake_for_g = G(z)
g_logits = D(fake_for_g)
g_loss = F.binary_cross_entropy_with_logits(
    g_logits, torch.ones_like(g_logits), reduction="mean"
)
g_loss.backward()
g_grads_torch = {"a": f(G.a.grad), "c": f(G.c.grad)}

w1, b1 = f(D.w), f(D.b)
# Independent scalar derivatives with D held fixed at its post-D-step values.
def g_loss_scalar(a, c):
    return mean([
        bce_logit_scalar(w1 * (a * zi + c) + b1, 1.0) for zi in z_values
    ])

sigmoid_errors = [sigmoid_scalar(w1 * (a0 * zi + c0) + b1) - 1.0 for zi in z_values]
g_da_manual = mean([error * w1 * zi for error, zi in zip(sigmoid_errors, z_values)])
g_dc_manual = mean([error * w1 for error in sigmoid_errors])
g_a_fd = central_difference(lambda a: g_loss_scalar(a, c0), a0)
g_c_fd = central_difference(lambda c: g_loss_scalar(a0, c), c0)

G_LR = 0.1
g_optimizer = torch.optim.SGD(G.parameters(), lr=G_LR)
g_before = {"a": f(G.a), "c": f(G.c)}
g_optimizer.step()
g_after = {"a": f(G.a), "c": f(G.c)}
g_update_expected = {
    "a": g_before["a"] - G_LR * g_grads_torch["a"],
    "c": g_before["c"] - G_LR * g_grads_torch["c"],
}
assert D.w.grad is None and D.b.grad is None  # D is frozen, but D(fake) was not no_grad.

# Compare original minimax G objective to the non-saturating objective in logit space.
# Stable forms: log(1 - sigmoid(s)) = -softplus(s); -log(sigmoid(s)) = softplus(-s).
logit_comparison = []
for s in (-8.0, 0.0, 8.0):
    p = sigmoid_scalar(s)
    logit_comparison.append({
        "fake_logit": s,
        "D_probability": p,
        "original_minimax_G_loss_log1_minus_D": -softplus_scalar(s),
        "original_minimax_dloss_dlogit": -p,
        "non_saturating_G_loss_minus_log_D": softplus_scalar(-s),
        "non_saturating_dloss_dlogit": p - 1.0,
    })

checks = {
    "D_manual_chainrule_matches_autograd": all(abs(d_grads_torch[k] - v) < 1e-12 for k, v in {"w": d_dw_manual, "b": d_db_manual}.items()),
    "D_central_difference_matches_manual": abs(d_w_fd - d_dw_manual) < 1e-7 and abs(d_b_fd - d_db_manual) < 1e-7,
    "D_scalar_SGD_updates_match": all(abs(d_after[k] - d_update_expected[k]) < 1e-14 for k in d_after),
    "G_manual_chainrule_matches_autograd": abs(g_grads_torch["a"] - g_da_manual) < 1e-12 and abs(g_grads_torch["c"] - g_dc_manual) < 1e-12,
    "G_central_difference_matches_manual": abs(g_a_fd - g_da_manual) < 1e-7 and abs(g_c_fd - g_dc_manual) < 1e-7,
    "G_scalar_SGD_updates_match": all(abs(g_after[k] - g_update_expected[k]) < 1e-14 for k in g_after),
    "G_gradients_absent_and_params_unchanged_during_D_step": g_grads_none_after_d and g_params_after_d == {"a": a0, "c": c0},
    "D_grad_none_and_unchanged_by_G_step": D.w.grad is None and D.b.grad is None and d_after == {"w": f(D.w), "b": f(D.b)},
}
assert all(checks.values()), checks

result = {
    "scope": "Fixed scalar GAN gradient/update mechanics only; no data training, neural-network image generation, convergence, quality, or benchmark claims.",
    "environment": {"python": platform.python_version(), "torch": torch.__version__, "device": "cpu", "dtype": "float64", "randomness": "none"},
    "inputs": {"z": z.tolist(), "real": real.tolist(), "G_initial": {"a": a0, "c": c0}, "D_initial": {"w": w0, "b": b0}},
    "discriminator_step": {
        "loss_definition": "mean BCEWithLogits(real, 1) + mean BCEWithLogits(fake.detach(), 0)",
        "separate_real_mean": f(d_real_loss), "separate_fake_mean": f(d_fake_loss), "summed_loss": f(d_loss),
        "before": d_before, "grad_autograd": d_grads_torch,
        "grad_manual_chainrule": {"w": d_dw_manual, "b": d_db_manual},
        "grad_central_difference": {"w": d_w_fd, "b": d_b_fd},
        "learning_rate": D_LR, "expected_after": d_update_expected, "actual_after": d_after,
        "G_grads_after_D_step": {"a": None, "c": None},
        "G_parameters_after_D_step": g_params_after_d,
    },
    "generator_step": {
        "loss_definition": "mean BCEWithLogits(D(G(z)), 1), the non-saturating objective; D parameters frozen but forward path differentiable",
        "loss": f(g_loss), "D_fixed_at": {"w": w1, "b": b1},
        "before": g_before, "grad_autograd": g_grads_torch,
        "grad_manual_chainrule": {"a": g_da_manual, "c": g_dc_manual},
        "grad_central_difference": {"a": g_a_fd, "c": g_c_fd},
        "learning_rate": G_LR, "expected_after": g_update_expected, "actual_after": g_after,
        "D_grads_after_G_step": {"w": None, "b": None},
        "D_parameters_after_G_step": {"w": f(D.w), "b": f(D.b)},
    },
    "logit_gradient_comparison": logit_comparison,
    "checks": checks,
}
print(json.dumps(result, indent=2, ensure_ascii=False, allow_nan=False))
跑完後,可以先回答:為什麼 D 階段的 fake 要 detach,而 G 階段不能把整個 D forward 包進 no_grad?為什麼 G 使用的是 D 更新後的 w、b?為什麼 source plot 的 D loss 在 0.693 附近,與本篇兩個 mean 相加的數值不能直接對照?能用上述算式和輸出回答,才把「兩個模型互相學習」落到可檢查的梯度與更新。
在真正專案裡,還要分開看樣本品質、多樣性、與資料的分布差異和評估程序;本篇固定標量、D2L 二維散點與理論最優 D,各自只提供其中一段理解。它們不構成影像 GAN 的訓練完成證明,也不能以一條漂亮 loss 曲線代替對生成結果的檢查。
來源與延伸閱讀
- 原始方法:Goodfellow 等,Generative Adversarial Nets,2014 v1 PDF;arXiv 版本頁。本篇依 §3 的 minimax/non-saturating 目標、Algorithm 1、§4–4.2 的理想化分析;原論文圖像保持連結,未複製論文像素。原 Algorithm 1 可做 k 次 D 更新再做一次 G,本文固定為各一次的標量示範,亦沒有重現原論文的抽樣與 optimizer 設定。
- 圖 1、手機版與封面:Google Developers〈Overview of GAN Structure〉;原 SVG;Google Developers、CC BY 4.0。不採該頁鈔票照片,本次改作為 white render/resize、手機原 loss 框 rotate/resize、封面完整 fit。
- 圖 2、手機版:Mtanti 原作品頁,原英文作者 Mtanti;目前修訂含 Ksarasola 的巴斯克語譯層,本次渲染英文層,CC BY-SA 4.0。手機保留 whole-first、重用原圖細區,變更已列於圖說,不暗示作者背書。
- 圖 3–4:D2L GAN 原章與 PyTorch 教學;固定教材原始碼,四作者 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola,CC BY-SA 4.0。固定 code 用來核方法,保存的圖則另對應 live PyTorch backend,不把不同 framework 畫面算成不同實驗,也不把書籍 grant 擴到資料集角色圖像或外部照片。本文圖 2–4 的改作均維持 SA4;Google BY4 分開適用。
- API:PyTorch 2.3.1 loss.py 與 grad_mode.py。本機安裝版本對應的 BCEWithLogitsLoss、no_grad 原始碼也已核讀,未把較新 API 行為當成本次實跑。
- 本文原創教學是從共享 D、targets、兩種 G 目標與兩階段梯度重組流程,手算固定標量 before/after,並分開解讀教材結果與理論假設。標量原型有真正參數更新;沒有語料或影像資料訓練、完整分布學習、收斂或生成品質 benchmark。讀者可用完整程式核對此有限機制。
留言0
登入後就能留言。
登入