
生成圖片變得清楚了,卻總是少數幾種樣子;或者 G、D 的 loss 都在動,但生成結果一直繞圈。遇到這些情況,該換卷積架構、改成 WGAN,還是增加判別器更新次數?
這三個做法不在解同一個問題。DCGAN 提出一套適合影像 GAN 的卷積架構準則;WGAN 換了比較分布的目標與 critic 的約束;mode collapse 則描述生成分布未能涵蓋目標資料的模式。把它們混成「改用更好的 GAN 就會穩定」,會漏掉每一層方法的前提。
本篇接續生成器與判別器的交替梯度,先看 learned upsampling,再用能手算的 W1 例子辨認 critic score 與距離。最後讀三張特定粒子模型的研究原圖,觀察模式覆蓋與崩塌;這些不是本站重跑的影像 GAN。完整 Python 程式只有有限一維分布與線性 critic 算術,沒有模型訓練、生成影像或 mode-collapse 評測。
DCGAN:把影像生成的空間結構放進網路
原始 GAN 是一個對抗學習框架,沒有規定所有 G/D 都必須用相同網路。2015 年提出、用於 ICLR 2016 論文的 DCGAN,探索的是一組卷積架構設計,讓影像生成與判別能利用空間結構,而不只是把圖片攤平成長向量。
原論文 §3 的五項準則與重要例外可以一起讀:
這裡的 BatchNorm 不是把所有激活變成完整的標準高斯分布,也不是 mode collapse 的萬用解法。原文報告它在該研究設定中幫助深層生成器開始學習,同時也交代直接加在每層會造成不穩定的情況。應連同例外理解這些準則,而不是只抄五條清單。Radford、Metz、Chintala,DCGAN §3 是這段架構說明的依據。
Learned upsampling:transposed convolution 不是逆運算
G 可以先把 noise 投影成小尺寸、多通道的 feature map,再逐層增大空間尺寸,形成影像。Transposed convolution 的 kernel 可以透過梯度學習;這與直接用固定最近鄰或雙線性規則放大,是不同的參數化方式。
先用單通道、無 bias 的小圖看操作。輸入與 kernel 都是 [[0,1],[2,3]],stride=2、padding=0,dilation=1、output_padding=0。每個輸入值乘上整個 kernel,放到由 stride 決定的位置,再把貢獻相加。
例如右下角的輸入 3,乘 kernel 後產生 [[0,3],[6,9]],放在輸出右下區。此例 kernel 尺寸剛好等於 stride,各個 2×2 貢獻區域不重疊;換別的 kernel/stride,可能會在相同輸出位置相加。這次完整輸出為:
[[0, 0, 0, 1],
 [0, 0, 2, 3],
 [0, 2, 0, 3],
 [4, 6, 6, 9]]
在本例的無 padding、dilation=1、output_padding=0 條件下,高度是 (H_in−1)×stride+kernel_size,所以 (2−1)×2+2=4。不能由此推出所有 transposed convolution 都讓尺寸變大,或任意卷積後接相同超參數的 transposed convolution 都能還原原尺寸;stride、padding 與輸出尺寸歧義仍須逐一處理。
「Transposed」指對應線性操作的矩陣轉置,不是矩陣反矩陣。即使形狀回來了,也不等於已取回原數值;下採樣丟掉的資訊不會因名字裡帶 transpose 自動恢復。這張操作圖只用來說明 learned upsampling 的一個構件,原 DCGAN 的完整生成器仍需回到原論文架構閱讀。
WGAN 的 critic 是實數函數,不是機率分類器
在原 GAN 的記法裡,D 常輸出 real 機率;WGAN 改用 real-valued critic f(x),評分可以是負值或大於 1,不在最後用 sigmoid 把它當成真假機率。
但拿掉 sigmoid 不會自動變成 Wasserstein distance。關鍵是允許的函數類別:critic 必須滿足相對指定輸入距離的 1-Lipschitz 條件,並且需要足夠好的最佳化,才接得上 W1 的 dual 表示。
1-Lipschitz:對任意 x、y,|f(x)−f(y)| <= ||x−y||

W1(P,Q) = sup_{f 為1-Lipschitz} [E_P f(x) − E_Q f(x)]
這裡 P 是 real 分布、Q 是生成分布。critic 想把 real-minus-fake gap 拉大;G 則想把 fake 的 critic score 拉高,常見最小化記法為 L_G=−E_fake f(x)。這與前篇的 BCE/non-saturating classification loss 不同。
critic 的絕對基準也不是機率校準:同時加一個常數到 f,real-minus-fake gap 不會變。輸入量尺與 ground distance 會影響 W1 的意義,像素空間的距離亦不能直接當成人眼所有感知差異的完整度量。
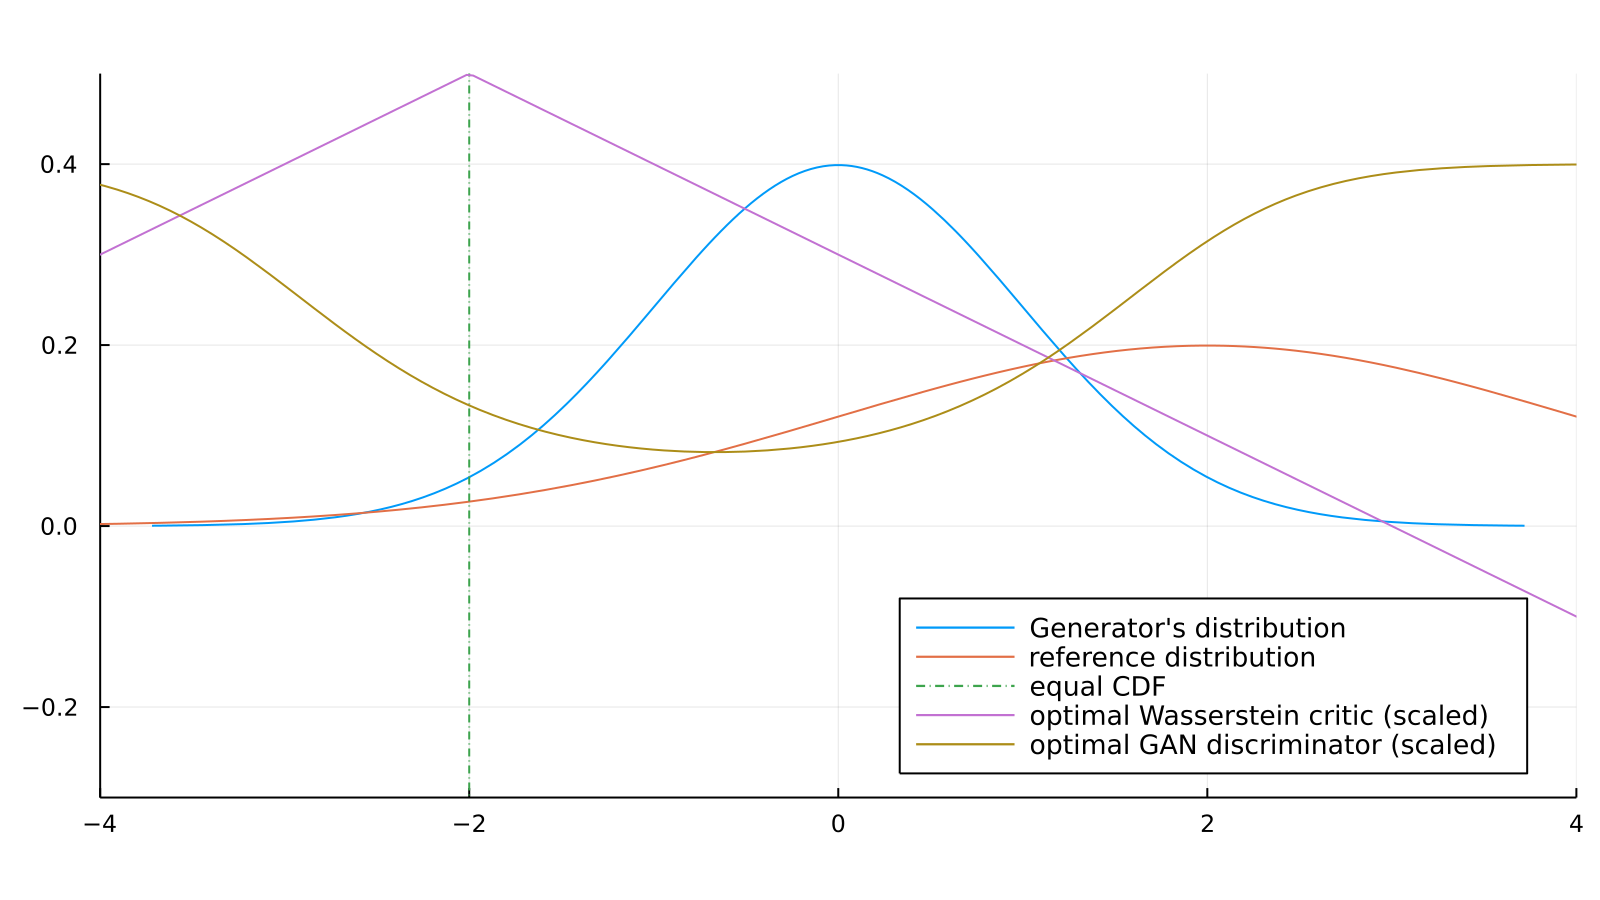
讀這張圖還要留意 critic 的方向。來源程式的紫線是 f(x)=0.5−0.1|x−c|,CDF 交點 c 在這例為 −2,採 generator-minus-reference 的方向;本文用 real-minus-fake 時,要配合相反的 critic 符號理解。它是縮放和平移過的函數形狀示意,不是本文在真實訓練裡得到的 critic,更不能拿它證明 WGAN 已避免 mode collapse。
四個點就能核對:raw critic gap 不一定是 W1
Wasserstein-1 也叫 Earth-Mover distance,可以理解為把一個分布的機率質量搬到另一個分布時,最小的「質量×距離」成本。更精確地說,是在所有具有指定邊際分布的 coupling 中,取期望搬運成本的最小值。
本篇固定一維、絕對距離成本,每個分布兩點各占 1/2:
P = {−1, 1}
Q = { 2, 4}
把排序後的兩點配對,每點搬 3,平均成本就是 3。為什麼已經最小?任意 coupling 都滿足 E|X−Y| >= |E X−E Y|=3,而這個配對恰好達到下界。此例不需要宣稱配對唯一;它只需要一個達到最小成本的可行方案。
一維還可用兩個 CDF 差的絕對值積分,得到相同結果:
端點本身不影響積分,總面積為 3。這裡算的是已知有限分布,不是從少量 GAN loss 反推完整高維資料的距離。
再限制 critic 為 f_w(x)=w·x。它的 Lipschitz constant 恰好是 |w|,而:
E_P[f_w]−E_Q[f_w] = (0−3)w = −3w

有效限制 |w|<=1:最大 gap=3,在 w=−1 達到
違反限制 w=−5:raw gap=15
15 比 3 大,卻不是比較好的距離估計,而是違反了 dual 的函數限制。程式會在步長 0.001 的網格搜尋有效線性 critic;連續範圍的上界則直接由 −3w<=3 看出,不是靠有限網格就證明任意函數已達最優。
對一般網路,即使 critic 合法,它也只給出 dual 的一個候選值;函數容量與最佳化不足,都可能讓它與真正 W1 不同。任意 raw score difference 更沒有自動成為距離的資格。Arjovsky、Chintala、Bottou,WGAN §2–3 提供搬運定義與 1-Lipschitz dual。
Weight clipping 與 gradient penalty:限制是怎麼施加的?
原 WGAN 以 weight clipping,把 critic 參數每次更新後截到一個範圍。對適合的固定架構與受限參數集合,可以得到某個 Lipschitz 上界 K;但 K 依架構及限制而變,並非「把每個 weight 截住,整個網路就精確是 1-Lipschitz」。受限函數族與真正完整的 dual 函數類別也不同。
原論文 Algorithm 1 的預設包括每次 G 更新前做多次 critic 更新(n_critic=5),再以提高 fake score 的方向更新 G。這不是數學保證要剛好五次;更不是只換 loss 名稱、不管 critic 的限制與訓練程度,就能讀到精確 W1。
WGAN-GP 對另一種限制方式提出 soft penalty。用 real x、generated x_tilde,在兩者的直線插值處取點:
ε ~ Uniform[0,1]
x_hat = εx + (1−ε)x_tilde

critic 最小化:
E_fake f(x) − E_real f(x)
  + λ E_x_hat[(||∇_x_hat f(x_hat)||₂−1)²]
這個 gradient 是相對 critic 的輸入 x_hat,不是拿參數梯度 norm 直接代替。若改用最大化 real-minus-fake gap,penalty 要扣掉,符號不能照抄成相加。
有限 λ 會在增加 gap 與減少 penalty 之間取捨,而且只在所抽取的插值點施加 soft penalty;它不是對所有輸入都精確驗過的 1-Lipschitz 證書。原式是對 norm 與 1 的距離做雙側懲罰,也不等於只處罰大於 1 的部分。
WGAN-GP §4 與 Algorithm 1 還說明為什麼沒有直接在 critic 使用 BatchNorm:每筆輸入的梯度限制與跨 batch 樣本耦合並不相同。這也提醒我們,DCGAN 的 BatchNorm 準則不能無條件搬到不同 critic 目標裡。
有限 GP 的反例:最佳化後的斜率仍可超過 1
延續相同 P/Q 與線性 f_w,其輸入梯度就是 w,norm 是 |w|,與插值點無關。因此這個例子的 penalty 不需要真的抽 epsilon;對任何插值點分布取期望,都得到同一值。
採 λ=10,在最大化記法中:
J(w) = −3w − 10(|w|−1)²
在負分支,|w|=−w,令導數 −3−20(w+1)=0,得到 w=−1.15。還可以檢查完整分段:負分支是 3.225−10(w+1.15)²;正分支最大值是 −2.775,接點 J(0)=−10,兩端皆趨負無限,所以此處確是整個線性例子的最大點。
真實 W1 仍是 3。raw gap 3.45 不是距離,扣 penalty 後的 J=3.225 也不是 W1;這個最優線性函數在所有點的斜率都超過 1。它不只說「未抽到的地方可能違規」,甚至在本例的所有插值點都會超過 1,因為有限 soft penalty 容許這種取捨。
這是特別簡化的算術反例,用來否定「有限 GP 等於 exact Lipschitz 限制」的概括;它沒有測試完整 WGAN-GP 的品質、mode collapse 或實際神經網路訓練。原論文 λ=10 的設定,也不能只因為出現在此式裡就變成所有任務的建議超參數。
Mode collapse:看起來合理,卻只覆蓋少數模式
這裡的 mode 指資料分布中的模式或高密度區域,不是模型的 train/eval 模式。若目標有多種樣子,而 G 只產生其中少數類型,即使那些輸出單看很像真的,仍可能沒有涵蓋完整目標分布。它與 VAE 裡「模型忽略 latent」的 posterior collapse 也不是同一個定義。
要觀察這個問題,先看一個明確知道目標有八個模式的例子。Durr、Mroueh、Tu、Wang 在 2023 年的 Effective Dynamics of Generative Adversarial Networks 中,把 G 簡化成輸出空間裡的一群粒子,再用固定 neural tangent kernel(NTK)描述不同粒子更新之間的耦合。這是一個受假設限制的 model GAN,不是把完整 DCGAN/WGAN 影像訓練重跑一次;以下研究圖採該文的粒子更新與正則化設定,也不是前述 WGAN-GP、λ=10 的成效圖。
它的 g₁ 表示粒子自身位置的回應,g₂ 表示不同粒子間耦合。讀者不必先推完整 NTK,只需要看兩件事:粒子能否各自沿局部梯度分散,以及一群粒子是否會受共同訊號拉著一起移動。原論文也明說它採固定 NTK、特定大寬度近似與固定 seeds 的簡化;不能把這些假設當成所有有限網路在訓練中的精確描述。
在這組對角耦合裡,每個粒子沿自己的局部梯度移動,起始雲團可以分裂,逐漸接近多個模式。換成非對角、all-to-all 的耦合後,研究者觀察到另一種行為:
這個差別比「有沒有漂亮的一張樣本」更接近 mode collapse 的核心:一群輸出可能都集中在某個局部,甚至跟著訓練輪流切換擅長的模式,卻沒有同時涵蓋完整分布。這是該 model GAN 的結果,不能推論所有 GAN 都會如此,也不能拿這組圖宣稱換成 WGAN 必然消失。
模式覆蓋的相圖,不是通用調參表
原研究另外掃描耦合比例與判別器每次更新的步數,使用另一組設定:單隱層、寬度 2048 的 ReLU discriminator、200 個粒子、初始雲團標準差 0.1。這不是把前面 2000 粒子的 snapshots 直接拼成同一張統計圖。
其 metric 先將每個粒子分給最近的目標模式,令 Pᵢ 為分到第 i 個模式的比例:
mode-collapse metric = log 8 + ∑ᵢ Pᵢ log Pᵢ
約定 0 log 0 = 0

八個模式各占1/8 → metric=0
全部落在同一模式 → metric=log8≈2.07944
但最近模式的分配比例均衡,不代表粒子真的精確落在目標 Gaussian 的位置與密度上。原研究因此另外檢查目標 log likelihood;只看這張覆蓋相圖仍不夠判斷完整分布擬合。
圖中「增加 n_disc 有助於某些設定離開崩塌區」是此特定動態與指標下的觀察,不是說 discriminator 訓練越久越好,更不是可直接照抄到任何 DCGAN/WGAN 的最佳步數。架構、目標、critic 約束、更新相對速度與資料都會影響判斷。
執行完整一維程式,核對距離與 soft penalty
將下方存為 wasserstein_critic_sanity.py,在已有 Python 3 的環境執行:
python3 wasserstein_critic_sanity.py > stdout.json
保存的實際環境是 Python 3.10.12,只用標準函式庫,不需第三方套件、資料集、模型或網路。程式沒有抽樣、optimizer step 或 GAN 訓練;數值來源全是已列明的有限分布與線性函數。獨立原型核對另以精確有理數、完整分段最優與不同差分步長檢查,範圍仍不包含影像品質或 mode collapse。
預期讀到 W1_sorted_optimal_pairing=3、CDF 面積加總 3、有效 critic 網格最大 w=−1,以及有限 GP 的 w=−1.15、raw gap≈3.45、penalty≈0.225、J=3.225。相同分布的負控制則得到 W1=0。最後浮點幾位依環境判讀,不以微小誤差宣稱理論失效。
"""Finite 1-D W1 and WGAN-GP slope sanity check; no GAN is trained."""
import json


def mean(values):
    return sum(values) / len(values)


def w1_sorted_pairing(p, q):
    """Exact 1-D W1 for equal-weight empirical measures of equal size."""
    if len(p) != len(q) or not p:
        raise ValueError("need equally sized, non-empty empirical measures")
    return mean([abs(x - y) for x, y in zip(sorted(p), sorted(q))])


def w1_cdf_quadrature(p, q):
    """Integrate |F_P-F_Q| exactly over intervals between support points."""
    breaks = sorted(set(p + q))
    area, intervals = 0.0, []
    for left, right in zip(breaks, breaks[1:]):
        mid = (left + right) / 2.0
        f_p = sum(x <= mid for x in p) / len(p)
        f_q = sum(x <= mid for x in q) / len(q)
        part = (right - left) * abs(f_p - f_q)
        intervals.append({"left": left, "right": right, "F_P": f_p, "F_Q": f_q, "area": part})
        area += part
    return area, intervals


def critic_gap(w, p, q):
    return mean([w * x for x in p]) - mean([w * x for x in q])


def gp_objective(w, p, q, penalty_weight):
    penalty = penalty_weight * (abs(w) - 1.0) ** 2
    return critic_gap(w, p, q) - penalty, penalty


def central_difference(fn, x, h=1e-6):
    return (fn(x + h) - fn(x - h)) / (2.0 * h)


def main():
    p, q = [-1.0, 1.0], [2.0, 4.0]  # Equal-weight Q is P translated by +3.
    w1_pairing = w1_sorted_pairing(p, q)
    w1_cdf, cdf_intervals = w1_cdf_quadrature(p, q)

    # Search the full valid linear 1-Lipschitz range on a 0.001 grid.
    bounded_w = [i / 1000.0 for i in range(-1000, 1001)]
    best_w = max(bounded_w, key=lambda w: critic_gap(w, p, q))
    invalid_w, invalid_gap = -5.0, critic_gap(-5.0, p, q)

    # Maximize J(w)=-3w-lambda*(|w|-1)^2. For w<0, dJ/dw=-3-2lambda(w+1).
    lam = 10.0
    w_star = -1.0 - 3.0 / (2.0 * lam)
    gp_value, penalty = gp_objective(w_star, p, q, lam)
    d_manual = -3.0 - 2.0 * lam * (w_star + 1.0)
    d_fd = central_difference(lambda w: gp_objective(w, p, q, lam)[0], w_star)

    # Negative control: identical finite distributions have zero W1.
    p0, q0 = [-1.0, 1.0], [-1.0, 1.0]
    w1_zero_pairing = w1_sorted_pairing(p0, q0)
    w1_zero_cdf, zero_intervals = w1_cdf_quadrature(p0, q0)

    checks = {
        "sorted_pairing_matches_CDF_quadrature": abs(w1_pairing - w1_cdf) < 1e-12,
        "translation_W1_equals_3": abs(w1_pairing - 3.0) < 1e-12,
        "bounded_grid_optimum_attains_W1": best_w == -1.0 and abs(critic_gap(best_w, p, q) - w1_pairing) < 1e-12,
        "unbounded_score_not_W1": invalid_gap == 15.0 and invalid_gap > w1_pairing and abs(invalid_w) > 1.0,
        "GP_stationary_derivative_formula_zero": abs(d_manual) < 1e-12,
        "GP_stationary_derivative_FD_zero": abs(d_fd) < 1e-8,
        "finite_GP_solution_slope_exceeds_1": abs(w_star) > 1.0,
        "identical_distribution_negative_control_zero": w1_zero_pairing == 0.0 and w1_zero_cdf == 0.0,
    }
    assert all(checks.values()), checks

    result = {
        "scope": "Exact finite 1-D distributions, linear critic arithmetic, and WGAN-GP penalty illustration only; no neural network, GAN training, image generation, mode-collapse diagnosis, convergence, quality, or benchmark.",
        "measure_convention": "P and Q each place equal probability on their two listed points; transportation cost is absolute distance on R.",
        "translation_example": {
            "P": p, "Q": q, "translation": 3.0,
            "W1_sorted_optimal_pairing": w1_pairing,
            "W1_integral_abs_CDF_difference": w1_cdf,
            "CDF_interval_contributions": cdf_intervals,
            "linear_critic": "f_w(x)=w*x",
            "critic_gap": "E_P[f_w]-E_Q[f_w]=-3w",
            "valid_1Lipschitz_condition": "|w| <= 1",
            "bounded_grid_max": {"w": best_w, "gap": critic_gap(best_w, p, q), "grid_step": 0.001},
            "invalid_unbounded_example": {"w": invalid_w, "gap": invalid_gap, "why_invalid": "|w|>1 violates the Kantorovich-Rubinstein 1-Lipschitz constraint; this score is not W1."},
        },
        "finite_WGAN_GP_linear_toy": {
            "maximized_objective": "J(w)=-3w-lambda*(|w|-1)^2",
            "lambda": lam,
            "negative_branch": "J(w)=-3w-lambda*(w+1)^2",
            "stationary_formula": "w=-1-3/(2*lambda)",
            "w_stationary": w_star,
            "critic_gap": critic_gap(w_star, p, q),
            "gradient_penalty": penalty,
            "maximized_objective_value": gp_value,
            "sign_reversed_minimized_critic_loss": -gp_value,
            "dJ_dw_manual": d_manual,
            "dJ_dw_central_difference": d_fd,
            "slope_magnitude": abs(w_star),
            "interpretation": "For finite lambda, this sampled-point soft penalty trades critic gap against slope penalty. This linear example has slope 1.15 everywhere; its penalized optimum is not 1-Lipschitz and is not a global Lipschitz certificate.",
        },
        "negative_control": {"P": p0, "Q": q0, "W1_sorted_pairing": w1_zero_pairing, "W1_integral_abs_CDF_difference": w1_zero_cdf, "CDF_interval_contributions": zero_intervals},
        "checks": checks,
    }
    print(json.dumps(result, indent=2, ensure_ascii=False, allow_nan=False))


if __name__ == "__main__":
    main()
讀完可以用三個檢查問題收尾:這次改的是生成器的空間架構,還是 critic 的目標與限制?報告的是合法 dual 下的距離候選,還是未約束的 raw score?展示的樣本是否同時涵蓋目標模式,還是只在少數模式之間移動?
DCGAN、WGAN、WGAN-GP 各自提供了設計與訓練方法;這些方法的名字不會代替資料、約束與評估。把操作小圖、精確一維算術和特定研究動態分開,才能讓圖像幫助理解,而不是讓一張看似有說服力的圖替所有情境下結論。
來源與延伸閱讀
- DCGAN:Radford、Metz、Chintala,2015 v1 PDF;arXiv 版本頁。本篇架構依 §3 的完整段落與例外,不把五條準則改成「所有層加 BN/完全沒有矩陣投影」,亦沒有重刊原論文生成圖或架構像素。
- WGAN:Arjovsky、Chintala、Bottou,2017 v1 PDF;arXiv 版本頁,依 §2–3、Algorithm 1 的 primal/dual、1-Lipschitz、clipping 與 critic 更新。本文不把理想 critic 的分析當有限網路不會 mode collapse 的保證。
- WGAN-GP:Gulrajani 等,Improved Training of Wasserstein GANs,2017 v1 PDF;arXiv 版本頁,依 §2.2–2.3、§3、Algorithm 1、§4 的輸入梯度 penalty 與 sampled interpolants。沒有重刊原paper像素或聲稱重跑其實驗。
- 圖 1:D2L〈Transposed Convolution〉;固定原 SVG,Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola,CC BY-SA 4.0。本篇只用 stride2 的操作圖,不用教材第三方角色影像或生成 sprites。
- 圖 2、封面:Cosmia Nebula 原作品頁,頁內列出 Julia 程式與兩個 Normal 的設定,own work,CC BY-SA 4.0。本篇重述其 scale 與方向範圍,未重跑 Julia 或改動圖線。
- 圖 3–5:Steven Durr、Youssef Mroueh、Yuhai Tu、Shenshen Wang,Effective Dynamics of Generative Adversarial Networks,Phys. Rev. X 13, 041004 (2023),DOI: 10.1103/PhysRevX.13.041004;作者預印本紀錄。本文圖依正式期刊 PDF 的 Figures 3–5,各 caption 無第三方圖像歸屬,按 CC BY 4.0 保留作者、篇名、期刊、DOI 與改作說明;不同設定分開解讀,不以 D2L/Commons 授權替期刊圖清權。D2L/Commons 的 SA4 與期刊 BY4 各自適用,不混標。
- 本文原創教學是將影像架構、分布距離限制、soft penalty 與 mode coverage 分開,核算四點運輸與線性 GP 反例,並逐圖交代研究設定。完整程式沒有訓練;來源 PRX 模擬也沒有在本站重跑,沒有將它當作普通影像 DCGAN/WGAN 的品質排名或通用調參表。
留言0
登入後就能留言。
登入