
模型平均差10分鐘,算不算好?如果永遠猜20分鐘就能做到差8分鐘,複雜模型還沒有證明自己的價值;如果最簡單方法差25分鐘,新模型差10分鐘,才有一個可以進一步檢查的改善起點。
模型評估需要參照。這篇先建立基準,再把模型放進一致的切分與驗證流程,接著讀懂幾種常見診斷曲線,最後從錯誤分布決定下一步。目的不是把所有調參方法試一遍,而是讓每個改動有可檢查的理由。
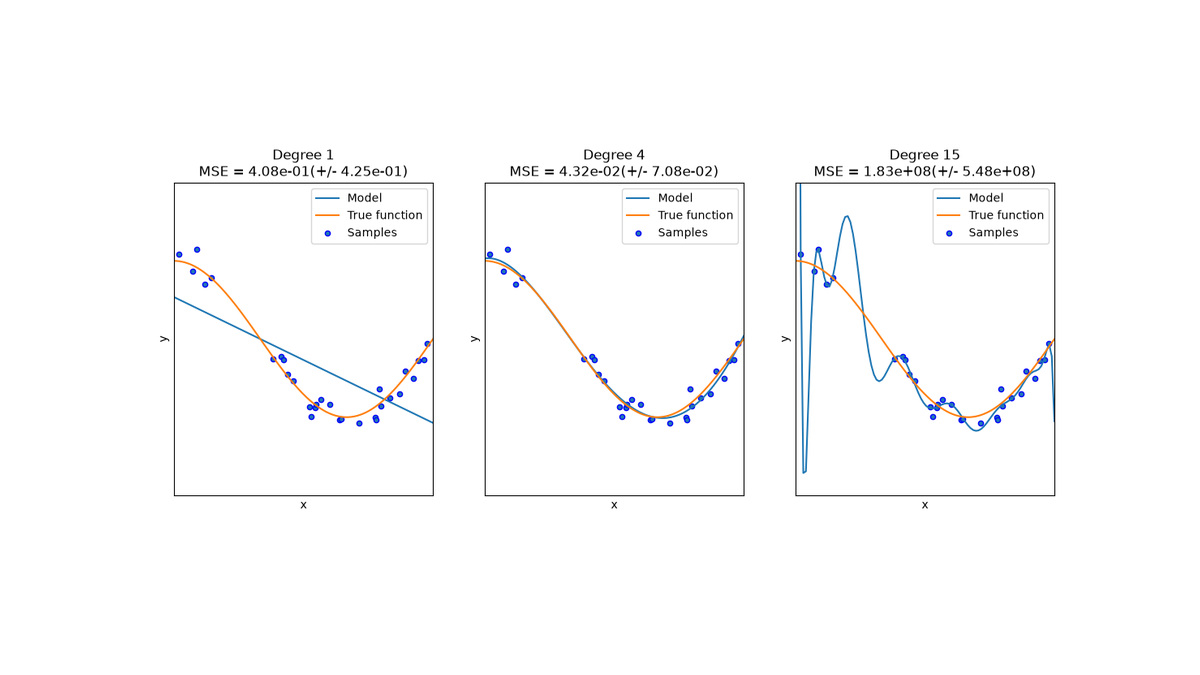
本文配送表與預測數字都是另設的教學算例。配圖採用scikit-learn官方既有圖,包含合成函數、手寫數字與花卉分類,來源實驗沒有由本站重跑。
先建立能真的執行的簡單基準
迴歸問題可以從訓練資料的平均或中位數常數預測開始;分類可以從多數類別或既有業務規則開始;時間序列則可能比較上一期、同星期或季節性參照。基準要符合預測時點,不能先看完整測試答案才決定要猜什麼。
例如訓練資料的配送時間為 [10,10,20,40] 分鐘,平均是20。先把「每一筆新訂單都猜20分鐘」固定為基準,再用四筆保留資料比較:
| 保留訂單 | 真實分鐘 | 固定20分鐘基準 | 另一組示範預測 |
|---|---|---|---|
| A | 15 | 20 | 16 |
| B | 20 | 20 | 21 |
| C | 25 | 20 | 24 |
| D | 60 | 20 | 40 |
基準絕對誤差是5、0、5、40,MAE為12.5分鐘;另一組是1、1、1、20,MAE為5.75分鐘。這裡的另一組預測也是本文直接設定,沒有經過訓練,僅示範比較如何計算。
兩組都在同樣四筆上算,才可以比較這個MAE。若新方法先刪掉最難的D,剩下三筆平均差1分鐘,就不能拿它和基準四筆的12.5直接宣稱改善。
常數基準本身也有目標:均值是平方損失下的自然參照,中位數是絕對損失下的自然參照。這是估計目標的差別,不是說任一種常數預測永遠最佳。
公平比較要把資料、指標和選擇流程一起固定
比較時至少要一致:預測對象與時間、樣本切分、特徵可用性、缺失與排除規則、指標定義。如果同時換資料與模型,分數變化就很難歸因於哪個改動。
模型還有運作成本:建立特徵需要哪些服務、訓練與推論多久、是否能解釋錯誤、資料改變後要怎麼維護。分數稍高但延遲超出服務需求的方案,不一定比較可用。
交叉驗證:比較切分的變動,不把折數當證據倍增器
交叉驗證會輪流保留部分開發資料,讓同一個設定在多個切分下評估。填補、縮放與特徵選擇也必須在每輪訓練資料中擬合,再套用到該輪保留折。
觀察平均分數,也要看各折差異;但不要直接把折間標準差當成通用95%信賴區間。時間、群組與空間資料還要選擇符合部署問題的切分,不能只增加折數,卻保留同一個洩漏設計。
若兩個設定差距很小,應比較同一組切分下的差異、錯誤類型與維護代價,而不是只憑小數點後第三位宣布勝出。大量嘗試設定也會對驗證資料過度適應;最終測試要保留到方案選定後。
欠擬合與過擬合:訓練貼得更近,不代表新資料更準
一個過於受限的模型,可能連主要模式都抓不到;一個太靈活的模型,則可能把抽樣噪聲也當成規律。
實務上可以把訓練與驗證結果當診斷線索。兩邊都差,可能是表示能力不足,也可能是特徵缺少、資料品質、優化失敗或標籤噪聲;訓練很好但驗證差,則可能是過擬合,也可能是兩份資料分布不同。
因此,「兩條曲線長這樣」不是唯一病因的證明。先確認資料與實作,再比較模型容量、正則化、特徵與樣本量,會比只按曲線名稱換演算法更可靠。
偏差與變異:換一批訓練資料,答案會怎麼變?
在平方誤差的相應條件下,期望預測誤差可以拆成偏差平方、變異與不可避免的雜訊。偏差關心平均預測是否偏離要估計的關係;變異關心更換訓練樣本後,預測有多敏感。
這個觀點解釋為什麼平均多個不完全相同的模型,有時能減少變動;不代表任何集成都一定改善。模型若共享相同偏差或錯誤,平均也可能保留問題。
它也不是「模型越複雜,偏差必然按固定速度下降、變異必然按固定速度上升」的萬用圖表。實際行為還受資料、估計器、正則化與訓練方法影響。
驗證曲線:一次改一個設定,看哪裡開始失去平衡
驗證曲線固定資料與其他條件,改一個模型設定,例如正則化強度,分別畫訓練與保留折分數。
若約束太弱,模型可能把噪聲也學進去;若太強,又可能連有用訊號都壓掉。找折衷時,除了最高點,也要看附近設定是否表現接近、是否對切分很敏感。
圖中陰影呈現來源設定的折間變動,不能自動視為精確的信賴區間。選定設定後,仍需按保留流程重訓與評估,不是在同一張圖上挑到最高點就宣布上線成效。
學習曲線:改變訓練樣本數,觀察分數怎麼移動
學習曲線改的是訓練資料量,與剛才改alpha的驗證曲線不同。每個資料量都要重新擬合,並在相應保留資料上評估。
如果驗證表現仍隨樣本數明顯改善,增加相似且有效的資料值得測試;若在目前範圍已接近平台,則可以比較新特徵、模型或資料收集方式。但平台不證明所有新增資料永遠無用:新的群體、標籤品質或不同資料區域,可能改變結果。
小樣本的訓練分數偏高,也不代表部署可靠。資料量、樣本組成、切分與評估波動要一起看,不能只把曲線外推到尚未觀察的數量。
同時看成本曲線,避免多花時間只換到微小改善
成本還包括特徵收集、部署延遲與維護。若只有訓練耗時圖,不能直接推論單筆線上請求的延遲;應針對真實服務方式另外量測。
從平均分數回到錯誤:到底哪些例子出問題?
前面的四筆配送算例中,另一組預測的總絕對誤差23分鐘,有20分鐘來自D。這告訴你可以先追查長時間訂單,卻不能只憑一筆就斷言所有長時間訂單都會被低估。
迴歸可以看殘差的方向、分布與較高分位數,並按城市、時段、距離與資料缺失狀態切片。分類則先看哪些類別互相混淆,再檢查閾值與樣本。
切片後要保留筆數與納入規則。某個城市只有三筆,錯一筆就可能讓比例大幅變動;反覆試幾百種分組再只挑最差的一組,也可能把偶然波動當成穩定問題。
找到錯誤集中處後,回頭看原始資料:標籤是否可靠、輸入是否缺資訊、是否遇到訓練沒涵蓋的情境?人工閱讀少量代表性案例,可以形成下一輪假設;修正後仍要在新的驗證流程中確認,而不是只修到這幾筆都對。
把診斷變成下一個可比較的改動
若錯誤主要來自單位或時間可用性,先修資料;若簡單關係始終表達不出來,再比較特徵與模型容量;若對不同訓練抽樣很敏感,可以測正則化、集成或更多有效資料;若驗證曲線和實際部署不一致,先重新檢查切分情境。
每次改動保留基準、固定比較條件,記下預期會改善哪一種錯誤,以及可能犧牲什麼。最後再用未參與選擇的資料檢查整套方案,讓結果能被下一個人理解與重查。
來源與圖像授權
本篇10組圖片皆取自scikit-learn developers官方教材,依BSD 3-Clause使用;完整條款附於下方,桌機原圖未改,手機編排另註。配送情境與數字另行設計,來源曲線未由本站重跑。
- Cross-validation:開發、模型選擇與最終評估流程。
- Underfitting vs. Overfitting:多項式與餘弦合成示例。
- Single estimator versus bagging:偏差、變異與雜訊分解。
- Effect of model regularization:ElasticNet的alpha與R²驗證曲線。
- Plotting Learning Curves and Checking Models’ Scalability:手寫數字分類的學習與成本曲線。
- Confusion matrix:Iris分類錯誤與逐真實類別正規化。
圖像授權聲明
以下保留scikit-learn原圖完整BSD聲明;原作者沒有為本站背書。
BSD 3-Clause License

Copyright (c) 2007-2026 The scikit-learn developers.
All rights reserved.

Redistribution and use in source and binary forms, with or without
modification, are permitted provided that the following conditions are met:

* Redistributions of source code must retain the above copyright notice, this
  list of conditions and the following disclaimer.

* Redistributions in binary form must reproduce the above copyright notice,
  this list of conditions and the following disclaimer in the documentation
  and/or other materials provided with the distribution.

* Neither the name of the copyright holder nor the names of its
  contributors may be used to endorse or promote products derived from
  this software without specific prior written permission.

THIS SOFTWARE IS PROVIDED BY THE COPYRIGHT HOLDERS AND CONTRIBUTORS "AS IS"
AND ANY EXPRESS OR IMPLIED WARRANTIES, INCLUDING, BUT NOT LIMITED TO, THE
IMPLIED WARRANTIES OF MERCHANTABILITY AND FITNESS FOR A PARTICULAR PURPOSE ARE
DISCLAIMED. IN NO EVENT SHALL THE COPYRIGHT HOLDER OR CONTRIBUTORS BE LIABLE
FOR ANY DIRECT, INDIRECT, INCIDENTAL, SPECIAL, EXEMPLARY, OR CONSEQUENTIAL
DAMAGES (INCLUDING, BUT NOT LIMITED TO, PROCUREMENT OF SUBSTITUTE GOODS OR
SERVICES; LOSS OF USE, DATA, OR PROFITS; OR BUSINESS INTERRUPTION) HOWEVER
CAUSED AND ON ANY THEORY OF LIABILITY, WHETHER IN CONTRACT, STRICT LIABILITY,
OR TORT (INCLUDING NEGLIGENCE OR OTHERWISE) ARISING IN ANY WAY OUT OF THE USE
OF THIS SOFTWARE, EVEN IF ADVISED OF THE POSSIBILITY OF SUCH DAMAGE.
封面取自本文多項式比較原圖,等比縮放並加白邊;手機版將圖3的三個模型、圖6的兩個模型依原順序上下排列,保留原圖標題、座標、圖例與數值。圖6原本共用左側Accuracy刻度,手機上下排列後,第二張仍使用第一張的相同刻度。這些版本沿用原圖署名與BSD條款。
留言0
登入後就能留言。
登入