
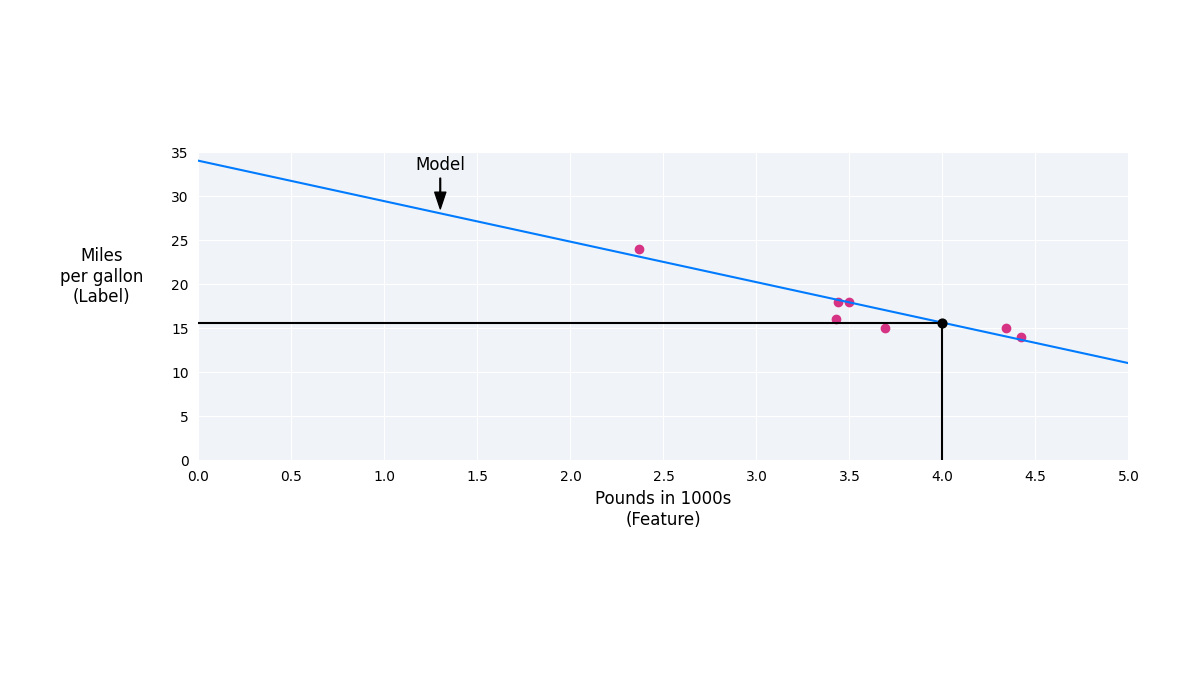
距離越遠,配送通常越久。如果要把這種粗略直覺變成一個能計算的預測,最簡單的起點,是用一條直線把距離和時間接起來。
但資料不會整齊落在直線上:同樣三公里,可能遇到不同路況、備貨速度與配送方式。線性迴歸的工作,是在選定的輸入、資料與損失定義下,估計一組能描述關係的係數。
這篇先讀原教材的散點,再用三筆另設的配送資料算一次最小平方法。之後把結果放回損失、梯度下降與驗證流程,了解「找到一條線」究竟完成了什麼。
散點先說明觀察,不直接替你選出公式
散點讓你看到每個輸入對應的結果、可能的趨勢和偏離。接著才選擇用什麼函數近似它。線性迴歸是其中一個候選,並不是只要有兩欄數字就必須畫直線。
斜率與截距:一個描述變化,一個決定基準位置
單一特徵的線性預測可以寫成:
預測值 = 截距 + 權重 × 特徵
ŷ = b + w×x
w是斜率,描述模型中輸入每增加一個單位,預測增加多少;b是截距,描述輸入為0時,公式給出的結果。機器學習也常把截距叫bias,但這裡不是在說資料偏見或偏差變異分解的同一個概念。
來源教材的示意公式是 ŷ=34−4.6×x,其中 x用千磅。4,000磅要輸入4,預測為15.6英里/加侖;若改用磅當單位,斜率也必須改成−0.0046,不能把4000直接塞進原公式。
用三筆資料,手算一次最小平方法
現在換成本文設計的配送資料。距離單位為公里,時間單位為分鐘;這三筆只用來理解運算,不代表真實配送系統。
我們要找的不是一條逐點穿過所有觀察的線,而是讓殘差平方和最小的直線。對有截距、單特徵且距離不是全部相同的例子,可以先算平均,再算斜率:
x平均 = 2,y平均 = 15

w = Σ[(x−x平均)×(y−y平均)] / Σ[(x−x平均)²]
  = [(-1)×(-3) + 0×2 + 1×1] / [1+0+1]
  = 4/2 = 2

b = y平均 − w×x平均 = 15 − 2×2 = 11
所以 ŷ = 11 + 2×x
這條線對三筆給13、15、17分鐘。它不會把每筆都修到正確,而是在平方損失下取得整體折衷。斜率2的單位是分鐘/公里;截距11是模型基準,不足以單獨認定備貨一定花11分鐘。
殘差保留方向,損失再決定怎麼彙總
這裡把殘差定為「真實值−預測值」。正值代表模型估得太短,負值代表估得太長;有些工具用相反符號,所以要先看定義。
- 12
- 13
- −1
- 1
- 1
- 17
- 15
- 2
- 2
- 4
- 16
- 17
- −1
- 1
- 1
三筆殘差加起來為0,不代表沒有錯誤:正負只是抵消了。MAE先取絕對值,MSE先平方,再各自平均:
MAE = (1+2+1)/3 = 4/3 ≈ 1.333分鐘
MSE = (1+4+1)/3 = 2分鐘²
RMSE = √MSE = √2 ≈ 1.414分鐘
這些是擬合時同一組三筆資料上的結果,不能當成新訂單誤差。用三筆資料算出一個最優解,與證明模型能泛化,是兩件不同的事。
MSE較強調大誤差,MAE對誤差大小採線性懲罰。該用哪個,要看你希望模型怎麼對待尾端錯誤,而不是單純挑數字較小者;兩者定義和單位不同。
用NumPy核對,但不要把求解器當成資料判斷
下列程式可在前面Python/NumPy工具篇的環境執行。資料直接放在程式中,不需要另外下載CSV;每列最前面的1用來估計截距。
import numpy as np

x = np.array([1.0, 2.0, 3.0])
y = np.array([12.0, 17.0, 16.0])
X = np.column_stack([np.ones_like(x), x])
b, w = np.linalg.lstsq(X, y, rcond=None)[0]
pred = b + w * x
residual = y - pred
mae = np.mean(np.abs(residual))
mse = np.mean(residual ** 2)
print("截距與斜率:", round(float(b), 3), round(float(w), 3))
print("預測:", np.round(pred, 3).tolist())
print("MAE、MSE、RMSE:", round(float(mae), 3), round(float(mse), 3), round(float(np.sqrt(mse)), 3))
本次在Python 3.10.12、NumPy 1.26.3的WSL環境執行核對,輸出截距11、斜率2,預測 [13.0,15.0,17.0],三個指標依序為1.333、2.0、1.414。這是實際核對三筆教學算例,沒有重跑原圖的燃油資料實驗。
lstsq求的是最小平方意義下的解;它不會替你判斷欄位是否洩漏答案、樣本是否代表未來,或線性關係是否足夠。多特徵高度相依時,係數還可能不唯一或很不穩定。數值求解成功不能替代這些檢查。
不只一個特徵時,仍然是加權和
配送時間也可能和件數、時段或配送方式有關。把每個可用特徵乘上自己的權重再相加,就是多元線性迴歸:
ŷ = b + w₁×距離 + w₂×件數 + w₃×某個時段指標 + …
類別欄需要先採適當表示;各特徵要符合預測時點。某個係數的意義,是在這個模型中其他輸入固定時,該特徵增加一單位所對應的預測變化,不是自動得到因果效果。
線性通常指對待估係數是線性的。加入距離平方、交互作用等已定義特徵後,仍可用線性係數組合,曲線形狀卻可以更複雜。是否增加這些特徵,要放進驗證流程比較,不能只因訓練誤差降低就認定有效。
梯度下降是另一條求解路徑
剛才用最小平方法求解器取得係數;也可以反覆計算損失與梯度,一小步一小步更新。同一個平方損失目標,不只一種求解方式。
若把損失定為平均平方誤差:
L(w,b) = (1/n) Σ(w×xᵢ+b−yᵢ)²
∂L/∂w = (2/n) Σ(w×xᵢ+b−yᵢ)×xᵢ
∂L/∂b = (2/n) Σ(w×xᵢ+b−yᵢ)

新w = 舊w − 學習率×∂L/∂w
新b = 舊b − 學習率×∂L/∂b
兩個梯度都用同一組目前參數計算,再一起更新。若損失多乘一個1/2,梯度係數也會跟著變,不能在不同定義間混用數值。
來源燃油例在權重與截距都為0時,兩個梯度約−119.7與−34.3;學習率0.01的第一步,兩者會往正方向增加。最後學到負斜率,不表示每一步都把權重往負方向推。方向要依當下的完整參數與損失判斷。
參數更新、模型直線與損失曲線,要一起看
學習率太大,即使目前方向是局部下降方向,一步跨太遠仍可能讓損失增加或發散;太小則可能進展很慢。曲線變平也可能受尺度或停止條件影響,不能只靠外觀宣布找到了可部署的模型。
凸性讓我們能談全域最小值,但梯度法仍需要合適的步長等條件;特徵相依時最優係數也不一定唯一。訓練目標較低,沒有同時證明資料品質、預測效用或因果關係。
最後回到資料:直線在哪些範圍值得相信?
本文三筆距離只涵蓋1到3公里。把10公里直接代進 11+2x 可以算出31分鐘,卻是在觀察範圍外外推;路況與配送流程可能完全不同。
應用時要用符合時間與群組情境的保留資料評估,並檢查殘差在距離、時段和城市中是否有系統性模式。若模型在長距離總是低估,可能是關係形狀不對、缺少特徵,或訓練樣本未涵蓋;不是把所有殘差叫作噪聲就算交代。
要計算係數的信賴區間或做統計推論,還需要釐清誤差結構、相依性與推論方法。資料與殘差不必為了「看起來像線性迴歸」就硬變成常態;會影響推論的假設,與能否先算出最小平方法解,是不同層次。
線性迴歸的價值,是把輸入如何轉成輸出、誤差如何衡量、係數如何估計說清楚。它既可以是簡單基準,也可以是適合問題的最終方案,前提是驗證支持這個選擇。
來源與圖像授權
- Google,Linear regression:散點、線性公式、單位與多特徵。
- Google,Linear regression: Loss:殘差視覺與MAE/MSE比較。
- Google,Linear regression: Gradient descent:迭代流程、快照與凸損失面。
- NumPy,numpy.linalg.lstsq:最小平方求解與多解時的最小範數選擇。本文範例使用的版本另在執行說明標示。
本篇15組教材圖屬Google原頁所選自製示意,依CC BY 4.0再利用,保留逐圖出處與署名,見Google網站政策。來源曲線與燃油資料結果未由本站重跑;本文只另行擬合並核對三筆合成配送資料。
封面沿用本篇 Google 原圖,僅等比縮放並加白邊保留全圖,依原圖相同 CC BY 4.0 條件使用。
手機版圖11–13將各張原圖的左側損失曲線與右側模型快照依序改為上下排列,保留完整座標、資料點與圖例;原本跨圖的虛線在分割處斷開,上下兩圖仍代表同一時刻。原圖由 Google 提供,依 CC BY 4.0 改作。
留言0
登入後就能留言。
登入