
有兩個配送方案,平均時間都是 20 分鐘,你會覺得它們一樣嗎?
先把五張訂單的時間攤開看:
| 教學方案 | 五筆配送時間,單位:分鐘 | 平均 | 中位數 |
|---|---|---|---|
| A | 10、10、10、10、60 | 20 | 10 |
| B | 20、20、20、20、20 | 20 | 20 |
方案 A 的多數人很快收到,但有一個人等了一小時;方案 B 則每個人都等 20 分鐘。對排班的人、要趕時間的顧客,以及處理客訴的團隊來說,這不是同一件事。
這些都是本文另設的教學數據,不代表真實物流表現。它們只用來指出:平均值算對了,也可能還沒回答真正的問題。 要知道資料怎麼散開、結論能推多遠,以及一個預警該怎麼解讀,還需要分布、抽樣與機率。
平均值把資料壓成一個數字,分布把差異攤開
平均值是總和除以筆數;中位數則是排序後位在中央的值。前面的兩組資料總和都是 100,因此平均同為 20,但中央位置與極端值很不同。
如果你要預估總工時,平均值可能有用;若要知道典型顧客等多久,中位數可以補充;若要訂出服務承諾,還需要看較高分位數與超時比例。沒有一個摘要可以代替全部問題。
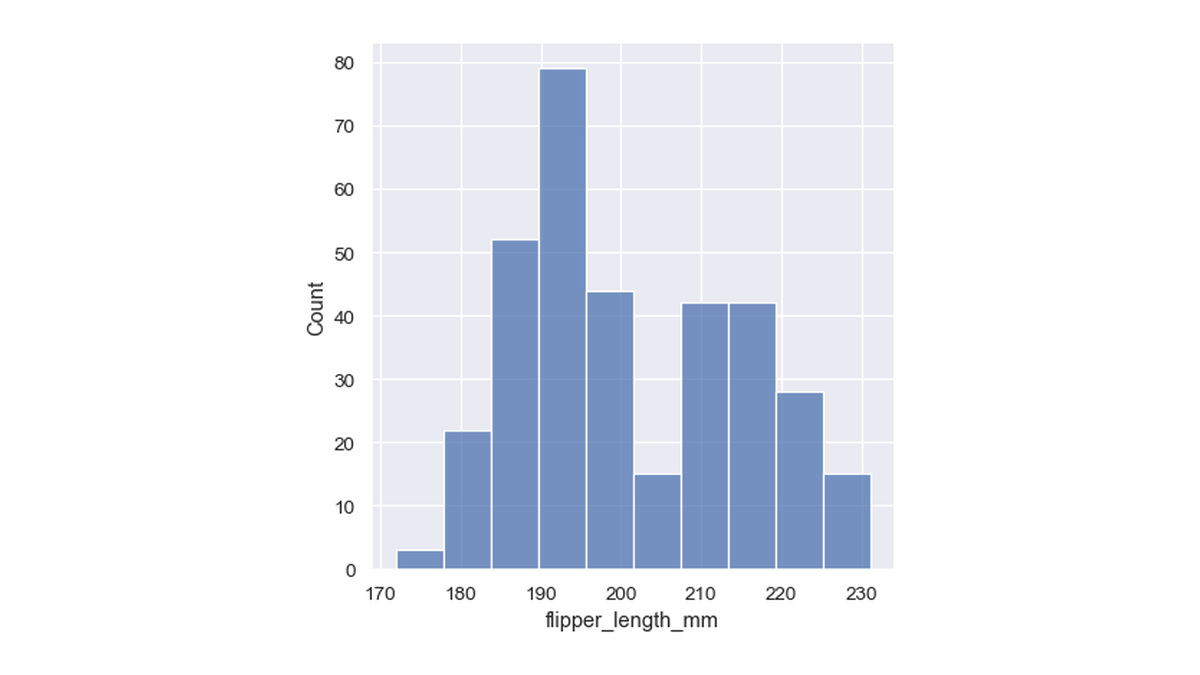
當資料有幾百筆、幾萬筆時,先看直方圖,往往比盯著一串平均值更容易發現差異。
直方圖把數值切成區間,再計算每個區間有幾筆。橫軸說明「值在哪裡」,縱軸在這張圖上說明「有幾筆」。看圖之前,先把變數、單位和縱軸的定義讀清楚。
同一批資料,分箱改了,看起來也會變
假設把配送時間每 5 分鐘分一箱,和每 30 分鐘分一箱,看到的細節就不一樣。箱子太寬,可能把不同群體混在一起;太窄,則可能把有限樣本的零碎起伏放大。
所以,看到一個小尖峰時,先問它是否在合理的分箱設定下仍然存在。接著再按城市、倉庫或時段切開,看看是不是不同群體混合的結果。光憑兩個尖峰,還不能斷言背後剛好有兩種原因。
平滑曲線也是一種估計,不是資料真正的外形
除了柱子,你也常看到一條平滑曲線。核密度估計(kernel density estimation,KDE)會用平滑的方式估計密度,方便觀察整體形狀。
平滑程度由帶寬等設定控制。帶寬較小,細節多,但也容易把噪音當結構;帶寬較大,圖形平順,卻可能抹掉值得追查的差異。
這些圖回答的是「這批資料長什麼樣」。下一個問題則是:這批資料能代表你關心的整體嗎?
手上的樣本,不會自動等於你想了解的母體
母體是你想對它做判斷的整體;樣本是實際取得的那一部分。想了解下個月所有訂單,只分析上週幾百筆,便需要思考兩者是否足夠相近。
有兩種不同的問題,常被一起塞進「資料不夠多」:
- 抽樣波動:即使抽樣方式合理,換一批樣本,平均時間或超時比例仍可能改變。
- 選樣偏差:例如資料只包含平日上午、特定城市,或已經完成的訂單,漏掉了另一種情況。
假設一張報表只收進「已完成配送」的訂單,還在路上、可能等最久的訂單都不在分母裡。這時看到較短的平均時間,可能只是資料納入規則造成的。多收同樣規則下的資料,並不會自動補回被排除的部分。
為什麼多抽幾次,估計通常比較穩?
先離開複雜的訂單情境,想像一枚公平硬幣。假設每次擲出正面的機率都是 0.5,而且各次結果彼此獨立。
只丟兩次,正面比例可能是 0、0.5 或 1;丟得更多時,累積比例通常會比較靠近真正的機率。注意「通常」的意思:下一次結果仍然可能讓估計暫時離 0.5 更遠。
在上述獨立、同機率的二元試驗模型下,樣本比例的標準差為:
樣本比例的標準差 = sqrt(p × (1 − p) / n)
p:真實事件機率
n:獨立樣本數
若 p = 0.5,100 次試驗得到的樣本比例,其標準差是 0.05;10,000 次則是 0.005。這個標準差衡量重複抽樣時估計值的波動,也稱此估計量的標準誤。
| 在相同簡化假設下 | 樣本數 | 樣本比例的標準誤 |
|---|---|---|
| 公平硬幣 | 100 | 0.05,也就是 5 個百分點 |
| 公平硬幣 | 10,000 | 0.005,也就是 0.5 個百分點 |
樣本增加 100 倍,標準誤縮成十分之一,不是百分之一。這是平方根關係。
真實資料可能有相關性:同一場大雨影響許多訂單,同一位顧客也可能連續下單。這些資料不一定等同於同數量的獨立觀測。實際計算不確定性時,必須考慮抽樣與資料結構,不能直接把上表公式套上去。
NIST 對信賴區間的說明也從重複抽樣來理解:一個標稱 95% 的信賴區間方法,是在它的假設成立時,長期重複使用約有 95% 的區間涵蓋真實參數。它不是對某一筆訂單的交付保證,也不替有偏的樣本提供免責。
預警能抓到八成延遲,為什麼收到預警不代表八成會延遲?
現在回到一個具體判斷。假設某個預警系統能標出八成的延遲訂單。收到預警之後,你能直接說「這張訂單有 80% 機率延遲」嗎?
還不能。前一句從真正延遲的訂單出發,問其中有多少被標出;後一句則從被標出的訂單出發,問其中有多少真的延遲。兩者的分母不同。
先讀一張原作者的數學示例。它的全集用 Ω 表示,裡面有事件 A,以及互不重疊的 B₁、B₂、B₃;也有不屬於這三個 B 事件的區域。標示的數字是各區域的機率,全部加起來等於1。這張圖不使用本文後面的訂單數值。
「已知 A」時,觀察範圍只剩 A 裡面的情況。如果想問其中有多少同時屬於 B₂,分子是交集0.12,分母則是 A 的0.52。
但「已知 B₂」問的是另一個分母。現在把注意力移到 B₂ 的完整圓內,裡面有0.12與0.04兩塊,所以分母變成0.16。
最後,只看兩者的交集,分子仍然是0.12。於是反過來的條件機率為:
P(A | B₂) = P(A ∩ B₂) / P(B₂) = 0.12 / 0.16 = 75%
回到配送情境,我們另外把 A 定義為「訂單延遲」,B 定義為「系統發出預警」。抓到八成延遲,說的是 P(B | A)=0.8;顧客收到預警時想問的,卻是 P(A | B)。下面重新設定一份訂單算例,不沿用上圖的0.52、0.16或75%。
用10,000張假想訂單,把分母算一次
為了把差別算清楚,假設在同一個觀察範圍內:
- 共有 10,000 張訂單,其中 10% 真正延遲。
- 在真正延遲的訂單中,80% 會收到預警。
- 在沒有延遲的訂單中,10% 也會收到預警。
這些比例是教學設定,沒有代表某個真實模型的效能。
| 實際結果 | 收到預警 B | 沒收到預警 | 合計 |
|---|---|---|---|
| 延遲 A | 800 | 200 | 1,000 |
| 沒有延遲 | 900 | 8,100 | 9,000 |
| 合計 | 1,700 | 8,300 | 10,000 |
現在只看收到預警的 1,700 張,其中真正延遲的是 800 張:
P(延遲 | 收到預警) = 800 / 1,700 ≈ 47.1%
分母除了包含抓對的 800 張,也包含誤報的 900 張。抓到八成延遲,仍可能讓收到預警的人有一半左右最後沒有延遲。
貝氏定理把同一個計數關係寫成一般形式:
P(A | B) = P(B | A) × P(A) / P(B)

本例 P(B) = 0.8 × 0.1 + 0.1 × 0.9 = 0.17
所以 P(A | B) = 0.8 × 0.1 / 0.17 ≈ 0.471
其中 P(A) 是延遲原本有多常見,也就是這個觀察範圍內的基率。若延遲比例改成 1%,而上述兩個條件預警率假設仍維持不變,10,000 張訂單會有 80 張抓對、990 張誤報;收到預警後真正延遲的比例就變成 80 / 1,070 ≈ 7.5%。
這是基率改變下的條件計算,不是說任何真實模型換城市後,都一定維持相同的抓取率和誤報率。實際上,它們也可能一起改變,所以必須重新評估。
看一份資料報告時,依序追問這些事
讀到「平均配送20分鐘」,先要分布、較高分位數和超時比例,確認少數長時間訂單是否被藏起來。
讀到「分析了十萬筆」,先問十萬筆是怎麼納入的:是否涵蓋你要使用的城市和時段?尚未完成的訂單有沒有消失?觀測之間是否高度相關?
讀到「預警能抓到八成」,先確認這八成的分母,再問誤報多少、延遲基率多少。只有把這些條件一起放回來,才知道這個數字對收到通知的人代表什麼。
下一次打開資料時,可以先完成一個小動作:在每個比例旁邊寫出「分子是誰、分母是誰」,在每個平均值旁邊寫出「哪些資料被納入、哪些沒被納入」。這會讓很多看似漂亮的結論,變成可以進一步檢查的問題。
來源與延伸閱讀
- Seaborn,Visualizing distributions of data:直方圖、分箱與 KDE 原圖及限制。
- Dive into Deep Learning,Probability and Statistics:公平硬幣的累積頻率模擬、條件機率與統計觀點。圖 5 維持原作者結果。
- Gnathan87,Conditional probability.svg:原始機率集合圖,依CC0再利用,圖7–9僅在原圖的現有形狀著色,保留全貌與數值。
- Seaborn原圖保留Michael Waskom及開發者著作權,依BSD 3-Clause完整條款再利用;D2L圖依CC BY-SA 4.0再利用,原圖未改。
本文配送方案與預警數表均為另設的教學算例,與原圖資料集分開;未使用企業訂單,也未宣稱完成模型驗證。
圖像授權聲明
以下保留本篇Seaborn原圖所附BSD條款、著作權與免責聲明。這不表示原作者為本站內容背書。
Copyright (c) 2012-2023, Michael L. Waskom
All rights reserved.

Redistribution and use in source and binary forms, with or without
modification, are permitted provided that the following conditions are met:

* Redistributions of source code must retain the above copyright notice, this
  list of conditions and the following disclaimer.

* Redistributions in binary form must reproduce the above copyright notice,
  this list of conditions and the following disclaimer in the documentation
  and/or other materials provided with the distribution.

* Neither the name of the project nor the names of its
  contributors may be used to endorse or promote products derived from
  this software without specific prior written permission.

THIS SOFTWARE IS PROVIDED BY THE COPYRIGHT HOLDERS AND CONTRIBUTORS "AS IS"
AND ANY EXPRESS OR IMPLIED WARRANTIES, INCLUDING, BUT NOT LIMITED TO, THE
IMPLIED WARRANTIES OF MERCHANTABILITY AND FITNESS FOR A PARTICULAR PURPOSE ARE
DISCLAIMED. IN NO EVENT SHALL THE COPYRIGHT HOLDER OR CONTRIBUTORS BE LIABLE
FOR ANY DIRECT, INDIRECT, INCIDENTAL, SPECIAL, EXEMPLARY, OR CONSEQUENTIAL
DAMAGES (INCLUDING, BUT NOT LIMITED TO, PROCUREMENT OF SUBSTITUTE GOODS OR
SERVICES; LOSS OF USE, DATA, OR PROFITS; OR BUSINESS INTERRUPTION) HOWEVER
CAUSED AND ON ANY THEORY OF LIABILITY, WHETHER IN CONTRACT, STRICT LIABILITY,
OR TORT (INCLUDING NEGLIGENCE OR OTHERWISE) ARISING IN ANY WAY OUT OF THE USE
OF THIS SOFTWARE, EVEN IF ADVISED OF THE POSSIBILITY OF SUCH DAMAGE.
封面沿用本篇已註明來源的配圖,僅等比縮放並加白邊以保留全圖;圖片原有的署名與授權條件同樣適用於封面版本。
留言0
登入後就能留言。
登入