
模型文件常把一整張資料表寫成一個 X,再接上 w、b 與一個倒三角符號。看不懂時,很容易以為必須先把大學數學重讀一遍,才能開始學機器學習。
這篇先處理你最常需要的能力:辨認資料的形狀、把幾個特徵合成一次預測,以及知道模型為什麼沿某個方向更新。讀完後,再看到 Xw + b 或「沿負梯度更新」,你應該能把它們還原成具體運算。
本文訂單、權重與更新數值都是教學設定,沒有代表一個實際配送模型。來源圖片則保留各教材自己的例子;兩者會分開說明。
一個數、一列數、一張表:先看資料怎麼組織
假設一張訂單有兩個已知特徵:配送距離3公里、待處理商品2件。把這兩個數排成 [3, 2],就是一個有兩個分量的向量;單獨拿出距離3,則是一個純量。
現在增加第二張訂單:距離5公里、商品1件。如果我們約定每列是一張訂單、每欄是一種特徵,就得到矩陣:
X = [[3, 2],
     [5, 1]]

第0欄:距離(公里)
第1欄:商品件數
形狀:(2, 2),即2筆樣本、每筆2個特徵
形狀描述大小,欄位定義描述意義。兩張表都是2×2,卻可能一張是距離與件數,另一張是年齡與收入。不能因為形狀一致,就把它們當成同一種輸入。
NumPy另有一個容易混淆的地方:np.array([3, 2]) 的形狀是 (2,),只有一個軸。數學書畫成橫向,不代表它在程式裡就自動成為 (1, 2) 的二維列向量。需要二維列或欄時,要明確建立 (1, 2) 或 (2, 1)。
三維以上通常統稱多維陣列,機器學習也常稱張量。名稱本身不告訴你每個軸的意義;影像可能是高度×寬度×色彩通道,序列可能是樣本×時間×特徵,必須回到資料規格確認。
點積:把一筆特徵與一組權重配對相加
先假設一個極簡配送公式:每公里增加4分鐘、每件商品增加1.5分鐘,另外有10分鐘固定準備時間。
特徵 x = [3, 2]
權重 w = [4, 1.5]
固定項 b = 10

x與w的點積 = 3×4 + 2×1.5 = 15
預測時間 = 15 + 10 = 25分鐘
點積是把對應分量相乘後加總。這裡每一項相乘的結果都是分鐘,才有相加的意義。權重4的單位可以理解為分鐘/公里;不是因為數字較大,就能跨不同單位斷言距離「比較重要」。
固定項也叫偏置或截距。當距離與件數都為0時,這個公式仍給10;這只是公式的外推結果,未必是一張現實中存在的訂單。
矩陣乘法:一次替多筆資料算加權結果
把兩張訂單一起交給同一組權重:
X形狀:(2, 2)
w形狀:(2,)

X @ w = [3×4 + 2×1.5,
         5×4 + 1×1.5]
      = [15, 21.5]

再加b = 10,得到[25, 31.5]分鐘
@ 是NumPy的矩陣乘法運算子;在這個二維矩陣乘一維向量的例子,結果是一維、每筆一個值。若改把 w 建成 (2, 1),結果則是 (2, 1)。值可以相同,形狀仍不同。
一般二維矩陣 (n, d) @ (d, k) 會得到 (n, k)。中間的 d 必須對得上,因為每個輸出都需要配對相乘並加總。k 可以代表多個輸出,但只有形狀相容還不夠:特徵的欄位順序也必須一致。
逐元素乘法與矩陣乘法會做出不同答案。 看同一個3×3、全部為1的矩陣:
這個例子也說明為什麼只看輸出形狀不夠:兩種運算都得到3×3,內容與意義卻不同。
轉置與reshape:交換軸,和重排元素分組
轉置會交換軸。以來源教材的 a=[[1,2,3],[4,5,6]] 為例,形狀是2×3;轉置後,原本同一欄的1、4成為第一列,接著是2、5與3、6。
如果先把它展平為 [1,2,3,4,5,6],再用預設順序reshape成3×2,得到的則是 [[1,2],[3,4],[5,6]]。它與轉置形狀相同,位置不同。
圖像或序列資料尤其不能為了消除錯誤訊息,就隨便reshape成能執行的形狀。要先確認樣本、時間、通道與特徵各是哪個軸。
導數:在目前位置,往右一點會變多少?
有了預測公式,接著要回答「權重怎麼調」。這需要知道:參數稍微改變時,損失會往哪個方向變化。
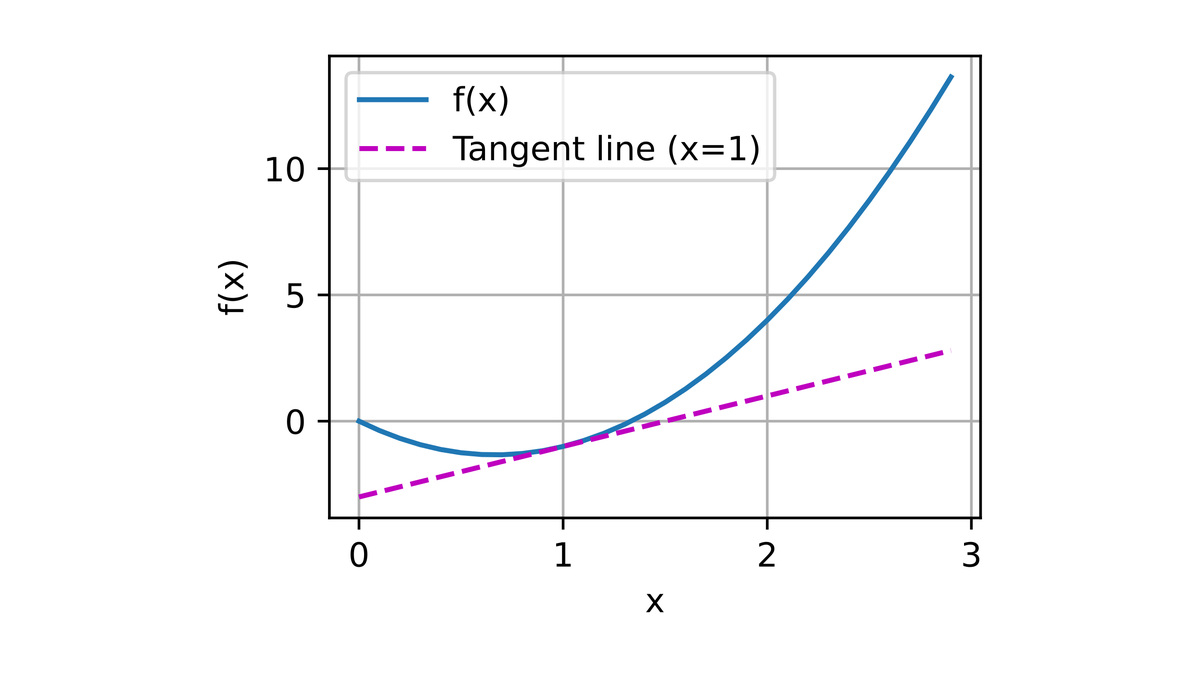
先看一個只有單一變數的函數。導數描述某個位置的局部變化率;在曲線上,就是切線的斜率。
若導數是正,在足夠小的鄰域往右增加輸入,函數通常會增加;要降低函數值,則考慮往左。導數是負時方向相反。這種局部判斷需要足夠小的步長;一步跨太遠,就可能跨過谷底。
模型的損失會同時依賴許多權重。每次只看一個參數、暫時固定其他參數,得到偏導數;把這些偏導數按參數順序排起來,就是梯度。對可微函數而言,在梯度非零的位置,梯度指出在目前座標與歐氏距離下最快增加的局部方向,負梯度則指向局部下降方向。
算一次更新:方向正確,仍要選對步長
用一個與配送無關的簡化損失,直接把數字算清楚:
L(w) = (w − 3)²
導數 = 2(w − 3)
起點 w = 0,損失為9,導數為−6

更新:新w = 舊w − 學習率 × 導數
學習率選0.1:新w = 0 − 0.1×(−6) = 0.6
新損失 = (0.6−3)² = 5.76
導數為負,減去負數讓 w 增加,朝谷底3移動。再算一次,導數是−4.8,新 w=1.08,損失降至3.6864。
但若第一步的學習率改成1.2,新 w=7.2,損失反而變成17.64,比起點更差。方向是局部建議,學習率決定走多遠;「用了梯度下降」本身不保證每一步都下降。
多參數時對整組權重使用相同形式:先用目前參數計算損失與梯度,再更新參數,而不是依序拿剛改過的某個權重混入同一輪梯度計算。
損失曲線告訴你優化進度,還要另看新資料表現
訓練時常把每一輪損失畫成曲線。早期下降很快、後面逐漸變平,是一種可能的收斂形狀。
曲線變平可能因為接近某個穩定區域,也可能是學習率太小、梯度很小,或實作有問題。你需要搭配參數更新幅度、梯度與驗證資料表現判斷,不能只看線條平不平。
對線性預測搭配平方損失的問題,損失對參數是凸函數;在合適的步長等條件下,可以收斂到全域最小值,解不一定唯一。換成一般神經網路,損失通常不凸,不能保證找到全域最佳。即使把訓練損失壓得很低,也仍要用未參與訓練的資料檢查泛化。
這也是這些數學工具各自的工作:矩陣讓你一次組織多筆輸入與預測;損失說明你要降低什麼;梯度與學習率決定怎麼更新。它們幫你描述與優化模型,資料代表性、評估設計與實際效用仍要另外處理。
回到自己的資料,先做三個檢查
看到 Xw+b,寫下 X 每個軸與每一欄的意義,確認權重的順序和單位;不要只檢查乘法能不能執行。
看到 *、@、.T 或 reshape,先用兩三個數算出期望結果,確認它在做逐項計算、配對加總、交換軸,還是重排分組。
看到「模型已收斂」,追問是哪個損失、在哪份資料、用什麼停止條件。優化完成的說法,不能直接替代新資料上的驗證。
來源與圖像授權
- NumPy,matmul:一維、二維及批次矩陣乘法的形狀規則。
- Scientific Python Lectures,Numerical operations on arrays:圖1–5原頁程式輸出,依CC BY 4.0引用並裁去空白,未改原例數值。
- Dive into Deep Learning,Calculus:圖6及微分觀點。該圖著作權屬Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola,依CC BY-SA 4.0使用;原圖及對該圖的改作遵守相同授權。
- Google,Linear regression: Gradient descent:圖7–9教材自製示意,依CC BY 4.0使用,見網站政策。本文將步長與泛化條件另行說明,沒有沿用「任何步長都能找到最佳解」的無條件說法。
訂單權重與一維更新是本文設計並算術核對的教學例子;本文未訓練配送模型,也未重跑來源教材的車輛資料實驗。
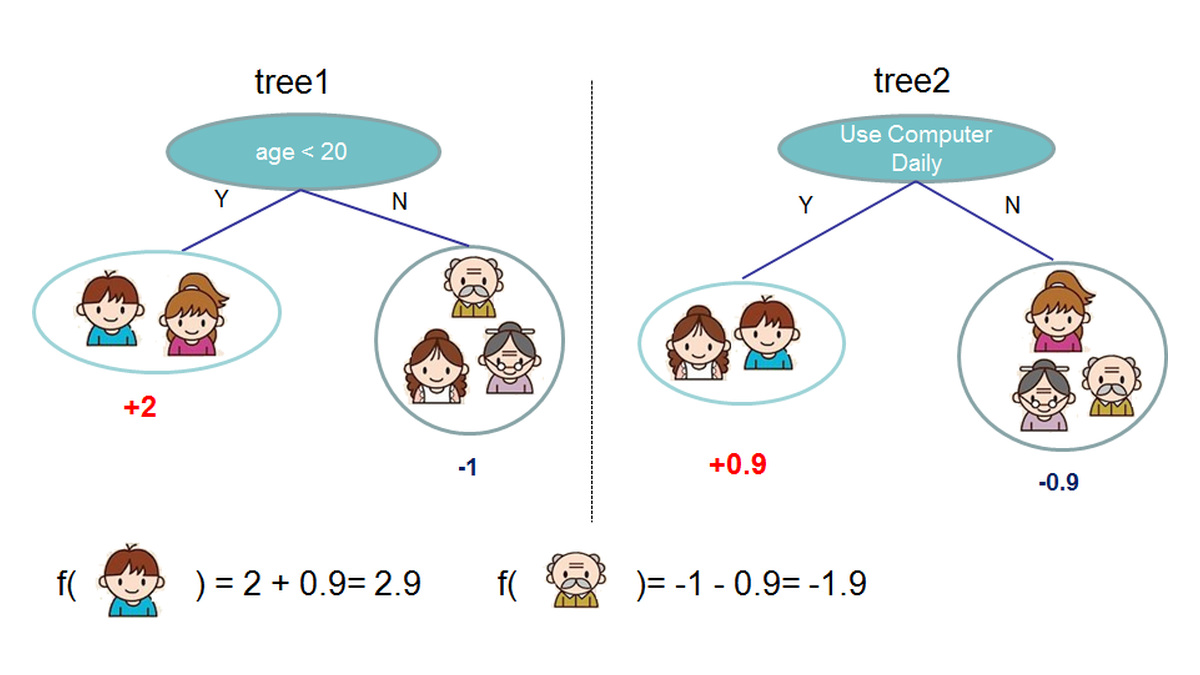
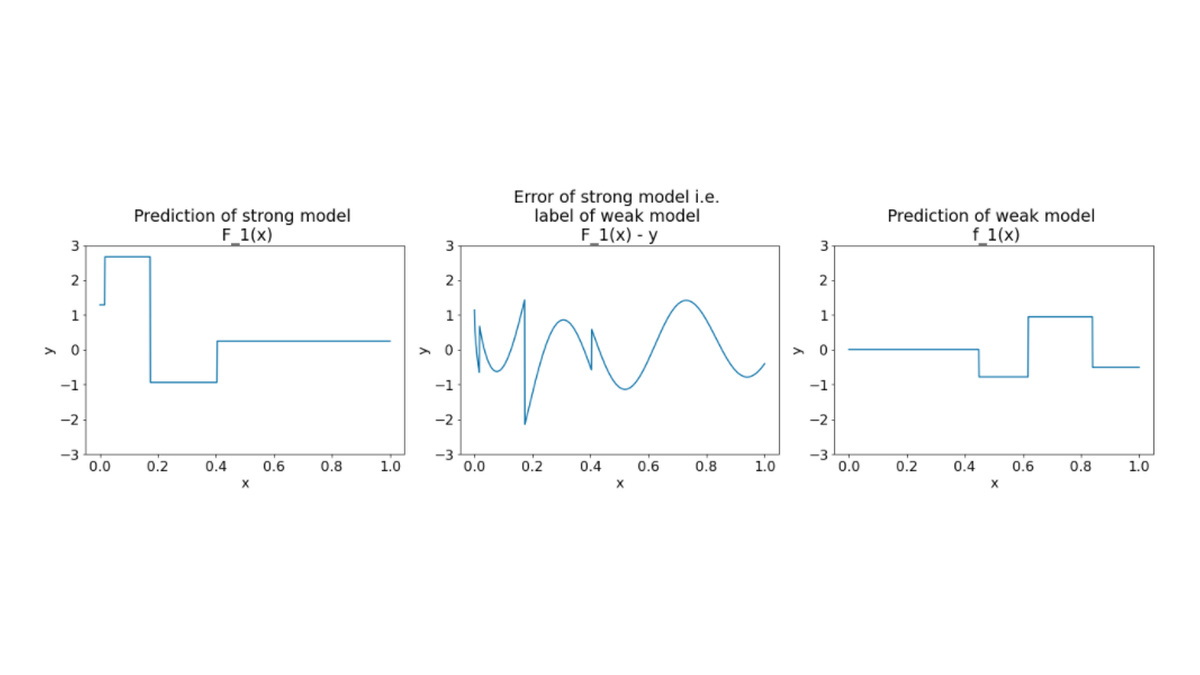
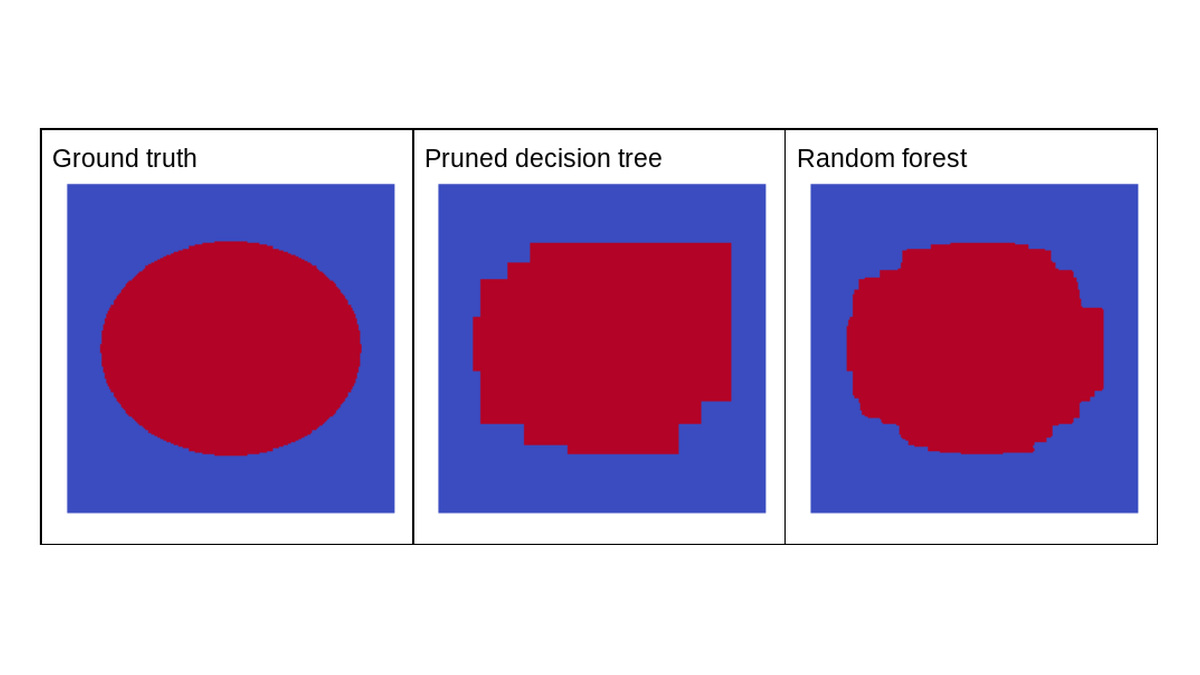
封面沿用本篇已註明來源的配圖,僅等比縮放並加白邊以保留全圖;圖片原有的署名與授權條件同樣適用於封面版本。
留言0
登入後就能留言。
登入