
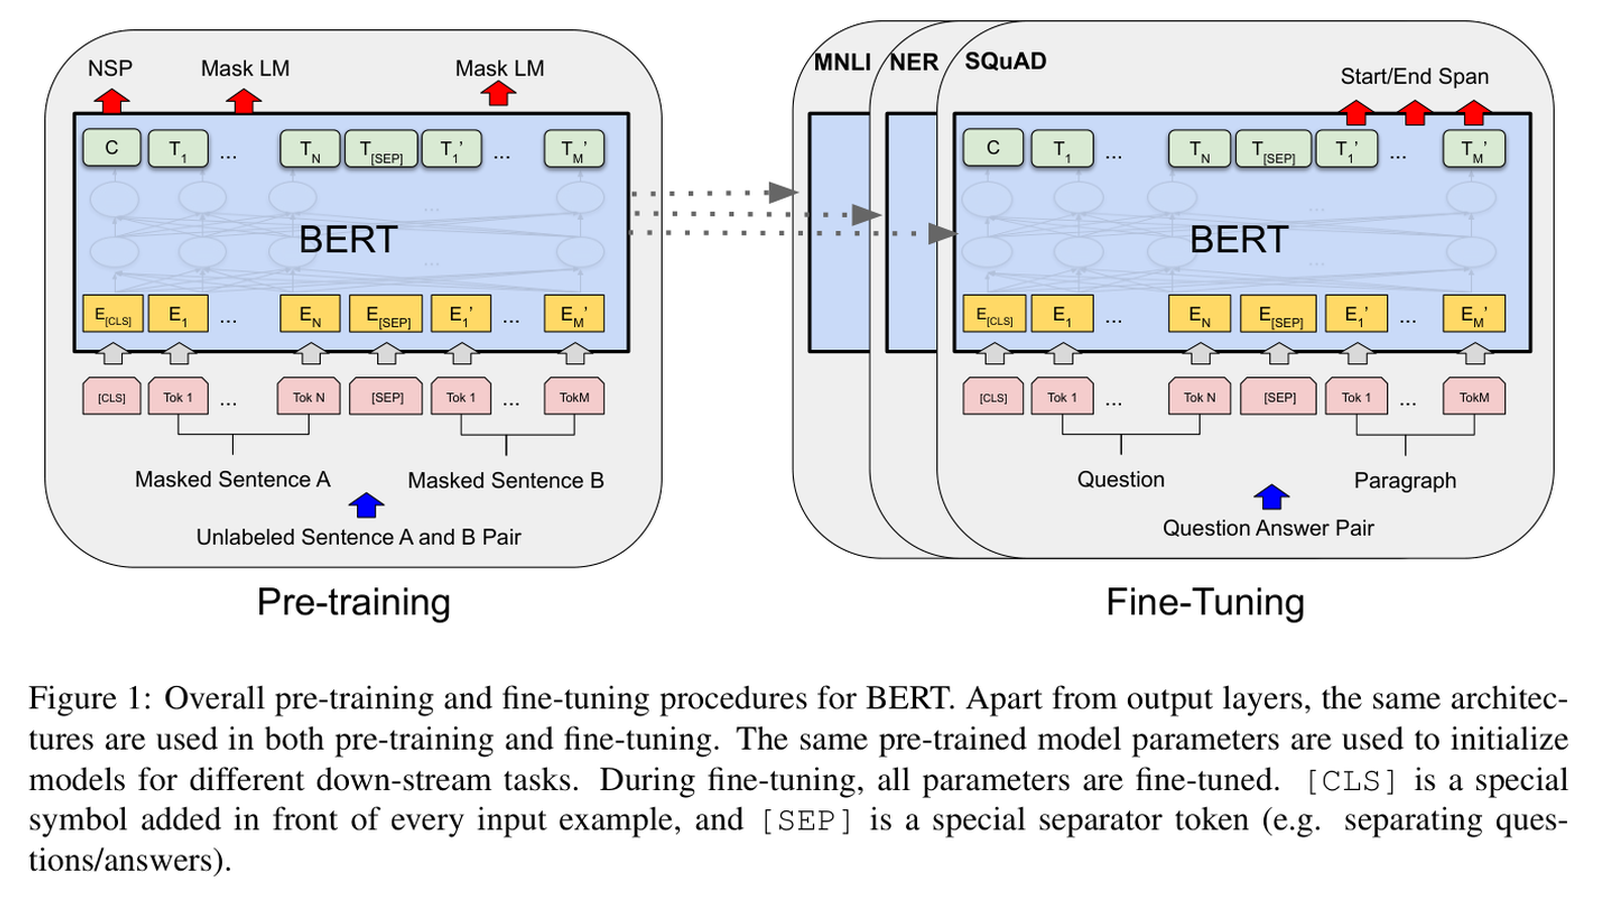
如果要替評論分類、標出人名,再從段落找出問題的答案,是否每次都要重做一套語言模型?BERT 提供的路徑是:先用大量未人工標註的文字學習雙向表徵,再把同一份預訓練參數作為不同下游模型的起點,依任務接上輸出層並微調。
這不是把一個分類器搬去所有任務,也不是凍結模型後一定只訓練最後一層。要看清預訓練加微調改變了什麼,得追問三件事:預訓練到底預測什麼?下游任務讀取哪個表徵?新的 loss 最後更新哪些參數?
本篇用原論文及教材原圖逐步拆解,再以一個手設的小型 Transformer encoder 實際核對更新範圍與有效位置 loss。這段程式不是 BERT,也沒有預訓練權重、語料訓練或準確率比較。Tokenizer、Encoder/Decoder 與標籤位移的關係,可先回看上一篇架構與 tokenizer 教學。
預訓練提供起點,微調讓任務改寫參數
原 BERT 的兩階段可以這樣理解:預訓練先定義能由文字本身產生標籤的任務;下游微調再用指定任務的標籤,調整骨幹與輸出層。
例如評論分類需要類別標籤,抽取式問答需要答案在段落中的起點與終點。它們可以由同一份預訓練骨幹初始化,但之後是各自微調的模型,並不是把所有下游答案都塞進同一個固定 head。
這裡「同一份預訓練參數」說的是初始化來源。下游分類模型與問答模型各自更新後,參數便可以不同。預訓練時的 MLM、NSP 頭也不必全部保留到每個下游任務;輸出層要對應當前的標籤形式。
原論文採用的是端到端、全參數微調:下游模型裡的預訓練骨幹參數與任務輸出層一起更新。若固定骨幹、只訓練新增 head,那是另一種特徵移轉方式,後面會用程式把兩者分清。
Contextual 表徵不是換一張靜態詞向量表
靜態詞向量可以寫成查表:同一個 token ID,查到同一列向量。這並不表示詞向量完全沒有學到語意,而是查表本身沒有讀取這一次出現的前後文。
BERT 也有 token embedding 查表,但那只是輸入的一部分。向量經過多層雙向 Transformer encoder 後,某個位置的最終表徵會受整段有效輸入影響。同一個字詞出現在不同語境中,編碼後的表徵因而可以不同。
因此,BERT 並沒有發明所有形式的預訓練或語境表徵。這篇要看的是它的組合:以雙向 encoder 學習可移轉的表徵,再用少量任務結構變動,讓整個模型適配不同標籤。這種訓練方式也不保證任意新任務都能只加一層便得到好結果;資料、標籤、更新設定與評估仍要成立。
輸入是三組 embedding 相加
原 BERT 處理兩段文字時,常用以下結構把它們包成一條輸入:
[CLS] 文字A [SEP] 文字B [SEP]
每個位置的初始表示由三項相加,而不是把三條向量接長:
輸入向量_i
  = token_embedding[token_id_i]
  + segment_embedding[segment_id_i]
  + learned_position_embedding[position_i]
三項維度相同,所以相加後仍維持同一個 hidden size。Token 指這個位置的詞表項目;segment 區分輸入 A、B;position 指位置。原 BERT 的 position embedding 是學得的參數,不要直接套成前一篇示範的固定正弦波。
Segment ID 是逐 token 的輸入欄位,不是這一對文字的分類答案。單段文字可以全部使用 A 段;兩段文字則讓模型取得段落區分線索,但這不等於用 segment ID 自動阻隔兩段的注意力。
圖中的加總也不是整個 embedding 模組的全部行為。例如固定 Hugging Face Transformers v4.45.2 的 BERT 實作,會在三項相加後做 LayerNorm 與 dropout。這裡是對固定原始碼的閱讀,不是本站跑過該套件模型。
MLM:選位置、改輸入,保留原 token 標籤
Masked language modeling 不要求每個位置都重建,也不是預測下一個 token。原 BERT 先隨機選取約 15% 的位置作預測目標,再在這些選中位置中決定如何改動輸入:
| 選中位置的處理 | 比例 | 要預測的 label |
|---|---|---|
換成 [MASK] | 80% | 原 token |
| 換成隨機 token | 10% | 原 token |
| 保持原樣 | 10% | 原 token |
80/10/10 是選中的約 15% 之內的比例,不是各佔整條序列的比例;同樣地,選中的位置保持原樣,仍然需要計分。原作者的資料產生程式從詞表隨機抽 token 時,沒有排除抽中原 token,所以「隨機替換」也不保證字面一定改變。固定版原作者資料程式
可以把三個控制分開記:[MASK] 改的是輸入內容;attention mask 限制位置能讀到什麼;loss 的有效位置選擇則決定哪些預測要計分。它們不能互相替代。
尤其要保留原 token label。若原來是 love、輸入被換成另一個詞,目標仍是 love,不是那個隨機替換詞。選取位置、改動輸入與保存原標籤,是資料製作時三個連在一起、卻不同的操作。
NSP 的標籤不是 A/B 段落編號
原 BERT 還有 next sentence prediction:給一對文字 A、B,約一半是語料中的接續關係,另一半將 B 換成隨機抽取的文字,再對整個 pair 做二元分類。
這裡的「接續/隨機」是每個 pair 一個訓練標籤;segment A/B 則是輸入裡每個 token 的段落索引。兩段各自標 A、B,不會直接告訴模型 B 是否真的接在 A 後面。不同實作對二元 label 的 0/1 編號也可能相反,搬資料時應先核對語意映射。
NSP 在原版提供了預訓練訊號,並不因此證明模型已具備一般邏輯推理能力。原 BERT 的兩個預訓練目標可以合成訓練 loss,但下游微調仍要依當前任務換目標。判斷評論情緒,沒有必要繼續把 NSP 的二元輸出當作情緒類別。
[CLS] 的表徵在這些序列級頭中是常見讀取入口,但也不是自動可靠的通用句向量。它如何適合某項任務,仍受預訓練與後續任務訓練影響。
下游 head 決定讀取哪裡、輸出什麼
一段文字:從 CLS 表徵得到類別
假設輸入評論共有六個一般 token,再加 CLS 與 SEP。模型為各位置產生表徵;序列分類可以讀取 CLS 那一個,再送進分類 head。
「讀 CLS」與「用 pooler」還要再分清。最後一層 CLS hidden state 是一個向量;固定 HF v4.45.2 的 BertPooler 會取第零位置,再過 dense+tanh,序列分類模型還接 dropout 與 classifier。因此,last_hidden_state[:, 0] 和該版本的 pooled output 並不是相同運算。圖中的 Dense 是結構簡化,不能當成每個實作都只有同一條線性層。
兩段文字:一起編碼,再對整個 pair 判斷
若任務是判斷兩段文字的關係,可以把它們放入同一條 BERT 輸入,讓 CLS 表徵讀取兩段的有效上下文,再對 pair 分類或回歸。
這類 pair-level 標籤也不能和 NSP 混稱。下游可能預測語意關係、相似度或其他已定義的目標,必須有對應資料與 loss;不能因為都是兩段文字,就沿用原來「接續/隨機」的意思。
每個 token:共享 head,分別輸出標記
人名、地名或詞性等標註任務,通常需要每個相關位置的結果。此時可把各 token 的表徵送入同一組共享參數的分類 head,而不是只讀 CLS。
真正的資料常以「詞」提供標籤,tokenizer 卻可能把一個詞切成多個子詞。哪些子詞承接詞級標籤、其餘是否忽略,需要明確的 alignment 策略;CLS、SEP 與 padding 通常也要另外設定計分範圍,不能從圖上的方框直接推得所有位置都已有合法標籤。
抽取式問答:在 passage 裡選起點與終點
抽取式 QA 的答案是一段 passage 文字範圍。模型可以對 passage 各位置算 start 分數與 end 分數,再從合法範圍選出一個 span。
Start 與 end 各有一套參數,各自在不同 passage 位置共享。輸出的是位置分數;選答案時仍須限制答案落在 passage、終點不早於起點,並依任務決定長度等約束。圖中的單一 Label 是示意,不能把它讀成三個位置做完一般二元分類,就已自動得到合法答案。
凍結與全參數微調,是不同的更新範圍
如果把預訓練 encoder 當固定特徵來源,只訓練新的 head,就是 frozen feature extraction;當 head 只有單一線性層時,常稱 linear probe。若凍結 encoder,但新增的是多層 MLP,便不應把它嚴格叫成同一種線性探測。
原 BERT 的全參數微調則讓下游 loss 更新骨幹與任務 head。Adapter、LoRA 等方法又是另外選擇更新參數範圍的設計,不能混成原 BERT 的 full fine-tuning,也不能直接當成只訓練最後分類層。本篇不實作這些額外方法。
下面的小原型只核對這個更新機制:兩份模型使用相同手設起點、相同兩筆四位置輸入與分類標籤,分別執行一次 SGD,學習率 0.1。
骨幹是一層 nn.TransformerEncoderLayer,模型寬度 4、兩個 head、FFN 寬度 8、ReLU、post-norm、dropout=0;另有 token/position embedding,再以第零位置接線性 4→2 分類頭。它沒有 BERT 的 segment embedding、pooler、預訓練 MLM head 或真實 checkpoint。這是用小結構看參數去哪裡,不是聲稱四維小模型重現原 BERT。
| 一次更新的實際結果 | 凍結骨幹 | 全部 toy 參數可訓練 |
|---|---|---|
| 更新前分類 loss | 0.97189157079009 | 0.97189157079009 |
| 有梯度的 backbone 具名張量 | 0 | 14 |
| 實際改變的 backbone 具名張量 | 0 | 14 |
| 有梯度且實際改變的 head 具名張量 | 2 | 2 |
這裡數的是具名參數張量。Head 的 weight 與 bias 就是兩個張量;14+2 不代表模型總共只有 16 個 scalar,也不表示一個改變的張量裡每個 entry 都改變。
兩份模型更新前的 logits 與 loss 相同。PyTorch 的 constructor 仍會消耗隨機初始化抽樣,但程式隨後完整覆寫所有參數,再把同一個 state 載入兩種模式,因此這次有效起點不依賴那些抽樣值。Dropout 設為零,也沒有用不同噪音替某一組製造優勢。
凍結使用 requires_grad_(False),optimizer 也只接收可訓練參數;全更新模式則讓全部 toy 參數參與。eval() 不是凍結指令,no_grad() 也不是選哪些參數更新的同義詞:本程式在賦值時用 no_grad(),真正的分類 forward、backward 與 step 仍有其正常梯度路徑。
這張表只回答一次更新的 eligibility 與實際變動。程式沒有評估更新後準確率、沒有比較泛化,也不能從「更多張量更新」推成「效果一定更好」。
MLM loss 只對有效標籤取平均
原型另外有一段獨立的 logits 算術:四個位置、三個詞表類別,只選位置 0 與 2,labels 為:
[0, -100, 2, -100]
在這段無 class weights、無 label smoothing 的 PyTorch class-index 交叉熵中,-100 是忽略標籤。它不是 [MASK],也不是可以拿去查 embedding 的 token ID。
兩個有效位置的實際 loss 分別約為 0.16984601955628567、0.49494696296723906,正確平均是:
L = (0.16984601955628567 + 0.49494696296723906) / 2
  = 0.33239649126176235
若把有效 loss 加起來卻除以所有四個位置,就會錯成約 0.16619824563088118。有效分母是 2;這個 2/4 只是為了方便算術,並沒有執行原 BERT 的 15% 選點或 80/10/10 輸入改動。
還要小心 reduction 的順序:不能先把所有位置的 CE 平均成 scalar,再乘上有效位置 weights,期待它自動排除未選位置。固定 D2L 版本的 PyTorch _get_batch_loss_bert 就有這種先 mean、後乘 weights 的次序;改成 unreduced loss 時,也必須讓逐位置 loss 與 weights 同形,避免意外 broadcasting。下方程式使用正確的 ignore_index 路徑,而不照抄該 helper 的順序。固定教材原始碼
實際測試中,改動未選位置的原始目標或該位置 logits,這個 loss 都不變;忽略位置的 logits 梯度為零。但這段 logits 是獨立 leaf tensor,不能據此說真正 BERT 中未選位置的輸入 token 都沒有梯度。在雙向網路裡,它們仍可能影響其他被選位置的預測,並由那條路徑接到梯度。
可重跑的 CPU 更新範圍小例
完整程式如下。實際記錄環境是 Python 3.10.12、PyTorch 2.3.1+cu118,所有計算明確使用 CPU float64。本次沒有 GPU 運算、安裝 Transformers、下載模型/語料、跑 D2L 預訓練或微調真實 BERT。
在已有相依套件的環境,把下方程式存成 finetuning_scope.py,執行 python3 finetuning_scope.py。依賴版本為 torch==2.3.1;若自己的環境還沒安裝,可以參考 python3 -m pip install torch==2.3.1,但新安裝流程、不同 wheel 與新虛擬環境沒有在本次另測,不能把安裝示例說成全部平台都已重現。
成功時,JSON 的 frozen_encoder_vs_full_update 會列出兩種模式、每個具名參數張量的梯度與實際 delta;mlm_ignore_index_only 的有效分母為 2、mean loss 約 0.3323964913。輸出 scope 的 randomness_used_for_initialization:false 應依前述完整覆寫條件理解,指有效演示參數不依賴 constructor 抽樣,並不是說 constructor 沒有動到隨機數產生器。
"""Deterministic toy of frozen features vs full fine-tuning and MLM ignore_index.

This is not BERT, does not load a checkpoint, and does not train on a corpus.
"""
from __future__ import annotations

import json
from typing import Any

import torch
from torch import nn


torch.set_num_threads(1)
DTYPE = torch.float64


class TinyBackbone(nn.Module):
    """A small bidirectional Transformer encoder, not a BERT implementation."""

    def __init__(self, vocab_size: int = 6, seq_len: int = 4, d_model: int = 4):
        super().__init__()
        self.token_embedding = nn.Embedding(vocab_size, d_model)
        self.position_embedding = nn.Parameter(torch.zeros(1, seq_len, d_model))
        self.encoder_layer = nn.TransformerEncoderLayer(
            d_model=d_model,
            nhead=2,
            dim_feedforward=8,
            dropout=0.0,
            activation="relu",
            batch_first=True,
            norm_first=False,
            bias=True,
            layer_norm_eps=1e-5,
        )

    def forward(self, token_ids: torch.Tensor) -> torch.Tensor:
        x = self.token_embedding(token_ids) + self.position_embedding
        return self.encoder_layer(x)


class TinySequenceClassifier(nn.Module):
    """CLS-position linear classifier on top of the toy backbone."""

    def __init__(self):
        super().__init__()
        self.backbone = TinyBackbone()
        self.classifier = nn.Linear(4, 2)

    def forward(self, token_ids: torch.Tensor) -> torch.Tensor:
        contextual = self.backbone(token_ids)
        return self.classifier(contextual[:, 0, :])


def assign_all_parameters(model: nn.Module) -> None:
    """Overwrite every initialized parameter with deterministic fixed values."""
    with torch.no_grad():
        for name, parameter in model.named_parameters():
            i = torch.arange(parameter.numel(), dtype=DTYPE, device="cpu")
            if name.endswith("norm1.weight") or name.endswith("norm2.weight"):
                value = torch.ones_like(i)
            elif name.endswith("bias"):
                value = ((i.remainder(5) - 2.0) * 0.01)
            else:
                value = ((i.remainder(9) - 4.0) * 0.025)
            parameter.copy_(value.reshape(parameter.shape))

        model.backbone.token_embedding.weight.copy_(torch.tensor(
            [
                [0.10, 0.00, 0.20, -0.10],  # [CLS]
                [0.20, 0.10, 0.00, 0.30],  # good
                [-0.20, 0.10, 0.10, 0.00],  # bad
                [0.10, -0.10, 0.10, 0.20],  # movie
                [-0.10, 0.20, 0.00, 0.10],  # not
                [0.00, 0.20, 0.30, -0.10],  # great
            ], dtype=DTYPE))
        model.backbone.position_embedding.copy_(torch.tensor(
            [[[0.00, 0.01, 0.02, 0.03],
              [0.01, 0.00, 0.03, 0.02],
              [0.02, 0.03, 0.00, 0.01],
              [0.03, 0.02, 0.01, 0.00]]], dtype=DTYPE))
        model.classifier.weight.copy_(torch.tensor(
            [[0.20, -0.30, 0.40, 0.10],
             [-0.10, 0.20, -0.20, 0.30]], dtype=DTYPE))
        model.classifier.bias.copy_(torch.tensor([0.05, -0.03], dtype=DTYPE))

    if any(not torch.isfinite(p).all() for p in model.parameters()):
        raise RuntimeError("non-finite fixed parameter")


def metrics(x: torch.Tensor | None) -> dict[str, Any]:
    if x is None:
        return {"state": "no_grad", "l2": None, "max_abs": None}
    return {
        "state": "gradient_present",
        "l2": float(torch.linalg.vector_norm(x).item()),
        "max_abs": float(x.abs().max().item()) if x.numel() else 0.0,
    }


def one_update(kind: str, initial: TinySequenceClassifier,
               token_ids: torch.Tensor, labels: torch.Tensor) -> dict[str, Any]:
    model = TinySequenceClassifier().to(dtype=DTYPE, device="cpu")
    model.load_state_dict(initial.state_dict())
    if kind == "frozen_backbone":
        model.backbone.requires_grad_(False)
    elif kind != "all_toy_parameters_trainable":
        raise ValueError(kind)

    before = {name: p.detach().clone() for name, p in model.named_parameters()}
    trainable = [p for p in model.parameters() if p.requires_grad]
    optimizer = torch.optim.SGD(trainable, lr=0.1)
    criterion = nn.CrossEntropyLoss()
    model.train()
    optimizer.zero_grad(set_to_none=True)
    logits = model(token_ids)
    loss = criterion(logits, labels)
    loss.backward()
    grads = {name: (None if p.grad is None else p.grad.detach().clone())
             for name, p in model.named_parameters()}
    optimizer.step()

    rows = []
    for name, parameter in model.named_parameters():
        old = before[name]
        new = parameter.detach()
        grad = grads[name]
        delta = new - old
        rows.append({
            "name": name,
            "requires_grad": bool(parameter.requires_grad),
            "before_l2": float(torch.linalg.vector_norm(old).item()),
            "grad": metrics(grad),
            "after_l2": float(torch.linalg.vector_norm(new).item()),
            "delta_l2": float(torch.linalg.vector_norm(delta).item()),
            "changed": bool(torch.any(delta != 0).item()),
        })

    backbone_rows = [r for r in rows if r["name"].startswith("backbone.")]
    head_rows = [r for r in rows if r["name"].startswith("classifier.")]
    return {
        "mode": kind,
        "one_sgd_step": True,
        "learning_rate": 0.1,
        "loss_before_update": float(loss.detach().item()),
        "logits_before_update": logits.detach().tolist(),
        "parameter_rows": rows,
        "summary": {
            "total_named_parameter_tensors": len(rows),
            "trainable_parameter_tensors": sum(r["requires_grad"] for r in rows),
            "backbone_tensors_with_grad": sum(r["grad"]["state"] == "gradient_present" for r in backbone_rows),
            "backbone_tensors_changed": sum(r["changed"] for r in backbone_rows),
            "head_tensors_with_grad": sum(r["grad"]["state"] == "gradient_present" for r in head_rows),
            "head_tensors_changed": sum(r["changed"] for r in head_rows),
        },
    }


def mlm_ignore_index_demo() -> dict[str, Any]:
    # Four token positions, three toy vocabulary classes. Positions 0 and 2
    # are selected; other labels are represented by the default ignore_index.
    logits = torch.tensor(
        [[[2.0, 0.0, -1.0], [0.0, 2.0, -1.0],
          [-0.2, 0.1, 1.1], [1.0, 0.0, 0.0]]],
        dtype=DTYPE, requires_grad=True)
    selected = torch.tensor([[True, False, True, False]])
    source_targets = torch.tensor([[0, 1, 2, 1]], dtype=torch.long)
    labels = torch.where(selected, source_targets, -100)

    criterion = nn.CrossEntropyLoss()  # PyTorch 2.3.1 default ignore_index=-100
    loss = criterion(logits.reshape(-1, 3), labels.reshape(-1))
    loss.backward()

    changed_unselected_targets = torch.tensor([[0, 2, 2, 0]], dtype=torch.long)
    changed_labels = torch.where(selected, changed_unselected_targets, -100)
    loss_after_target_change = criterion(logits.detach().reshape(-1, 3),
                                         changed_labels.reshape(-1))

    altered_logits = logits.detach().clone()
    altered_logits[:, 1, :] = torch.tensor([[100.0, -100.0, 50.0]], dtype=DTYPE)
    altered_logits[:, 3, :] = torch.tensor([[-90.0, 80.0, 70.0]], dtype=DTYPE)
    loss_after_ignored_logits_change = criterion(altered_logits.reshape(-1, 3),
                                                 labels.reshape(-1))

    per_token = nn.functional.cross_entropy(
        logits.detach().reshape(-1, 3), source_targets.reshape(-1), reduction="none"
    ).reshape(1, 4)
    manual_valid_mean = per_token[selected].mean()
    grad_norm_by_position = torch.linalg.vector_norm(logits.grad, dim=-1)
    return {
        "logits_shape": list(logits.shape),
        "labels_shape": list(labels.shape),
        "selected_positions": [0, 2],
        "labels_with_ignore_index": labels.tolist(),
        "valid_label_count_and_mean_denominator": int((labels != -100).sum().item()),
        "default_ignore_index": criterion.ignore_index,
        "selected_position_losses": per_token[selected].tolist(),
        "cross_entropy_mean_loss": float(loss.detach().item()),
        "manual_selected_mean_loss": float(manual_valid_mean.item()),
        "loss_after_changing_unselected_source_targets": float(loss_after_target_change.item()),
        "loss_after_changing_ignored_position_logits": float(loss_after_ignored_logits_change.item()),
        "max_abs_loss_difference_target_change": float(abs((loss - loss_after_target_change).item())),
        "max_abs_loss_difference_ignored_logits_change": float(abs((loss - loss_after_ignored_logits_change).item())),
        "logit_gradient_l2_by_position": grad_norm_by_position.tolist(),
        "ignored_positions_have_zero_logit_gradient": bool(torch.all(grad_norm_by_position[:, [1, 3]] == 0).item()),
    }


def main() -> None:
    vocab = {"[CLS]": 0, "good": 1, "bad": 2, "movie": 3,
             "not": 4, "great": 5}
    token_ids = torch.tensor([
        [vocab["[CLS]"], vocab["good"], vocab["movie"], vocab["great"]],
        [vocab["[CLS]"], vocab["not"], vocab["bad"], vocab["movie"]],
    ], dtype=torch.long, device="cpu")
    labels = torch.tensor([1, 0], dtype=torch.long, device="cpu")

    initial = TinySequenceClassifier().to(dtype=DTYPE, device="cpu")
    assign_all_parameters(initial)
    named = dict(initial.named_parameters())
    expected_tensors = 16
    if len(named) != expected_tensors:
        raise RuntimeError(f"expected {expected_tensors} named parameter tensors, got {len(named)}")

    frozen = one_update("frozen_backbone", initial, token_ids, labels)
    full = one_update("all_toy_parameters_trainable", initial, token_ids, labels)
    mlm = mlm_ignore_index_demo()
    assert frozen["summary"]["backbone_tensors_with_grad"] == 0
    assert frozen["summary"]["backbone_tensors_changed"] == 0
    assert frozen["summary"]["head_tensors_changed"] == 2
    assert full["summary"]["backbone_tensors_with_grad"] == 14
    assert full["summary"]["backbone_tensors_changed"] == 14
    assert full["summary"]["head_tensors_changed"] == 2
    assert mlm["max_abs_loss_difference_target_change"] == 0.0
    assert mlm["max_abs_loss_difference_ignored_logits_change"] == 0.0
    assert mlm["ignored_positions_have_zero_logit_gradient"]

    result = {
        "scope": {
            "purpose": "parameter update scope and MLM ignore_index mechanics only",
            "not_bert": True,
            "not_pretrained": True,
            "no_corpus_fit_or_checkpoint": True,
            "no_15_percent_mask_sampling": True,
            "no_80_10_10_corruption": True,
            "no_nsp": True,
            "no_accuracy_or_quality_or_convergence_claim": True,
            "device": "cpu",
            "dtype": str(DTYPE),
            "torch": torch.__version__,
            "python_fixed_vocab": vocab,
            "input_token_ids": token_ids.tolist(),
            "hand_set_sequence_labels": labels.tolist(),
            "encoder": "one nn.TransformerEncoderLayer(d_model=4,nhead=2,dim_feedforward=8,dropout=0,batch_first=True,norm_first=False,activation=relu); learned toy token and position embeddings; no BERT segment embeddings",
            "loss_and_update": "CrossEntropyLoss on the same two hand-set labels; one SGD update at lr=0.1 per mode; same fixed starting state",
            "all_parameters_explicitly_overwritten": True,
            "randomness_used_for_initialization": False,
        },
        "frozen_encoder_vs_full_update": {
            "frozen_backbone": frozen,
            "full_finetune": full,
        },
        "mlm_ignore_index_only": mlm,
    }
    print(json.dumps(result, indent=2, ensure_ascii=False, sort_keys=True))


if __name__ == "__main__":
    main()
把更新範圍和任務評估接起來
這個小例能幫你讀懂訓練程式:先看哪些參數可取得梯度,再看 optimizer 收到哪些參數,最後核對 step 之後是否真的改變。只有 requires_grad=True,不代表任意設定下都一定更新;學習率為零、未交給 optimizer,或其他條件都會改變結果。本例之所以能列出 14/2 的變動,是因為它實際比對了更新前後的張量。
換成真正的下游任務,還得先定義輸入、標籤與評估切分。用 training 部分學習與更新參數,以 validation 選設定,保留 test 作最後評估;若樣本來自同一使用者、文章或時間序列,切分方式也要避免同源資訊跨區。固定公開 tokenizer 可以一致套用到各區,但從本批資料新學的詞表或統計量不能先用全部資料 fit。
原 BERT 的預訓練加微調,提供了可移轉的參數起點與相對一致的骨幹;下游仍必須把任務接對。讀 CLS、逐 token 分類或找 passage span,決定了 head 與 labels;凍結、全參數微調或其他更新範圍,決定了哪些參數能適應這些 labels。是否真的值得採用,最後需要對應資料上的評估,而不是從架構圖或一次梯度更新直接下結論。
原圖、方法與實作依據
本篇將原論文方法、教材結構圖與本站手設算術分開:圖中不是本站訓練的注意力權重;小程式沒有重現真實 BERT 預訓練、語料規模或論文的下游分數。
- 圖 1 與封面:Jacob Devlin、Ming-Wei Chang、Kenton Lee、Kristina Toutanova 的 BERT 正式論文頁與 2019 ACL PDF,Figure 1,PDF 第 3 頁/印刷頁 4173。© 2019 Association for Computational Linguistics;依 ACL 對 2016 年後 ACL 材料的官方授權政策與 CC BY 4.0 使用。完整原圖與原 caption 裁取、轉檔及封面白底等比 fit 的變更已於圖說揭露;這份 grant 不擴張為所有第三方圖片或任意 arXiv 版本的授權。
- 圖 2、3:D2L〈Bidirectional Encoder Representations from Transformers〉;圖 4:D2L〈Large-Scale Pretraining with Transformers〉;圖 5–8:D2L〈Fine-Tuning BERT for Sequence-Level and Token-Level Applications〉。七張教材圖的四作者為 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola,使用 D2L 固定版本 原圖,依 CC BY-SA 4.0 提供,轉檔與手機改作圖維持同 SA4;與前項論文圖的 BY4 分開適用。
- MLM/NSP 原方法:BERT 論文 §3 與附錄及 Google 固定版資料產生程式。原作者程式用來核對輸入改動與原標籤保存,不表示本站執行過該資料管線或下載其預訓練語料。
- 輸入、pooler 與分類 head 的 API 說明:HF Transformers v4.45.2 BERT 原始碼。本文限定所讀版本與方法,不把文件或 source 閱讀說成已裝模型實跑。
- 小例的實際運算接口:PyTorch 2.3 CrossEntropyLoss、requires_grad_、SGD。完整程式輸出會逐張量列出 gradient 與 delta;這些是指定 CPU/float64/手設資料下的機制結果,不是微調成效或模型排名。
留言0
登入後就能留言。
登入