
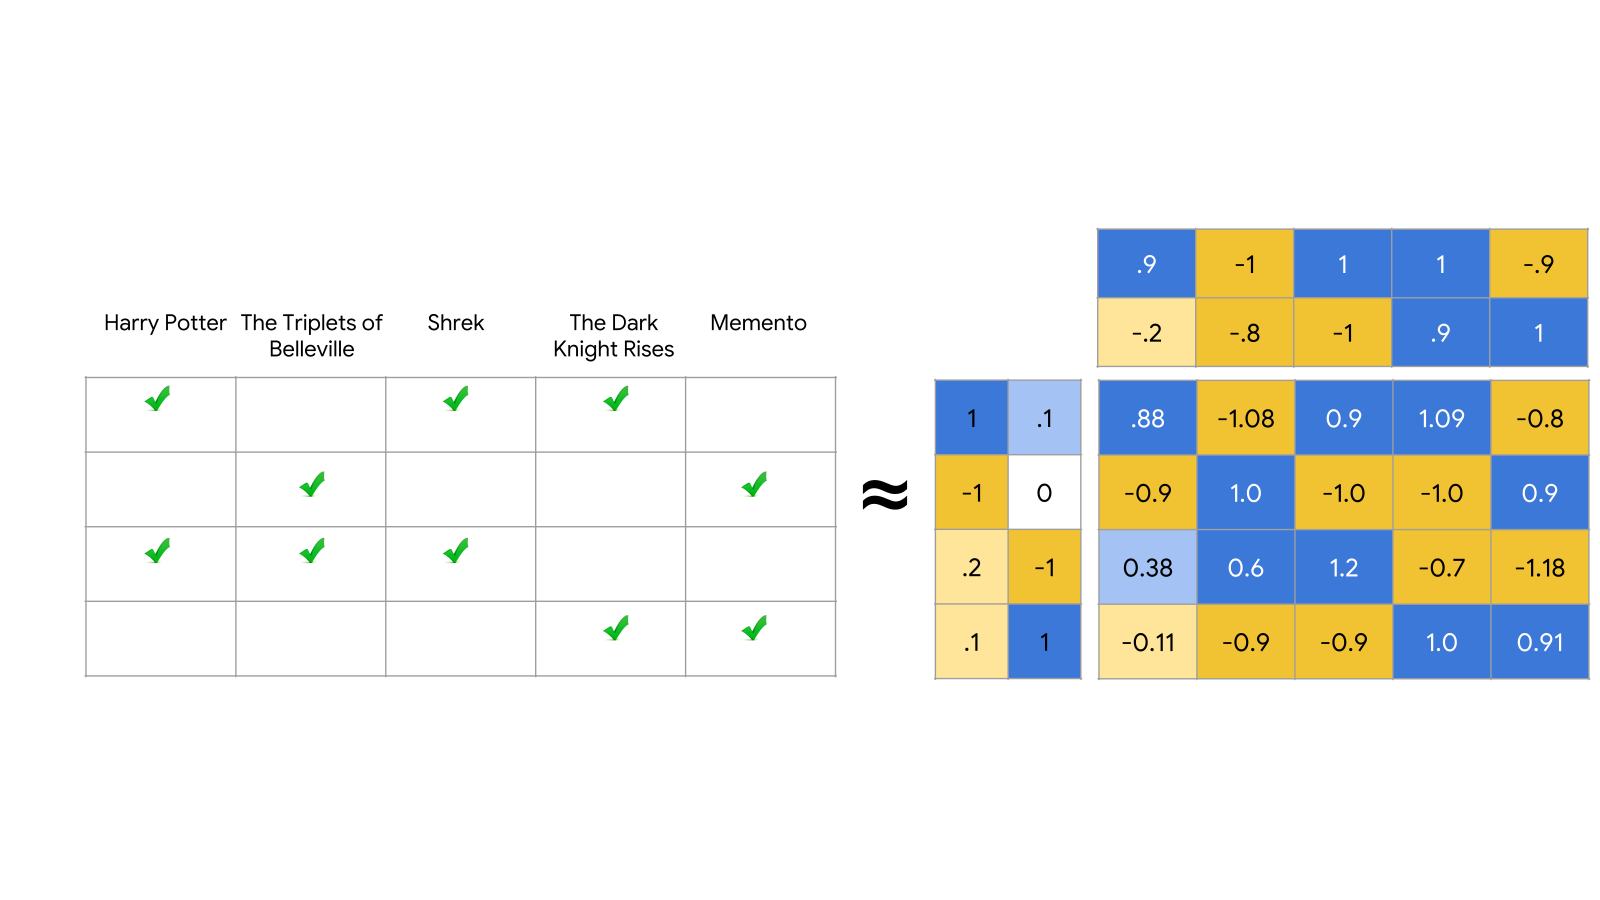
一個新上架的項目還沒有人評分,系統仍然可能推薦它。如果知道它的類別、主題或其他內容,就能與使用者過去喜歡的內容比較;但只靠 ID 查表的協同模型,還沒有這個新項目學好的向量。
這個差別來自向量的來源。內容法用項目的屬性建立表示,協同法從多人的互動中學習關聯。兩者都可能算點積,卻不表示拿到了相同資訊,也不表示能處理相同的冷啟動問題。
本篇先用來源原圖拆開這些概念,再實際訓練一個小型矩陣分解模型。你會看到:訓練評分幾乎擬合好了,保留評分卻比平均分基線差;同一組資料另用內容特徵,則能替沒有協同向量的 NEW 項目算出相似度。這些是可重跑的機制例子,尚不是推薦品質的證明。
先問資料記錄了什麼:評分、互動,還是沒看過?
推薦訊號常分成 explicit feedback 與 implicit feedback。前者是使用者直接給的評分,例如一到五星;後者是觀看、點擊、購買或停留等行為。隱式互動可能反映興趣,也可能受曝光、位置、價格與使用情境影響。
尤其要分清「沒有評分」和「評了零分」。沒評分可能只是沒接觸過,不能自行補成討厭。同樣地,沒點擊可能是沒看見;點擊也不等於喜歡到願意購買。當我們把這些記錄轉成訓練目標,已經在選擇一套假設。
| 記錄 | 能直接知道的事 | 不能直接替它補上的解讀 |
|---|---|---|
| 明確一星或五星 | 使用者留下了評分 | 所有未評項目都比它更差 |
| 一次觀看/點擊 | 這次互動發生過 | 一定滿意,或分數就應等於五星 |
| 沒有記錄 | 目前沒有觀測 | 一定不喜歡、已看過卻拒絕 |
本文程式使用手設的明確評分,只在列出的訓練三元組上計算評分誤差。後面 Google 的電影圖則以觀看勾選、binary interest 來教概念;它們不是同一份資料,損失函數的解讀也需要跟著訊號改變。
內容推薦:把項目和偏好放進相同的特徵空間
假設項目有「教育、休閒、健康」類別,也知道開發者是誰。可以把這些屬性編成向量:有某項特徵就填 1,沒有就填 0。使用者也能用同一套欄位表達偏好,來源可能是明確選擇,也可能是過去的互動。
圖中的上排第一個 app 同時具 Education 與 Science R Us,第二個具 Casual 與 TimeWastr,第三個具 Health 與 Healthcare。下方使用者在 Education、Science R Us、Healthcare 有啟用特徵。因此 binary dot product 可以直接手算:
共同啟用的特徵,各貢獻 1

第一個 app:Education + Science R Us = 2
第二個 app:沒有共同啟用特徵 = 0
第三個 app:Healthcare = 1
這裡較大的分數表示依這套特徵定義有更多共同點,不是偏好機率,也不是實際星等。把屬性編得更細、重複放入相近欄位,或改變特徵尺度,都會改變點積。
內容法的好處,是新項目只要有可用的內容,就有機會進入候選。但它也受特徵覆蓋範圍限制:如果偏好來自某種沒被編進去的關係,光靠這張表就很難看見。本文稍後改用中心化評分加權的使用者 profile 和 cosine,相似度定義與這張 binary dot 圖不同。
協同過濾:從多人互動看見內容欄位以外的關聯
協同過濾會利用多名使用者與多個項目的互動。例如兩個人經常喜歡相近項目,其中一人喜歡的新項目,可能成為另一人的候選。這不要求兩個項目在人工類別中很接近。
實作方法不只一種。可以比較使用者或項目之間的鄰近關係,也可以學習較低維的表示。矩陣分解是其中一種表示方法,不等於協同過濾的全部。
若只用一個「偏兒童/偏成人」的維度,某些人的紀錄容易解釋,另一些人就不行。例如圖中第二列使用者的數值是 0,和任何單一項目座標相乘都等於 0,無法區分其已看項目。
增加一個區分藝術取向與商業大片的維度,就多了一種解釋互動的方式。圖 3 紅框示意的第四列使用者向量是 [0.1,1],第三欄電影向量是 [1,−1],點積為 0.1−1=−0.9。這只是按圖上手設數字作相容性計算,不是負的觀看機率。
更重要的是,這兩張圖的語意軸是作者為教學手設的。真正在互動資料上學出的 latent factors,不保證某一欄就叫「兒童取向」或「藝術電影」。將使用者與項目向量一起作適當旋轉,仍可保留點積;不能只因有兩個座標,就替它們任意命名。
矩陣分解:用兩張小表,近似一張互動表
把使用者排成列、項目排成欄,就得到 user–item 矩陣。矩陣分解為每個使用者學一個 d 維向量、每個項目也學一個 d 維向量,兩者點積形成對應的預測。
U:使用者數 m × latent dimension d
V:項目數 n × latent dimension d
U V^T:m × n

第 u 列、第 i 欄的點積:U[u] · V[i]
資料很多、d 相對小時,這樣可以用較少的參數描述互動中的共享結構。它同時加上限制:每一筆使用者與項目的預測,必須能由這組共用向量解釋,而不是替每個格子自由記一個完全獨立的值。
本文為明確評分加入偏置項,避免要求每種整體高低差都塞進 latent dot product:
rating_prediction(u,i)
  = training_mean + user_bias[u] + item_bias[i]
    + user_vector[u] · item_vector[i]
其中 global mean 固定由訓練評分算出;user bias、item bias 與兩張向量表則一起學。偏置可以描述模型擬合出的整體差異,但仍然是預測模型的參數,不應被直接讀成使用者個性或項目品質的因果證據。
缺的格子怎麼處理,取決於你在解哪種問題
觀測遮罩決定哪些 pair 進入損失。對本文的明確評分,只在已留下訓練評分的格子計算誤差;沒有觀測的格子不加入「零星」誤差。
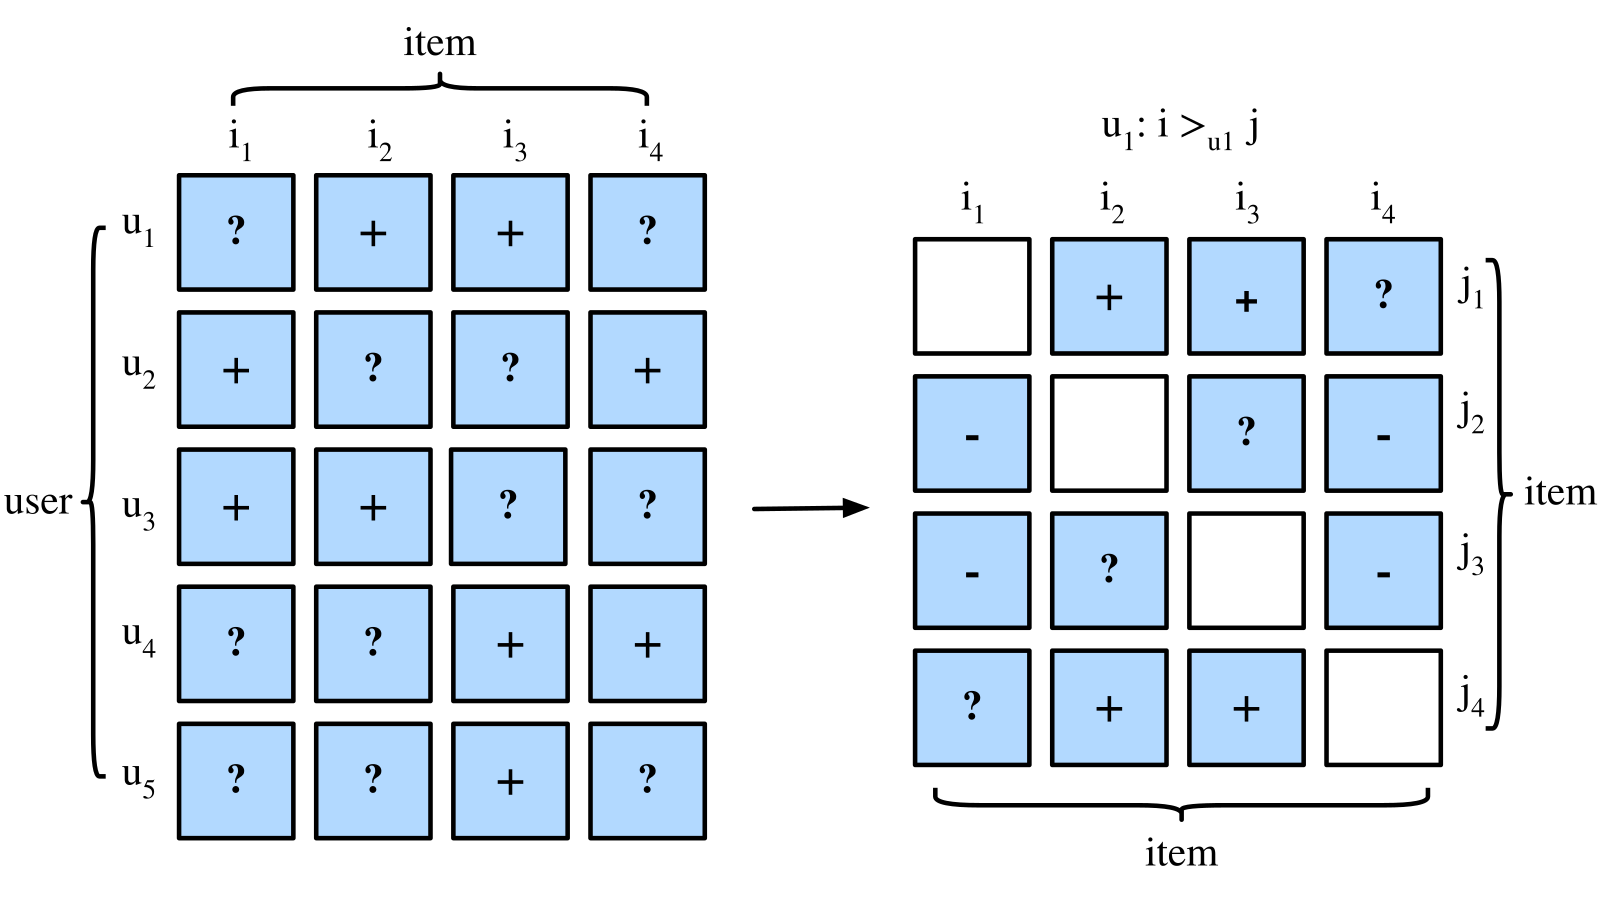
圖 5 的 positive-only 退化問題有特定前提:binary implicit 資料裡,若所有觀測目標都是 1,只要求這些 1 擬合得好,全部輸出 1 就能把那部分誤差降到零,卻沒學會區分候選。
這不能推成「所有 observed-only loss 都錯」。本文觀測到的是 1–5 不同評分,一個全 1 的預測無法同時解釋它們。相對地,若把所有未評格子都填零,又會換成另一個訓練問題,可能讓大量未觀測格子主導目標。
加權 implicit MF 會為觀測與未觀測指定不同權重,這是在設計學習訊號,不是發現「沒看過就真的不喜歡」。選用 SGD、WALS 或 SVD 也需對應具體目標:本文不做隨機抽樣 SGD、交替 WALS 或 SVD 分解,使用自行寫的同步 full-batch gradient descent。
本文使用的目標明確寫成以下形式:
error(u,i) = predicted_rating(u,i) - observed_rating(u,i)

L = mean(error^2 over 24 training observations)
    + 0.02 * [mean(U^2) + mean(V^2)
              + mean(user_bias^2) + mean(item_bias^2)]
正則項是四個陣列各自取 mean,再相加,不是把所有參數合起來只算一次 mean;兩組 bias 也有正則化。每一步先由全部舊參數計算梯度,再一起更新所有陣列,沒有先改使用者向量、再拿新使用者向量去算同一步的項目梯度。
這個問題對兩組因子並非聯合凸問題。固定 2,000 步只是實驗設定,不代表已找到全域最優解或已經收斂。
實作:二十四筆評分訓練,六筆保留評分最後才看
小例有六名使用者、八個已見項目 A–H,每名使用者提供四筆訓練評分,共 24 筆。另留六筆沒有重疊的 pair,這些 user/item ID 都已在訓練中出現,因此它測的是已知 ID 的保留評分預測,沒有測新使用者或新項目的實際效果。
| 陣列 | shape | 可學參數數量 |
|---|---|---|
| 使用者向量 U | 6×2 | 12 |
| 項目向量 V | 8×2 | 16 |
| user bias | 6 | 6 |
| item bias | 8 | 8 |
| 合計 | — | 42 |
固定 global mean 是 73/24,約 3.041667,不是另一個可學參數。這個小例用 42 個參數面對 24 筆觀測,本身就不能只靠訓練誤差判定學得好;六筆保留資料也很少,且評分皆為 4 或 5,無法代表一般服務情境。
內容特徵另有三個人工 binary 屬性,還多一個只有 metadata 的 NEW 項目。這些特徵不參與 MF 的梯度;它們用來示範另一條內容打分路徑。
實際執行環境是 Python 3.10.12、NumPy 1.26.3。將版本清單存成 requirements.txt:
numpy==1.26.3
把下面完整程式存成檔案。在 WSL/Linux 中可依以下順序準備環境與執行;若系統缺少 venv 模組,需先依 Python 安裝方式補齊。
python3 -m venv .venv
source .venv/bin/activate
python -m pip install -r requirements.txt
python content_and_matrix_factorization.py > stdout.json
本次驗證的是前述既有環境的實際執行,沒有宣稱重新測試所有平台的 pip 安裝。成功後應得到含訓練三元組、六筆 held-out 預測、最終參數與兩種候選排序的 JSON。先確認 train 有 24 筆、held-out 有 6 筆且 pair 不重疊,再對照下表;不同版本或平台不保證逐 byte 相同。
"""Original sparse-rating example, not a production recommendation benchmark.

Only the 24 training triples update the model; six held-out ratings are scored
after fixed training. Content cosine scores are rankings, not rating predictions.
"""
import json
import platform

import numpy as np


ITEMS = ("A", "B", "C", "D", "E", "F", "G", "H", "NEW")
# Hand-set metadata, not learned collaborative coordinates.
FEATURES = np.array([[1, 0, 0], [1, 0, 0], [0, 1, 0], [0, 1, 0],
                     [0, 0, 1], [0, 0, 1], [1, 1, 0], [0, 1, 1],
                     [1, 0, 1]], dtype=float)
TRAIN = np.array([
    [0, 0, 5], [0, 2, 1], [0, 4, 3], [0, 6, 4],
    [1, 1, 5], [1, 3, 1], [1, 5, 3], [1, 7, 2],
    [2, 0, 1], [2, 2, 5], [2, 4, 2], [2, 7, 4],
    [3, 1, 1], [3, 3, 5], [3, 5, 2], [3, 6, 3],
    [4, 0, 3], [4, 3, 2], [4, 5, 5], [4, 6, 2],
    [5, 1, 3], [5, 2, 2], [5, 4, 5], [5, 7, 4],
], dtype=float)
HELD_OUT = np.array([[0, 1, 5], [1, 0, 4], [2, 3, 4],
                     [3, 2, 5], [4, 4, 4], [5, 5, 5]], dtype=float)
N_USERS, N_SEEN_ITEMS, DIMENSION = 6, 8, 2
UPDATES, LEARNING_RATE, REGULARIZATION, SEED = 2000, 0.05, 0.02, 7


def initialize():
    rng = np.random.default_rng(SEED)
    return {"users": rng.normal(0, .1, (N_USERS, DIMENSION)),
            "items": rng.normal(0, .1, (N_SEEN_ITEMS, DIMENSION)),
            "user_bias": np.zeros(N_USERS), "item_bias": np.zeros(N_SEEN_ITEMS)}


def predict(parameters, triples, mean):
    users, items = triples[:, 0].astype(int), triples[:, 1].astype(int)
    return (mean + parameters["user_bias"][users] + parameters["item_bias"][items]
            + np.sum(parameters["users"][users] * parameters["items"][items], axis=1))


def loss_and_gradient(parameters, mean):
    # Explicit sparse mask: missing pairs never enter this squared rating loss.
    users, items = TRAIN[:, 0].astype(int), TRAIN[:, 1].astype(int)
    error = predict(parameters, TRAIN, mean) - TRAIN[:, 2]
    mse = float(np.mean(error**2))
    penalty = sum(float(np.mean(value**2)) for value in parameters.values())
    gradient = {name: 2 * REGULARIZATION * value / value.size
                for name, value in parameters.items()}
    coefficient = 2 * error / len(TRAIN)
    np.add.at(gradient["users"], users,
              coefficient[:, None] * parameters["items"][items])
    np.add.at(gradient["items"], items,
              coefficient[:, None] * parameters["users"][users])
    np.add.at(gradient["user_bias"], users, coefficient)
    np.add.at(gradient["item_bias"], items, coefficient)
    return mse + REGULARIZATION * penalty, mse, gradient


def train():
    parameters = initialize()
    mean = float(np.mean(TRAIN[:, 2]))
    initial_loss, initial_mse, _ = loss_and_gradient(parameters, mean)
    for _ in range(UPDATES):
        _, _, gradient = loss_and_gradient(parameters, mean)
        # Simultaneous full-batch gradient descent, using all old parameters.
        parameters = {name: value - LEARNING_RATE * gradient[name]
                      for name, value in parameters.items()}
    final_loss, final_mse, _ = loss_and_gradient(parameters, mean)
    return parameters, mean, {"initial_objective": initial_loss,
        "final_objective": final_loss, "initial_training_MSE": initial_mse,
        "final_training_MSE": final_mse}


def content_scores(user):
    history = TRAIN[TRAIN[:, 0] == user]
    if not len(history):
        return None
    centered = history[:, 2] - history[:, 2].mean()
    profile = np.sum(centered[:, None] * FEATURES[history[:, 1].astype(int)], axis=0)
    norm = np.linalg.norm(profile)
    if norm == 0:
        return None
    return FEATURES @ profile / (np.linalg.norm(FEATURES, axis=1) * norm)


def main():
    parameters, mean, record = train()
    item_means = np.array([TRAIN[TRAIN[:, 1] == i, 2].mean()
                           for i in range(N_SEEN_ITEMS)])
    truths = HELD_OUT[:, 2]
    predicted = {"global_training_mean": np.full(len(truths), mean),
                 "item_training_mean": item_means[HELD_OUT[:, 1].astype(int)],
                 "biased_matrix_factorization": predict(parameters, HELD_OUT, mean)}
    evaluation = {name: {"predictions": values.tolist(),
        "RMSE": float(np.sqrt(np.mean((values-truths)**2)))}
        for name, values in predicted.items()}
    seen = {int(i) for u, i, r in TRAIN if u == 0}
    candidates = [i for i in range(N_SEEN_ITEMS) if i not in seen]
    candidate_triples = np.array([[0, i, 0] for i in candidates], dtype=float)
    mf_scores = predict(parameters, candidate_triples, mean)
    content = content_scores(0)
    ranking_mf = sorted(zip(candidates, mf_scores), key=lambda pair: (-pair[1], pair[0]))
    content_candidates = [i for i in range(len(ITEMS)) if i not in seen]
    ranking_content = sorted(content_candidates, key=lambda i: (-content[i], i))
    assert all(np.isfinite(value).all() for value in parameters.values())
    assert set(map(tuple, TRAIN[:, :2])).isdisjoint(set(map(tuple, HELD_OUT[:, :2])))
    print(json.dumps({"scope": "Hand-set explicit ratings and binary item metadata; "
        "actual observed-only matrix-factorization training, no external dataset.",
        "versions": {"python": platform.python_version(), "numpy": np.__version__},
        "settings": {"users": N_USERS, "seen_items": N_SEEN_ITEMS, "dimension": DIMENSION,
            "updates": UPDATES, "learning_rate": LEARNING_RATE,
            "regularization": REGULARIZATION, "seed": SEED,
            "objective": "mean observed squared error + .02*sum(mean(square(each parameter array)))",
            "prediction": "fixed training mean + user_bias + item_bias + user_vector dot item_vector"},
        "training_triples": TRAIN.tolist(), "held_out_triples": HELD_OUT.tolist(),
        "item_names": ITEMS, "item_features": FEATURES.tolist(),
        "training_mean": mean, "training_item_means": item_means.tolist(),
        "training_record": record, "final_parameters": {k: v.tolist() for k, v in parameters.items()},
        "held_out_evaluation": evaluation,
        "user0_unseen_known_item_rating_predictions": [{"item": ITEMS[i], "score": float(s)}
            for i, s in ranking_mf],
        "user0_content_cosine_ranking_including_NEW": [{"item": ITEMS[i], "score": float(content[i])}
            for i in ranking_content],
        "cold_start": {"new_item": "NEW has metadata but no collaborative factor; no MF score emitted.",
            "new_user": "No history means content profile undefined and MF user ID unknown; "
                        "a non-personalized fallback may use training item means.",
            "new_user_content_profile": content_scores(N_USERS),
            "fallback_item_mean_order": [ITEMS[i] for i in sorted(range(N_SEEN_ITEMS),
                key=lambda i: (-item_means[i], i))]},
        "limits": ["Explicit ratings: missing pairs are unobserved, not observed zero-star ratings.",
            "This observed-only loss does not train a binary implicit-feedback recommender.",
            "Fixed settings selected before computing six held-out errors; no tuning on them.",
            "Single seed and 2000 updates do not establish convergence or best model performance.",
            "Six held-out pairs from known IDs are not new-user/new-item generalization.",
            "Content cosine values are not rating predictions or calibrated probabilities.",
            "RMSE is not top-k ranking quality; no ranking or online recommendation benefit measured.",
            "Toy factors have no guaranteed semantic axes; coordinates are not identifiable.",
            "No external rating dataset, movie posters, or third-party user data used."]},
        ensure_ascii=False, indent=2))


if __name__ == "__main__":
    main()
保存輸出中的訓練目標與評分誤差如下。這些數值來自實際 2,000 次更新,不是手填的預期結果:
{
  "training_record": {
    "initial_objective": 2.052505312484621,
    "final_objective": 0.03883595297864613,
    "initial_training_MSE": 2.0521671193065143,
    "final_training_MSE": 0.000245321907835023
  }
}
MF 雖然把訓練評分擬合得很近,這六筆保留評分卻比兩個平均分基線差。這個結果應保留,不能換一個 seed、調到測試誤差好看後,仍把同六筆稱為未看過的最終測試。
第一筆保留資料是 user 0 對 B 的真實評分 5,模型輸出約 5.179724。線性偏置加點積沒有把結果限制在 1–5,所以會出界。本文沒有測試後 clipping;若產品需要有界輸出,轉換規則也應是事先定義、一起驗證的模型流程。
新項目能算內容相似度,不代表已經有協同向量
接著看 user 0 的內容推薦。先對他自己的四筆訓練評分減掉其平均 3.25,再拿這些中心化權重乘上各項目 metadata,相加形成 profile。
user 0 訓練評分:A=5、C=1、E=3、G=4
個人平均:3.25
中心化權重:A=1.75、C=-2.25、E=-0.25、G=0.75

三維 profile = [2.5, -1.5, -0.25]
cosine(item, profile) = dot(item, profile)
                       / [norm(item) * norm(profile)]
這與圖 1 的 binary dot 不同。低於個人均分的項目會帶來負權重,cosine 也可能為負;它不是負機率或負星等,只是這套內容表示下的方向相似度。
排除 user 0 已有訓練記錄的項目後,兩條路徑得到:
| 候選 | 內容 cosine | MF 評分預測 |
|---|---|---|
| B | 0.854358 | 5.179724 |
| NEW | 0.543710 | 無已學 factor,不輸出 |
| F | −0.085436 | 3.375803 |
| H | −0.422885 | 2.655291 |
| D | −0.512615 | 1.824483 |
表格以內容分數排序;MF 的已知 ID 排序是 B、F、H、D。兩欄的量尺不同,不能直接比較 0.85 和 5.18 誰比較有信心。內容法能替 NEW 算值,是因為它有三維 metadata;MF 的項目表只有 A–H 八列,沒有 NEW 的向量,程式沒有替它生成假分數。
另一種冷啟動是新使用者。若完全沒有歷史,也沒有主動填寫偏好,這套內容 profile 就尚未定義;純 ID 的 MF 也沒有新使用者向量。產品可詢問偏好、利用合法可用的情境,或先採非個人化備案,不能把「新項目有特徵」誤認成所有冷啟動都解決了。
本文示範的新 user 6 會得到 None profile;備案可依訓練項目均分排序。E、F、H 同為 10/3,依 item index 打破同分;接著 A、B、G 同為 3,再接 C、D 的 8/3。這是確定性的候選順序,不是對新使用者效果的實測。
評分預測做得好,與前幾名推薦有用,是兩個檢查
RMSE 關心預測數字和保留評分相差多少。首頁推薦還涉及誰出現在前幾名、候選是否可取得、是否重複推薦已消費項目,以及使用者最後是否從這些曝光中獲益。這些不能由六筆 RMSE 直接推出。
本例雖然輸出排序,沒有計算 top-k 品質,也沒有線上實驗。user 0 的 B 恰好是保留評分之一,不代表其餘未觀測候選都已被驗證喜歡;沒記錄仍然只是沒記錄。下一步需要依產品任務設計候選集、保留互動與排序評估,而不是只把 cosine 或預測星等稱為推薦成功率。
真實服務還會有時間問題。訓練時能用的互動應先於預測時間;未來留下的評分不能回填到當時的偏好 profile,後來才知道的項目屬性也要看可用時間。本文是固定 pair holdout,並沒有模擬時間切分或上線曝光。
從內容特徵、協同訊號到矩陣分解,核心判斷始終是:向量怎麼取得,缺值被賦予什麼意義,以及評估真的檢查了哪種能力。把這些條件寫清楚,才能決定何時用內容補足冷 ID、何時學習互動中的共享結構,以及何時需要新的驗證資料。
來源與圖像署名
本文原創部分是 24 筆明確評分與六筆保留 pair、手寫全批次梯度、偏置與四組 mean 正則、內容 profile/cosine,以及 NEW/新使用者的分開處理。Google 的 binary 與手設語意圖沒有被改稱本篇訓練輸出。
- Google for Developers:Content-based filtering、Collaborative filtering basics、Matrix factorization。上述三頁是本文方法與來源圖的主要對照;本文的 explicit biased MF 與課程 binary implicit/weighted 例子的假設分開。
- 圖像使用依 Google Developers site policies 所列內容授權與個別圖源核對。選用圖僅保留課程概念圖部分,省略 app 圖示、電影圖片及人物 avatar;保留原有欄標、數值與勾選,不把 Google 的內容授權擴張到未採用的第三方圖片。Google 原圖及本次改作依 CC BY 4.0 署名,無暗示 Google 為本站模型背書。
Google Developers recommendation teaching diagrams

Portions of this page are modifications based on work created and shared by Google and used according to terms described in the Creative Commons 4.0 Attribution License:
https://creativecommons.org/licenses/by/4.0/

Original Google source pages:
- Content-Based Filtering: https://developers.google.com/machine-learning/recommendation/content-based/basics
- Collaborative Filtering Basics: https://developers.google.com/machine-learning/recommendation/collaborative/basics
- Matrix Factorization: https://developers.google.com/machine-learning/recommendation/collaborative/matrix

The selected figures are adapted from the original Google SVG diagrams linked on those pages. The embedded movie poster/still and user-avatar images were omitted from the collaborative-filtering diagrams; the four embedded icon/portrait images were omitted from the content-feature diagram. The original vector geometry, text, matrix values, legends and Google diagram checkmarks are retained. The SVGs were rendered as PNG on a white background. Mobile versions include the whole figure first, followed by proportional crops of the original source-render pixels; the cover is a full proportional fit on a 1600×900 white canvas. No values, labels, arrows or data were added.
留言0
登入後就能留言。
登入