
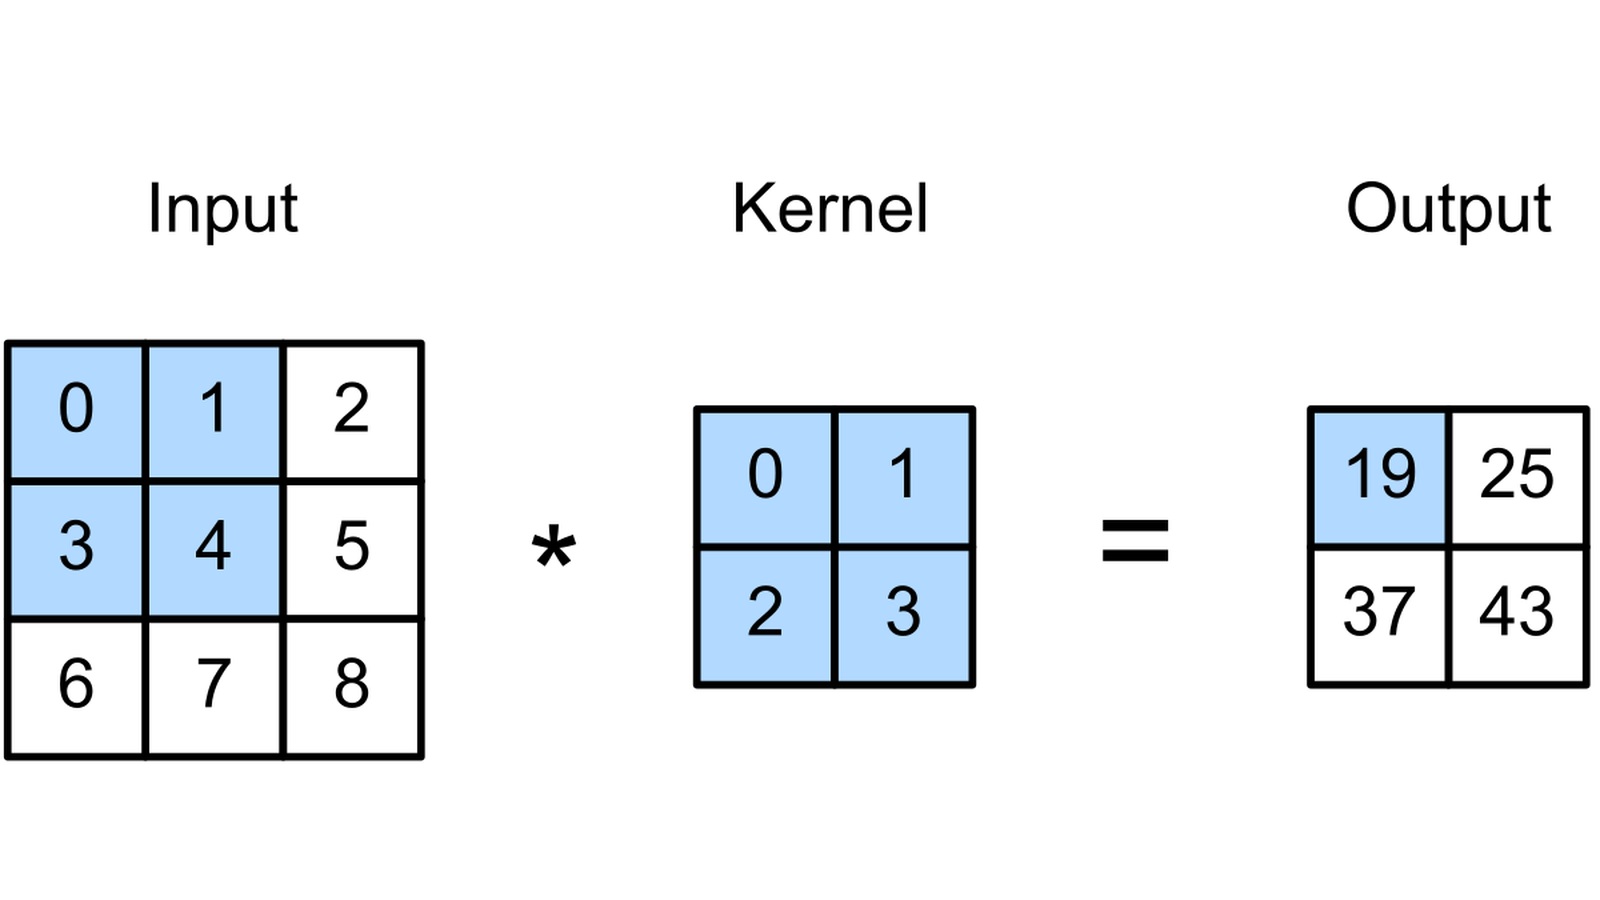
CNN處理影像的關鍵,是用一小組權重反覆掃過各個位置,再把局部訊號組合成更大的表示。卷積負責帶權重的局部計算,Pooling負責固定規則的區域彙整;感受野則回答:某一層的一個輸出,最多可能受到原始影像哪一塊區域影響?
如果只背「卷積抓特徵、Pooling降維」,看到模型裡的Conv2d(3, 64, 3, padding=1),仍然很難知道64從哪來、為什麼大小沒有變,或一個3×3核怎麼能處理整張圖片。本篇沿著這些問題逐步拆解,最後可以用紙筆預測輸出形狀,再用小程式核對。
上一篇談過尺度與梯度;這裡先把CNN的資料流看清楚。來源圖是教材的示例,本站另用4×4數字矩陣驗算運算,並用另一個12×12例子檢查感受野。沒有訓練影像分類器,也沒有把別人的實驗結果當成本次測試。
影像不是一長排數字:先分清空間與通道
圖1|CS231n以三維體積表示中間特徵,標出width、height與depth。這裡的depth是該層的通道數,不是網路有幾層,也不是實體物件的遠近。來源:Andrej Karpathy/CS231n,MIT;完整JPEG轉PNG。
一張RGB圖片可以表示成H×W×3:每個位置有紅、綠、藍三個數值。灰階圖片也可以保留一個通道,寫成H×W×1。進入網路後,通道不必繼續代表顏色;例如64個輸出通道,就是64組不同的局部計算結果,不是64張不同樣本。
本篇PyTorch的卷積輸入使用N×C×H×W,N是batch中的樣本數。單張4×4、單通道的輸入就寫成1×1×4×4。其他函式庫、影像讀取工具可能使用N×H×W×C。把同一份記憶體直接reshape成另一個順序,不等於正確交換通道軸;應確認工具的軸約定,必要時做transpose或permute。
MLP可以吃攤平的影像,但全連接層不會自動強制相鄰像素共用局部運算。CNN則把兩個條件寫進結構:每個輸出位置先看局部區域,同一個輸出通道的各位置共用一組權重。這是模型的結構假設,不是圖片丟進去就保證能辨識物件。
把視窗放上去:逐格相乘,再加總
圖2|D2L原圖使用3×3輸入[[0,1,2],[3,4,5],[6,7,8]],核為[[0,1],[2,3]],無padding、步長1,輸出[[19,25],[37,43]]。藍色是第一個視窗及對應輸出。來源:D2L,CC BY-SA 4.0;原SVG轉白底PNG,手機保留完整圖再附原圖分區放大。
先看左上角的四個數字。把視窗和核的相對位置對齊後:
0×0 + 1×1 + 3×2 + 4×3 = 19
視窗向右移一格,換成[[1,2],[4,5]],同一個核不變:
1×0 + 2×1 + 4×2 + 5×3 = 25
再向下走完其餘位置,得到另外兩個數字。這裡先沒有偏置;若這個輸出通道有一個偏置b,就在每個位置的加總後都加上同一個b。
注意,這種做法沒有翻轉核,嚴格說是互相關(cross-correlation)。CNN套件通常仍把它叫作卷積。數學上的離散卷積,會把二維核旋轉180度再做上述滑窗計算。對固定數值的核,兩者結果可以不同;對可以自由學習權重的核,翻轉只是另一種參數排列,因此可表達的函數族對應,但不能據此宣稱兩次訓練一定得到相同權重或更新路徑。
換一組數字,檢查你是否真的會算
以下是本站的算例,刻意與圖2分開:
X = [[ 1,  2,  3,  4],     K = [[1,  2],
     [ 5,  6,  7,  8],          [0, -1]]
     [ 9, 10, 11, 12],
     [13, 14, 15, 16]]
不補邊、步長1時,左上輸出是1×1+2×2+5×0+6×(-1)=-1。完整結果為:
[[-1,  1,  3],
 [ 7,  9, 11],
 [15, 17, 19]]
若先把K旋轉180度,改用[[-1,0],[2,1]],得到的是[[15,17,19],[23,25,27],[31,33,35]]。文末程式同時檢查兩個結果,避免只背名詞,卻把實際運算方向看反。
手設的核有助於理解運算;真正訓練時,權重通常由反向傳播及優化器調整。不能把每一個任意核都叫成邊緣偵測器,也不能只看某個通道很亮,就斷言它學到了某個語意概念。
跨通道:一個輸出通道,會把多個輸入通道加起來
圖3|D2L把疊起來的兩個輸入通道展開。右側上排的輸入/核均比下排大1,兩路互相關後加總;第一個輸出是37+19=56。輸出只有一個通道,不是把兩路結果並排接起來。來源:D2L,CC BY-SA 4.0;完整圖轉PNG,手機另附分區放大。
對一般groups=1的卷積,一個輸出通道需要一個形狀為C_in×k_h×k_w的核。每個輸入通道都有對應權重,先做空間滑窗,再把這些通道的結果相加,最後加一次該輸出通道的偏置。
想要兩個輸出通道,就準備兩套這樣的權重;想要64個,就準備64套。PyTorch的普通Conv2d權重形狀因此是C_out×C_in×k_h×k_w。分組卷積與depthwise convolution會改變通道連接方式,不能直接套用全部輸入通道相連的敘述。
沿用本站4×4的X,讓兩個輸入通道分別是X和X+1,再手設兩個輸出:
| 輸出通道 | 對輸入通道0的核 | 對輸入通道1的核 | 偏置 |
|---|---|---|---|
| 0 | K | 全1的2×2核 | 0.5 |
| 1 | 全0的2×2核 | K | −1 |
第0通道的左上輸出,等於X與K的結果−1,加上X+1左上四格2+3+6+7=18,再加0.5,得到17.5。第1通道則是0+(2×1+3×2+6×0+7×(-1))-1=0。不同輸出通道,使用的是不同的通道加權方式。
權重共享,省掉的是每個位置各學一份的重複
普通卷積含偏置的參數量為:
參數量 = C_out × (C_in × k_h × k_w + 1)
剛才的例子是2×(2×2×2+1)=18個參數。即使某個核被我們手設成全0,這些槽位仍是這個一般卷積結構的參數;不是數值恰好為0,就把參數量扣掉。
它在3×3個位置輸出兩個通道,共產生18個輸出值,參數剛好也是18只是巧合。改用更大輸入,輸出值會變多,共享的權重數量仍相同。若為每個空間位置各準備一套同樣大小的局部權重,這裡就會是3×3×18=162個參數。
參數較少也不代表計算一定較少。同一個核會在很多位置重複做乘加,實際成本還與特徵圖大小、通道數、實作及硬體有關。
圖4|D2L的1×1原圖有3個輸入通道、2個輸出通道。同一個位置沿通道方向混合,核不直接讀取相鄰位置。來源:D2L,CC BY-SA 4.0;完整圖轉PNG,手機另附分區放大。
1×1卷積不是「什麼都沒做」。在步長1、無padding時,它保留H和W,但能把C_in個數值做線性組合,轉成C_out個數值;有偏置時是仿射轉換。同一個轉換會用在每個像素位置。若另設步長大於1,空間尺寸仍可能縮小,不能只看到1×1就認定形狀不變。
Padding與Stride:一個決定邊界,一個決定走多遠
圖5|D2L在原3×3矩陣四周各補1格0,變成5×5,再用2×2核、步長1,輸出4×4。左上輸出0包含補進去的零,並非原影像多了一圈真實觀測。來源:D2L,CC BY-SA 4.0;完整圖轉PNG,手機另附分區放大。
如果每一層都不補邊,3×3核、步長1會讓高和寬各減少2。多疊幾層後,特徵圖可能很快變小。Padding讓視窗可以延伸到原始邊界之外;補零是常見做法,但零值是一種邊界假設,不是資料本身。
下面採用PyTorch的「每側padding」記號:高度上下各補p_h,寬度左右各補p_w,dilation固定為1。
H_out = floor((H_in + 2*p_h - k_h) / s_h) + 1
W_out = floor((W_in + 2*p_w - k_w) / s_w) + 1
floor表示向下取整,只保留能完整放下核的起始位置。這是本篇指定的普通卷積形狀公式;若使用非對稱padding、dilation或其他API選項,要改用對應公式。
| 正方形輸入 | 核大小 | 每側補零 | 步長 | 輸出大小 |
|---|---|---|---|---|
| 4×4 | 2×2 | 0 | 1 | 3×3 |
| 4×4 | 2×2 | 1 | 2 | 3×3 |
| 28×28 | 5×5 | 2 | 1 | 28×28 |
| 10×10 | 3×3 | 0 | 2 | 4×4 |
最後一列的未取整式是4.5,實際向下取整得到4,不是「輸出半個像素」,也不表示這個PyTorch設定一定無效。歷史教材有時以剛好整除為設計習慣;讀API時仍要以實際框架的定義為準。
對奇數核、步長1,上下左右各補(k-1)/2可維持空間大小。但不同框架的SAME還可能涉及非對稱分配或不同步長規則;不能把所有SAME都翻成「每邊固定補一格」。D2L正文部分公式用的是兩側padding的總和,與此處p代表每側的記號也要分清。
圖6|原圖的垂直步長為3、水平步長為2,輸出[[0,8],[6,8]];藍色區域對應被取用的視窗。這不是兩個方向都步長2。來源:D2L,CC BY-SA 4.0;完整圖轉PNG,手機另附分區放大。
Stride是相鄰輸出位置的視窗起點,相隔多少個輸入格。它可以讓輸出更稀疏,也可能讓很小的物體在移動一格後,被分配到不同的視窗。大步長不是沒有代價的壓縮。
本站4×4例子若改成每側補1、兩方向步長2,輸出為[[-1,-3,0],[1,9,8],[26,44,16]]。它雖然也得到3×3,但各位置看的區域和無padding、步長1時不同。輸出形狀相同,不等於運算相同。
Pooling:視窗不學權重,直接取最大或平均
圖7|D2L原圖的2×2 Max Pooling使用步長1,因此視窗互相重疊,輸出[[4,5],[7,8]]。不要把2×2核大小自動當成步長2。來源:D2L,CC BY-SA 4.0;完整SVG轉PNG。
卷積把每個位置乘上可學習權重,再加總;Max Pooling則只問視窗裡最大的數值是多少,Average Pooling取平均。這兩種基本Pooling本身都沒有可學習的權重,而且通常對每個通道分別做,不在這一步混合不同通道。
圖8|CS231n原圖使用另一份4×4輸入,以2×2、步長2取四塊的最大值,結果[[6,8],[3,4]]。色塊標出不重疊區域;輸入不是本站連續1到16的矩陣。來源:Andrej Karpathy/CS231n,MIT;完整JPEG轉PNG,手機保留全圖再分區放大。
改用本站的1到16矩陣,2×2、步長2、無padding時:
Max Pooling       Average Pooling
[[ 6,  8],        [[ 3.5,  5.5],
 [14, 16]]         [11.5, 13.5]]
例如左上角[[1,2],[5,6]],最大是6,平均是3.5。若只看這個最大值,就無法恢復另外三個值,因此Pooling不是可逆壓縮,也不是單純把原圖縮成一張可以精確還原的縮圖。
最大值適合保留區域內最強的反應,平均值保留區域整體水準;哪個較合適要看模型與任務,不能說Max一定比Average好。Pooling也不是每個CNN都必須有的元件,帶步長卷積同樣可以縮小空間尺寸,只是運算與參數不同。
小幅移動不敏感,不等於任意平移不變
若同一視窗內的最大值只換了一個位置,Max Pooling的結果可以不變。但若該值跨過視窗邊界、或移到步長未對齊的位置,輸出就可能改變。
普通步長1卷積在理想網格與相容邊界條件下,具有平移等變性:輸入平移,輸出跟著平移。這與分類結果不隨平移而變的「不變性」不同。有限影像邊界、padding及下採樣,都會影響精確對應;不能把「CNN」當成任何位移都不影響預測的保證。
感受野:不要把核大小當成能看到的原始範圍
圖9|D2L原圖由左至右比較1×1、2×2、3×3核在無padding、步長1下,各輸入位置參與計算的次數。3×3的右圖中央區域可被用9次,邊角只有1次。這是單層的像素使用次數,不是多層感受野成長圖。來源:D2L〈Padding and Stride〉,CC BY-SA 4.0;完整圖轉PNG,手機另附三區放大。
一個輸出看3×3的上一層特徵,不代表只看原圖3×3。上一層的每個特徵也可能已經由一塊區域算出;把這些依賴區域合起來,才是對原始輸入的感受野。
對連續、不含分支的方形卷積/Pooling堆疊,先假定dilation=1。用r表示理論感受野邊長,j表示相鄰輸出位置在原始輸入上的間距。從原始輸入r=1,j=1開始,每層依序更新:
r_new = r_old + (kernel_size - 1) * j_old
j_new = j_old * stride
r的更新必須用舊的j。若上一層已經隔2格取一次,這一層多看一個相鄰格,就會在原始輸入多跨2格。
下面改用另一個12×12輸入,不是把前面的4×4硬塞進三層:
| 階段 | 核與步長 | 空間大小 | 原始輸入上的間距j | 理論感受野r |
|---|---|---|---|---|
| 輸入 | — | 12×12 | 1 | 1 |
| 第1層卷積 | 3×3,步長1 | 10×10 | 1 | 3 |
| 平均池化 | 2×2,步長2 | 5×5 | 2 | 4 |
| 第2層卷積 | 3×3,步長1 | 3×3 | 2 | 8 |
全程無padding。最後一層的一個位置,在上一層看3×3,但對原始輸入的理論範圍已經是8×8;相鄰輸出在原始座標中隔2格。若沿著左上輸出追回去,它可以受到原始列0到7、欄0到7的影響。
程式把兩個卷積核都設為全1,中間用平均池化,不加偏置和激活函數。對最後的左上輸出做autograd,原始12×12中的非零梯度恰好落在這64格。這是特定線性算例的依賴支援檢查,不是用真實圖片訓練後得到的注意力圖。
理論範圍也不等於每格都有同樣影響。甚至換成ReLU、Max Pooling、零權重,或讓不同路徑彼此抵消,都可能讓某次輸入下的非零梯度支援比理論範圍小。Padding則會改變感受野的位置與真實像素覆蓋;若理論區域碰到邊界,部分可能落在補值上。圖9裡的「使用次數」同樣不能當成模型最後學到的重要性。
把零件接起來:沿著LeNet看一次形狀
圖10|D2L的LeNet教學示意,由下往上閱讀。括號6、16是卷積輸出通道,120、84、10是全連接輸出維度;兩次下採樣都是AvgPool。來源:D2L,CC BY-SA 4.0;完整SVG轉PNG,未加入手寫數字樣本。
這張圖對應D2L章節的現代套件教學版本。卷積後使用sigmoid,兩次池化使用平均值;不要看到CNN就自動讀成ReLU與Max Pooling。以單張灰階圖為例,不含batch軸的形狀如下:
1×28×28
 -> Conv5,pad2: 6×28×28 -> sigmoid
 -> AvgPool2,stride2: 6×14×14
 -> Conv5,pad0: 16×10×10 -> sigmoid
 -> AvgPool2,stride2: 16×5×5
 -> Flatten: 400
 -> Linear: 120 -> sigmoid
 -> Linear: 84  -> sigmoid
 -> Linear: 10
第一層核是5×5,但每側補2格,故維持28×28。第二層不補邊,14會縮成10。最後的10維在這個分類設定中對應10個類別,線性層輸出可作為logits;機率轉換與交叉熵要依訓練API的約定搭配,不能看到10個數就稱為已正規化的機率。
這是辨識資料流的教材版本,不把它當成1998年原始LeNet-5逐項完全一致的重製,也沒有在此重跑D2L的Fashion-MNIST訓練。讀懂這個形狀鏈,下一步再看AlexNet、VGG等架構,才不會只剩下背模型名稱。
可重跑的小檢查:把手算與PyTorch對起來
下面完整程式只需NumPy與PyTorch,不下載資料。本次在Python3.10.12、NumPy1.26.3、PyTorch2.3.1+cu118環境執行,但所有張量明確放在CPU、float64;安裝版本帶有CUDA標記不代表本次用了GPU。
可另建虛擬環境安裝numpy==1.26.3與torch==2.3.1,把程式存成convolution_checks.py後執行python convolution_checks.py。不同平台取得的PyTorch建置尾碼可能不同,版本列以你的環境為準。這裡不量測速度,只核對運算值與限定範圍的感受野。
import numpy as np
import torch
from torch.nn import functional as F

print(f"numpy={np.__version__} torch={torch.__version__} device=cpu dtype=float64")
X = np.arange(1., 17.).reshape(4, 4)
K = np.array([[1., 2.], [0., -1.]])

def correlate(a, kernel, padding=0, stride=1):
    padded = np.pad(a, padding, mode="constant")
    kh, kw = kernel.shape
    oh = (padded.shape[0] - kh) // stride + 1
    ow = (padded.shape[1] - kw) // stride + 1
    out = np.empty((oh, ow))
    for i in range(oh):
        for j in range(ow):
            patch = padded[i * stride:i * stride + kh, j * stride:j * stride + kw]
            out[i, j] = np.sum(patch * kernel)
    return out

x = torch.tensor(X[None, None], dtype=torch.float64)
k = torch.tensor(K[None, None], dtype=torch.float64)
for padding, stride in [(0, 1), (1, 2)]:
    manual = correlate(X, K, padding, stride)
    actual = F.conv2d(x, k, padding=padding, stride=stride).numpy()[0, 0]
    assert np.array_equal(manual, actual)
    print(f"cross_correlation padding={padding} stride={stride} output={actual.tolist()}")
flipped = correlate(X, np.flip(K))
assert not np.array_equal(flipped, correlate(X, K))
print("mathematical_convolution_flipped_kernel_output=", flipped.tolist())
for name in ["max", "average"]:
    manual = np.empty((2, 2))
    for i in range(2):
        for j in range(2):
            patch = X[i * 2:i * 2 + 2, j * 2:j * 2 + 2]
            manual[i, j] = patch.max() if name == "max" else patch.mean()
    actual = (F.max_pool2d(x, 2, 2) if name == "max" else F.avg_pool2d(x, 2, 2)).numpy()[0, 0]
    assert np.array_equal(manual, actual)
    print(f"{name}_pool kernel2_stride2_output={actual.tolist()}")
channels = np.stack([X, X + 1])
weights = np.stack([np.stack([K, np.ones_like(K)]), np.stack([np.zeros_like(K), K])])
bias = np.array([.5, -1.])
manual = np.stack([sum(correlate(channels[c], weights[o, c]) for c in range(2)) + bias[o]
                   for o in range(2)])
actual = F.conv2d(torch.tensor(channels[None], dtype=torch.float64),
                  torch.tensor(weights, dtype=torch.float64),
                  torch.tensor(bias, dtype=torch.float64)).numpy()[0]
assert np.array_equal(manual, actual)
print("two_input_two_output_channels=", actual.tolist())
print("shared_parameter_count_with_bias=", weights.size + bias.size)
# Separate12x12 example: Conv3,s1 -> AvgPool2,s2 -> Conv3,s1; no padding.
field, jump = 1, 1
for kernel_size, stride in [(3, 1), (2, 2), (3, 1)]:
    field += (kernel_size - 1) * jump
    jump *= stride
u = torch.arange(144., dtype=torch.float64).reshape(1, 1, 12, 12).requires_grad_()
ones = torch.ones((1, 1, 3, 3), dtype=torch.float64)
y = F.conv2d(F.avg_pool2d(F.conv2d(u, ones), 2, 2), ones)
y[0, 0, 0, 0].backward()
positions = torch.nonzero(u.grad[0, 0], as_tuple=False)
low, high = positions.min(dim=0).values, positions.max(dim=0).values
assert torch.equal(low, torch.tensor([0, 0])) and torch.equal(high, torch.tensor([7, 7]))
assert positions.shape[0] == field ** 2 == 64 and jump == 2
print(f"separate_conv_avgpool_conv_receptive_field={field} output_jump={jump} actual_support_pixels={len(positions)} bounds={low.tolist()}..{high.tolist()}")
print("scope=hand-set CPU cross-correlation, zero padding/stride, pooling, channel sums and a separate linear receptive-field support check; no filter learning, image dataset training, classification benchmark, or universal translation invariance")
本次觀察輸出如下。第一列是實際環境;其餘是上述手設值的確定性結果:
numpy=1.26.3 torch=2.3.1+cu118 device=cpu dtype=float64
cross_correlation padding=0 stride=1 output=[[-1.0, 1.0, 3.0], [7.0, 9.0, 11.0], [15.0, 17.0, 19.0]]
cross_correlation padding=1 stride=2 output=[[-1.0, -3.0, 0.0], [1.0, 9.0, 8.0], [26.0, 44.0, 16.0]]
mathematical_convolution_flipped_kernel_output= [[15.0, 17.0, 19.0], [23.0, 25.0, 27.0], [31.0, 33.0, 35.0]]
max_pool kernel2_stride2_output=[[6.0, 8.0], [14.0, 16.0]]
average_pool kernel2_stride2_output=[[3.5, 5.5], [11.5, 13.5]]
two_input_two_output_channels= [[[17.5, 23.5, 29.5], [41.5, 47.5, 53.5], [65.5, 71.5, 77.5]], [[0.0, 2.0, 4.0], [8.0, 10.0, 12.0], [16.0, 18.0, 20.0]]]
shared_parameter_count_with_bias= 18
separate_conv_avgpool_conv_receptive_field=8 output_jump=2 actual_support_pixels=64 bounds=[0, 0]..[7, 7]
scope=hand-set CPU cross-correlation, zero padding/stride, pooling, channel sums and a separate linear receptive-field support check; no filter learning, image dataset training, classification benchmark, or universal translation invariance
若你更換輸入、核或步長,輸出數字理應跟著變,不要把原本的矩陣當成答案硬比。可先用公式算形狀,再挑左上視窗手算一格,最後核對整張圖。遇到問題時依序檢查:通道軸有沒有放錯、核有沒有被翻轉、padding是每側還是總和、步長是否兩方向相同,以及Pooling是否沿通道各自處理。
這份小例只證明列出的運算與支援範圍吻合,沒有檢查分類準確率、濾波器學習、資料增強、完整CNN訓練,或任意平移下的預測穩定性。
來源與圖像授權
本文的教學安排、4×4運算與12×12感受野檢查由本站整理;來源圖中的輸入、核與結果各按原圖說明,未改標成本次實驗。技術依據包括:
- D2L:Convolutions for Images:滑窗互相關與核翻轉的差別。
- D2L:Multiple Input and Multiple Output Channels:通道加總與1×1卷積。
- D2L:Padding and Stride:補邊、步長及單層像素使用次數;本文的p採每側記法。
- D2L:Pooling:固定區域彙整與各通道分別處理。
- D2L:LeNet:本篇架構圖及對應教學版本。
- CS231n:Convolutional Neural Networks:volume、權重共享與Pooling圖。歷史章節中的非整除尺寸說法,不直接當成本篇PyTorch的有效性規則。
- PyTorch 2.3:Conv2d:NCHW、互相關、groups、權重與輸出形狀的API約定;本次執行使用2.3.1。
圖2–7、9–10與封面,原作出自《Dive into Deep Learning》,作者為Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola。按D2L實際版本授權採CC BY-SA 4.0。本站將原SVG轉白底PNG,部分手機版先保留全圖,再把原圖分區直排放大;封面由圖2等比縮放、加白邊。沒有改動原圖數值與箭頭。上述D2L圖像及其衍生版本同樣依CC BY-SA 4.0提供;各圖原頁列於上方及圖說。
圖1、8為Andrej Karpathy/CS231n原始示意圖,依實際版本MIT授權使用;JPEG轉PNG,圖8手機版另加原圖分區放大。下列完整聲明適用於這些採用的來源圖,不延伸宣稱同頁第三方論文或照片也受MIT涵蓋:
The MIT License (MIT)

Copyright (c) 2015 Andrej Karpathy

Permission is hereby granted, free of charge, to any person obtaining a copy
of this software and associated documentation files (the "Software"), to deal
in the Software without restriction, including without limitation the rights
to use, copy, modify, merge, publish, distribute, sublicense, and/or sell
copies of the Software, and to permit persons to whom the Software is
furnished to do so, subject to the following conditions:

The above copyright notice and this permission notice shall be included in all
copies or substantial portions of the Software.

THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR
IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY,
FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE
AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER
LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM,
OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE
SOFTWARE.
留言0
登入後就能留言。
登入