
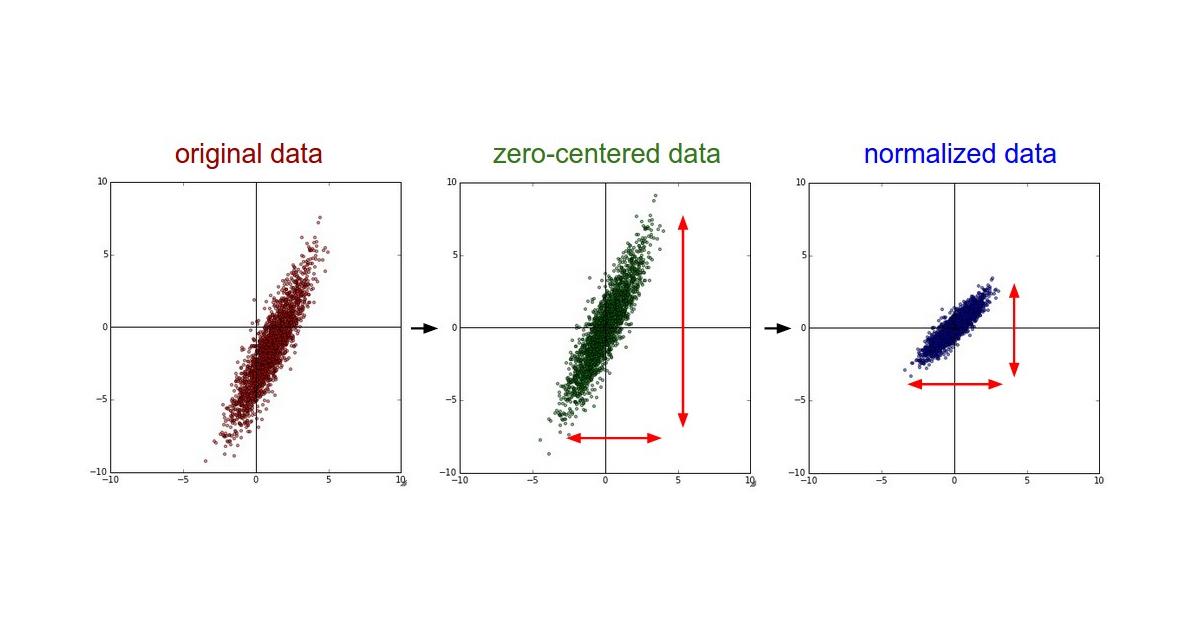
Normalization要先問「對哪些數值,用哪一份統計量?」輸入標準化、BatchNorm與LayerNorm都可能減平均、除標準差,但計算的軸、統計量來源及訓練/推論行為不同。把它們當成同一種開關,常會讓訓練診斷走錯方向。
上一篇已談過正則化與停止時機。本篇往前追一步:當loss不動、梯度很小,或模型切成推論模式就改變輸出時,要怎麼分清數值尺度、初始化與模式設定的影響?
我們先讀原始概念圖,再手算一個3筆、2特徵的batch。最後的CPU程式核對BatchNorm、LayerNorm與一條構造的sigmoid鏈;教材模型曲線屬於來源實驗,沒有冒稱本站重跑完整訓練。
輸入標準化:改尺度,不等於消除相關性
圖1|CS231n原始toy資料圖,依序為原始資料、各維減平均、再除各維標準差。點雲仍斜向延伸:尺度調整不等於去除特徵相關性。手機先保留完整三面板,再附各面板放大;原圖中的轉換箭頭以完整圖為準,未新增點或座標。來源:Andrej Karpathy/CS231n,MIT。
若一個特徵是幾千、一個特徵是零點幾,同一個參數步長可能對兩者帶來不同影響。逐特徵標準化把資料放到較可比較的尺度,但不是把所有資訊變得相同,也不保證模型一定更準。
預處理的平均與尺度,應從訓練資料估計,再套到驗證與測試資料。這和資料洩漏直接相關:先對全資料估平均、再切分,會讓後面的資料參與前面的流程。
圖2|CS231n另一張toy圖,依序是原資料、中心化後投影到協方差特徵向量方向、再按各方向尺度白化。這和圖1只調整原座標尺度不同。原圖完整保留,手機另附面板放大;來源:Andrej Karpathy/CS231n,MIT。
白化除了處理尺度,也處理協方差結構;在PCA座標裡,除的是協方差特徵值的平方根。若加epsilon做穩定化,結果的協方差通常只是接近單位矩陣。任意資料經白化後,也不會因此自動變成高斯分布。
這些都是資料轉換。網路內部的activation卻會隨權重更新而改變,不能只拿一開始的輸入平均,就認為每層的尺度都已處理好。
梯度很小,先追蹤它是怎麼連乘的
圖3|D2L繪出sigmoid與導數,輸入範圍約−8到8;藍線是函數值,紫色虛線是導數,最大值0.25。這是函數圖,不是模型訓練曲線。來源:D2L,CC BY-SA 4.0;完整原SVG轉PNG。
一個sigmoid的導數是sigmoid(z)*(1-sigmoid(z))。當z落在正負兩端,導數接近0;即使z=0,導數也只有0.25。反向傳播穿過多層時,不只乘激活導數,還會乘權重與其他Jacobian,所以不能單憑一張函數圖推定整個網路的梯度。
我們另外構造一條很小的scalar鏈:20個sigmoid,權重都固定為1,偏置刻意讓每層preactivation都等於0。第一層輸入0、偏置0;之後每層收到0.5、偏置−0.5,因此每層局部導數都正好是0.25。
輸出對原始輸入的導數 = 0.25^20
                       = 9.094947017729282e-13
這個例子甚至沒有把sigmoid推到飽和區,連乘仍讓梯度很小。它不是任意深網的梯度界,也不是實際模型訓練;只是把鏈式法則的尺度效應單獨拿出來看。
圖4|Google ML Crash Course的tanh原圖,輸出範圍介於−1與1。靠近兩端時斜率變小,輸出有正有負並不代表沒有飽和問題。來源:Google,CC BY 4.0;完整原PNG保留。
圖5|Google教材的ReLU原圖。正半軸局部斜率為1,負半軸斜率為0,零點則不可微,框架採用自己的反向慣例。改用ReLU不保證所有梯度都正常:大量單元一直落在負側,也可能讓某些路徑沒有資料梯度。來源:Google CC BY 4.0;完整原PNG保留。
診斷時,要沿著層查看activation的尺度、飽和比例與梯度,而不是看到小梯度就只調大learning rate。若數值已爆炸,也不能期待把一個Normalization層加進去,就自動修好所有問題。
初始化的工作,是讓起跑尺度合理
假設先看沒有非線性的線性層,輸入與權重具有合適的獨立、零均值條件,輸入變異數約為v、每個權重變異數為s²,則一個輸出的變異數約為:
Var(output) ≈ fan_in * s² * v
這解釋了為什麼「每一層都固定用標準差0.01」未必合適:fan_in不同,輸出尺度也可能不同。Xavier初始化使用Var(w)=2/(fan_in+fan_out)作前向與反向尺度條件的折衷;針對ReLU,He初始化常用Var(w)=2/fan_in的fan-in約定。
這些是依模型假設推導的初始化方法,不是每個非線性網路都精確保持變異數的保證。權重全都相同,也可能保留單元對稱性;要讓兩個單元永遠相同,還需相應的偏置、輸出連線與更新流程都對稱,不能只看其中一張權重矩陣。
Normalization、初始化與優化器各管一部分。權重尺度不合理、loss計算錯誤或資料裡有NaN,都不會因為模型名稱裡多了BN而自然消失。
BatchNorm:沿著batch估計各特徵的尺度
對一個N×C的二維張量,這裡把每列當成樣本、每欄當成特徵。BatchNorm在訓練時,沿N這個方向估每欄的平均與變異數,再套用可學習的縮放gamma與位移beta:
mu_batch[c]  = mean_n X[n,c]
var_batch[c] = mean_n (X[n,c]-mu_batch[c])²
X_hat[n,c]   = (X[n,c]-mu_batch[c])/sqrt(var_batch[c]+epsilon)
Y[n,c]       = gamma[c]*X_hat[n,c] + beta[c]
gamma與beta不是batch平均本身,而是模型參數。若它們經過訓練,輸出可以保留模型需要的尺度與位置。因此BN不等於「讓最後輸出永遠均值0、變異數1」,更不是把任意分布強制變成常態分布。
來手算一個batch,沒有神經網路訓練:
X = [[1, 2],
     [3, 0],
     [5, 4]]
gamma = [2, 0.5]
beta  = [-1, 1]
epsilon = 1e-5
兩欄平均分別是3與2;每欄平方偏差和都是8。因此:
| 量 | 第一欄 | 第二欄 |
|---|---|---|
| batch平均 | 3 | 2 |
| 除以N=3的變異數 | 8/3 | 8/3 |
| 除以N−1=2的變異數 | 4 | 4 |
本文固定使用PyTorch 2.3.1。它的內建BatchNorm在訓練前向使用除以N的變異數;更新running variance時,則使用除以N−1的估計。這是實際API的規則,不要把兩個值都叫variance後就混用。
套用前向公式,結果約為:
Y_train = [[-3.449485150, 1.000000000],
           [-1.000000000, 0.387628712],
           [ 1.449485150, 1.612371288]]
輸出兩欄的平均就是手設的beta,即−1與1。變異數也被gamma的平方改變;epsilon還讓標準化後的變異數與1有微小差距。這些都和公式一致,不是BN失效。
若輸入是N×C×H×W影像,常見BatchNorm2d會對每個channel沿N、H、W聚合,參數則按channel配置。這和二維例子只沿N不同。Batch size為1時,若還有足夠空間位置,並不等於每個channel只有一個值;反之二維訓練只有一筆時,內建API會有統計量樣本數限制。
推論時,用的是哪一份平均與變異數?
內建BN通常追蹤running mean與running variance,推論時使用它們。以本例初始running mean=0、running variance=1、momentum=0.1,更新一批後:
running_mean_new = 0.9*running_mean_old + 0.1*batch_mean
                 = [0.3, 0.2]
running_var_new  = 0.9*running_var_old + 0.1*batch_unbiased_var
                 = [1.3, 1.3]
這裡的momentum是統計量更新比例,和優化器Momentum的velocity不是同一件事。其他框架可能把momentum放在舊統計量的係數上,同一個數字不一定代表同樣更新。
現在切到eval,仍輸入同樣的X,公式改用running統計量:
Y_eval = gamma*(X-running_mean)/sqrt(running_var+epsilon) + beta
第一筆會從訓練模式約[-3.449485150, 1],變成推論模式約[0.227876504, 1.789349181]。它們為什麼不同?因為只更新一批後,running mean還是0.3與0.2,並不是這批資料的3與2。
這個例子用來辨識兩種模式,不表示一批資料就估準了推論統計量。在一般API流程中,也不會自動在訓練結束後,重新用所有訓練資料精確計算每層統計量。
本例設定track_running_stats=True。固定running stats時,同一筆資料單獨推論,或跟另一筆資料一起推論,其BN結果不依賴同批其他樣本。若關閉running追蹤,eval可能仍使用目前batch統計量,不能無條件套用這個結論。
還有一個容易混淆的地方:model.eval()與torch.no_grad()分工不同。前者改變內建BN使用的模式,後者控制是否建立梯度計算圖。本篇程式刻意在bn.train()下使用no_grad()前向,running stats仍然更新;這不會把它變成eval。
LayerNorm:改成在同一筆資料內計算
同樣是這個3×2矩陣,BN沿每一欄看三筆資料;LayerNorm(2)則沿每一列的最後兩個特徵計算平均與變異數。
| 操作 | 本例統計量來自哪裡 | 是否使用running統計量 |
|---|---|---|
| BatchNorm訓練,2D輸入 | 每欄跨三筆樣本 | 前向用batch,另更新running |
| BatchNorm推論,本例設定 | 訓練過程累積的各欄統計量 | 使用running |
| LayerNorm(2) | 每筆自己的兩個特徵 | 不使用running |
第一筆[1,2]的列平均為1.5、變異數為0.25。若關閉LN的affine參數,用同樣epsilon=1e−5,會得到約[-0.999980001, 0.999980001]。不需要另外兩筆樣本幫它估平均。
這裡關閉affine是為了把算式看清楚;PyTorch預設LayerNorm若啟用elementwise affine,gamma與beta的形狀對應normalized_shape。對LayerNorm(2),通常各有兩個元素,不是整個layer只共用一個scalar縮放與位移。
「不依賴batch」也不等於任何縮放都完全不影響結果。忽略epsilon、沒有affine時,正比例放大輸入會保留標準化方向;負比例會翻轉符號。例如[1,3]與[-2,-6]的標準化方向相反。有限epsilon下,即使正比例縮放,也不一定完全相同。
BN和LN改的是不同的統計範圍,不能只因為其中一個不追蹤running,就宣稱它在所有任務都更穩定或更準。
教材曲線能告訴你什麼,不能告訴你什麼?
圖6|D2L PyTorch BNLeNetScratch原圖,Fashion-MNIST、SGD lr=0.1、batch=128、10 epochs。兩個卷積區塊與兩個隱藏全連接層使用BN及sigmoid。藍/橘線是來源helper聚合的train/val交叉熵,綠線另為val accuracy。完整SVG轉PNG,來源D2L CC BY-SA 4.0;資料署名見文末。不是本站重跑。
圖7|D2L PyTorch BNLeNet內建BN版本的另一個run,同為lr=0.1、batch=128、10 epochs。曲線量的意義同圖6;沒有同seed無BN控制組,不能據此量化BN帶來多少提升,或說手寫與內建逐步完全等價。來源:D2L CC BY-SA 4.0;完整原圖保留。
來源手寫版實際用torch.is_grad_enabled()切換統計量分支,且moving variance沿用除以N的估計;這和本文內建BN的training旗標及unbiased running variance不同。它在教材指定Trainer流程中配合grad/no_grad運作,不能直接當作通用的train/eval範本複製。
這兩張來源圖的val是Fashion-MNIST官方test split在helper裡的名稱,並非另外切出的驗證集;畫圖時先取batch scalar,再平均,不能叫作整個split逐樣本精確加權平均。來源初始化還有先前向materialize lazy layers、再初始化權重的流程,可能接觸BN buffer;本篇的單批手算不是該模型當年的完整初始狀態。
BatchNorm在2015年提出,LayerNorm在2016年提出,是深度網路訓練工具演進的重要部分。BN原論文以internal covariate shift作動機,後續有不同解釋與討論;理解它的具體計算,比把一個直覺當成唯一已證明機理更有幫助。
實跑:把公式、模式與計算方向逐一對上
本次環境是WSL、Python 3.10.12、NumPy 1.26.3、PyTorch 2.3.1+cu118,運算固定CPU float64。安裝對應版本後,把下列程式存成normalization_checks.py,執行python normalization_checks.py。套件含CUDA標記不代表本次用了GPU。
程式只有一次BN訓練模式前向,gamma/beta是手設值,沒有做optimizer更新;接著檢查eval與LN,再驗20層固定bias的scalar sigmoid鏈。它沒有訓練分類器、重跑來源曲線或測泛化。
import numpy as np
import torch

print(f"numpy={np.__version__} torch={torch.__version__} device=cpu dtype=float64")
X = np.array([[1., 2.], [3., 0.], [5., 4.]])
gamma = np.array([2., .5])
beta = np.array([-1., 1.])
eps, momentum = 1e-5, .1
mean = X.mean(axis=0)
biased_var = X.var(axis=0, ddof=0)
unbiased_var = X.var(axis=0, ddof=1)
expected_train = (X - mean) / np.sqrt(biased_var + eps) * gamma + beta
bn = torch.nn.BatchNorm1d(2, eps=eps, momentum=momentum, affine=True,
                          track_running_stats=True, dtype=torch.float64)
with torch.no_grad():
    bn.weight.copy_(torch.tensor(gamma))
    bn.bias.copy_(torch.tensor(beta))
x = torch.tensor(X, dtype=torch.float64)
bn.train()
with torch.no_grad():
    actual_train = bn(x).numpy()
assert np.allclose(actual_train, expected_train, atol=1e-12, rtol=0)
expected_running_mean = momentum * mean
expected_running_var = (1 - momentum) * np.ones(2) + momentum * unbiased_var
assert np.allclose(bn.running_mean.numpy(), expected_running_mean, atol=1e-12, rtol=0)
assert np.allclose(bn.running_var.numpy(), expected_running_var, atol=1e-12, rtol=0)
assert bn.num_batches_tracked.item() == 1
bn.eval()
expected_eval = (X - expected_running_mean) / np.sqrt(expected_running_var + eps) * gamma + beta
with torch.no_grad():
    actual_eval = bn(x).numpy()
    alone_eval = bn(x[:1]).numpy()
    mixed_eval = bn(torch.cat([x[:1], torch.tensor([[100., -100.]], dtype=torch.float64)])).numpy()
assert np.allclose(actual_eval, expected_eval, atol=1e-12, rtol=0)
assert np.array_equal(alone_eval[0], mixed_eval[0])
print("batch_mean=", mean.tolist())
print("batch_variance_biased=", np.round(biased_var, 9).tolist())
print("batch_variance_unbiased=", unbiased_var.tolist())
print("BN_train_output=", np.round(actual_train, 9).tolist())
print("BN_train_column_mean_after_affine=", np.round(actual_train.mean(axis=0), 9).tolist())
print("BN_running_mean_after_one_batch=", bn.running_mean.tolist())
print("BN_running_variance_after_one_batch=", bn.running_var.tolist())
print("BN_eval_output=", np.round(actual_eval, 9).tolist())
print("BN_eval_first_sample_batch_composition_invariant=", True)
ln = torch.nn.LayerNorm(2, eps=eps, elementwise_affine=False, dtype=torch.float64)
row_mean = X.mean(axis=1, keepdims=True)
row_var = X.var(axis=1, ddof=0, keepdims=True)
expected_ln = (X - row_mean) / np.sqrt(row_var + eps)
with torch.no_grad():
    actual_ln = ln(x).numpy()
    alone_ln = ln(x[:1]).numpy()
assert np.allclose(actual_ln, expected_ln, atol=1e-12, rtol=0)
assert np.array_equal(alone_ln[0], actual_ln[0])
print("LayerNorm_rowwise_output=", np.round(actual_ln, 9).tolist())
print("LayerNorm_first_sample_batch_composition_invariant=", True)
# A constructed scalar chain: preactivations all zero, weights1, fixed biases.
u = torch.tensor(0., dtype=torch.float64, requires_grad=True)
h = u
for layer in range(20):
    h = torch.sigmoid(h - (0. if layer == 0 else .5))
h.backward()
expected_chain = .25 ** 20
assert np.isclose(u.grad.item(), expected_chain, atol=0., rtol=1e-12)
print(f"constructed20sigmoid_chain_input_gradient={u.grad.item():.15e}")
print("scope=one CPU BN batch with biased forward/unbiased running variance, fixed affine; eval/LN checks and constructed scalar chain only; no training fit, benchmark, or general vanishing-gradient guarantee")
本次實際輸出:
numpy=1.26.3 torch=2.3.1+cu118 device=cpu dtype=float64
batch_mean= [3.0, 2.0]
batch_variance_biased= [2.666666667, 2.666666667]
batch_variance_unbiased= [4.0, 4.0]
BN_train_output= [[-3.44948515, 1.0], [-1.0, 0.387628712], [1.44948515, 1.612371288]]
BN_train_column_mean_after_affine= [-1.0, 1.0]
BN_running_mean_after_one_batch= [0.30000000000000004, 0.2]
BN_running_variance_after_one_batch= [1.3, 1.3]
BN_eval_output= [[0.227876504, 1.789349181], [3.736095089, 0.912294535], [7.244313673, 2.666403827]]
BN_eval_first_sample_batch_composition_invariant= True
LayerNorm_rowwise_output= [[-0.999980001, 0.999980001], [0.999997778, -0.999997778], [0.999980001, -0.999980001]]
LayerNorm_first_sample_batch_composition_invariant= True
constructed20sigmoid_chain_input_gradient=9.094947017729282e-13
scope=one CPU BN batch with biased forward/unbiased running variance, fixed affine; eval/LN checks and constructed scalar chain only; no training fit, benchmark, or general vanishing-gradient guarantee
BN與LN的數值都和NumPy按指定軸手寫的公式比對;mean、兩種variance與running更新也各自核對,不是只看最後一個輸出。batch_composition_invariant=True檢查的是本例固定running stats的BN與逐列LN,不是任意模式或所有硬體的逐bit保證。
末尾sigmoid鏈的input gradient與0.25^20一致。這把局部導數連乘具體化,沒有證明加入BN就能修復這條鏈,或所有20層網路都一定出現相同梯度。
訓練診斷,按可觀察的量往回查
保存BN模型時,要連running buffers一起保存。它們不是gamma/beta那種經梯度學習的參數,但仍是推論狀態的一部分。若只複製可訓練權重,可能無法重現原本eval結果。
也要把優化問題與泛化問題分開。訓練loss降不下去,先檢查資料、loss、梯度與更新;訓練很好、驗證變差,才接續檢查切分、容量與正則化。不要用Normalization、Dropout或某個優化器的名稱,取代對實際流程的檢查。
原圖授權與延伸閱讀
圖1、2來自Andrej Karpathy/CS231n實際教材repo中的原始toy圖,依固定版本MIT LICENSE使用,完整聲明附於文末。完整圖轉PNG,手機先留全圖再加既有面板放大,封面完整等比縮放加白邊;沒有重畫點、箭頭、曲線或座標。該授權不推及同章引用的第三方論文圖片或資料集照片。
圖3、6、7來自《Dive into Deep Learning》,作者Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola;原圖完整轉白底PNG,依英文書固定版本LICENSE採CC BY-SA 4.0,上述圖像改作也以相同條件提供。
圖4、5來自Google ML Crash Course的activation functions章,依原頁內容CC BY 4.0署名Google並連回來源,保留完整原PNG。這些圖像授權說明不把本站獨立正文冒稱為教材翻譯。
Fashion-MNIST資料作者為Han Xiao、Kashif Rasul、Roland Vollgraf/Zalando Research,資料集MIT完整聲明亦附於文末;本文展示D2L產生的指標曲線,沒有複製衣物照片或重新發布資料集。
- CS231n:Neural Networks Part 2:輸入預處理、初始化與兩張toy圖;部分來源概括需依本文限定條件理解。
- D2L:Numerical Stability and Initialization:sigmoid導數與初始化推導。
- D2L:Batch Normalization:來源模型、各框架程式與方法動機討論。
- Google:Activation Functions:tanh與ReLU原圖。
- Batch Normalization原論文與Layer Normalization原論文:歷史與方法原始來源;本文未重刊其論文圖表。
- PyTorch v2.3.1 BatchNorm原碼與LayerNorm原碼:本篇實跑版本的模式、buffer與參數設定。
CS231n實際MIT授權全文:
The MIT License (MIT)

Copyright (c) 2015 Andrej Karpathy

Permission is hereby granted, free of charge, to any person obtaining a copy
of this software and associated documentation files (the "Software"), to deal
in the Software without restriction, including without limitation the rights
to use, copy, modify, merge, publish, distribute, sublicense, and/or sell
copies of the Software, and to permit persons to whom the Software is
furnished to do so, subject to the following conditions:

The above copyright notice and this permission notice shall be included in all
copies or substantial portions of the Software.

THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR
IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY,
FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE
AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER
LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM,
OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE
SOFTWARE.
Fashion-MNIST實際MIT授權全文:
The MIT License (MIT) Copyright © 2017 Zalando SE, https://tech.zalando.com

Permission is hereby granted, free of charge, to any person obtaining a copy of this software and associated documentation files (the “Software”), to deal in the Software without restriction, including without limitation the rights to use, copy, modify, merge, publish, distribute, sublicense, and/or sell copies of the Software, and to permit persons to whom the Software is furnished to do so, subject to the following conditions:

The above copyright notice and this permission notice shall be included in all copies or substantial portions of the Software.

THE SOFTWARE IS PROVIDED “AS IS”, WITHOUT WARRANTY OF ANY KIND, EXPRESS OR IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY, FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM, OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE SOFTWARE.
留言0
登入後就能留言。
登入