
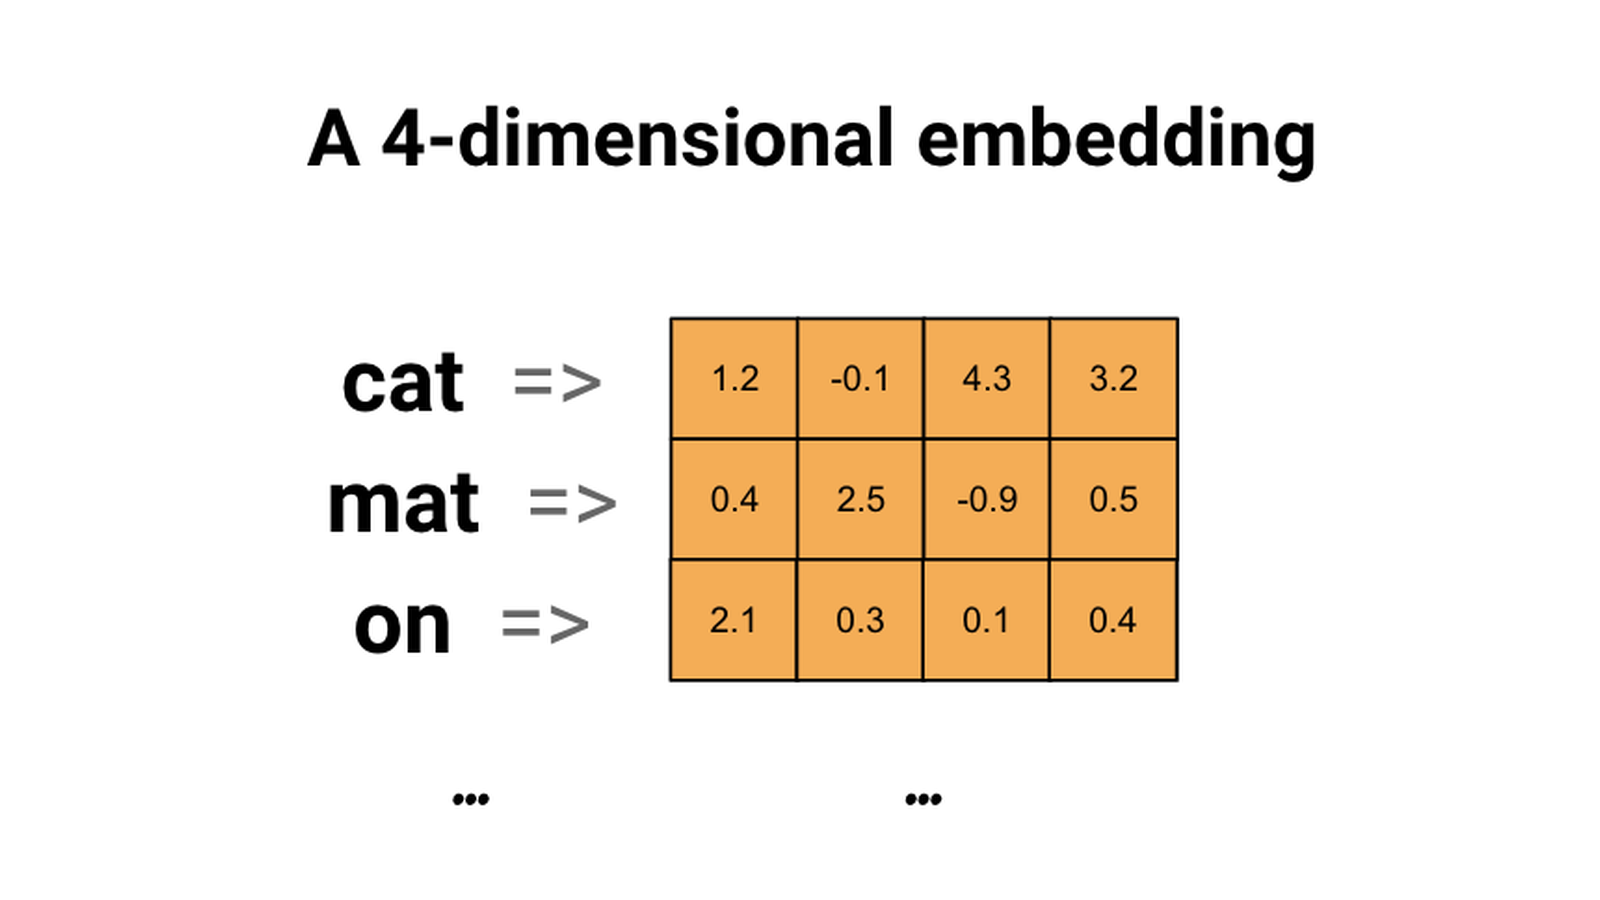
上一篇介紹了每個詞如何對應一個向量。但客服收到的是一段訊息,分類器要判斷的是「退款問題」還是「配送問題」。文件長短不同,裡面也不只一個詞,不能直接把詞向量表當成每份文件的分類輸入。
我們需要另一個步驟:把一串詞變成一組固定長度的文件特徵,再讓分類器學這些特徵與標籤的關係。平均詞向量和 Doc2Vec 都能提供固定長度表示,但它們取得表示的方式不同;遇到從未見過的文件時,工作也不同。
這篇會把「學表示、取得新文件向量、訓練分類器、評估」拆開。 實作使用 14 份人工客服文件,真正執行小型 Doc2Vec 訓練與推論;它能檢查流程和參數更新,不能代表真實客服的分類成效。
先說清楚,一筆樣本是什麼
先不要選 embedding 模型。假設任務是把一張客服工單分到退款或配送佇列,就應先決定文件是整張工單、第一則訊息,還是每一次回覆。
如果整段對話包含客服後來寫出的處理結果,而模型預計在第一則訊息進來時就分類,把整段對話拿去訓練會讓模型看到部署時拿不到的線索。這種問題不是更換向量模型就能解決。
標籤粒度也要一致。一份訊息同時提到退款和物流時,任務是單選、允許多個標籤,還是先轉交人工?這些決定會改變資料與分類器,不能只靠最後一層的維度猜測。
本篇限定為人工建立的單選二分類:0 是退款、1 是配送。先固定 8 份訓練、2 份驗證、4 份測試文件,再建立任何可學習的文字表示。
| 階段 | 可以做的事 | 不該混入的事 |
|---|---|---|
| train | 建立本任務詞表、學表示、用標籤 fit 分類器 | 利用 test 分數反覆改特徵後仍稱未碰測試 |
| validation | 比較候選設定、決定閾值與停止條件 | 把選擇後的成績當成最後一次獨立估計 |
| test | 在設定固定後估計表現 | 看到結果再挑最好的模型,卻沿用同一分數報喜 |
真實任務還要考慮同一客戶、多則同工單、近乎重複的文件與時間。如果同一段對話被拆到兩邊,只維持類別比例的 stratified split 並不能讓兩邊獨立。
平均詞向量:先做一個可核算的文件表示
最簡單的做法,是先取得文件內每個有效 token 的詞向量,再逐維相加取平均。
文件向量 = 有效 token 向量的總和 / 有效 token 出現次數
這裡數的是出現次數,不是不同詞的種類數。如果同一個詞出現三次,它就參與三次。若改成詞頻、IDF 或其他加權,權重及分母必須另外寫清楚。
用三個完全手設的二維向量驗算:
「我 喜歡 你」的向量是 [2/3, 2/3]。「你 喜歡 我」也是 [2/3, 2/3]。兩句角色不同,但這個平均看不到排列。把整句重複一次,六份向量的平均仍相同,所以平均本身也不保留原始文件長度。
這個結果不是模型訓練失敗,而是聚合操作本來就對排列不變。換成品質更好的固定詞向量,也不會讓同一組 token 的平均突然知道誰喜歡誰。
平均仍可作為簡單基線:向量長度固定,計算容易,也能接到常見分類器。但否定範圍、語序與多個主題被壓在一起的問題,需要依任務另行處理。不能把「能算出一個向量」直接解讀成「保留了文件全部意思」。
未知詞與空文件,不能悄悄交給平均
假設手設詞表沒有「黑洞」。「我 黑洞」若只平均已知詞,結果是 [1, 0];有效詞比例是 1/2。若先把未知詞補零再除以全部兩個 token,則是 [0.5, 0]。兩種規則不同,不能共用一個沒有說明的 mean 名稱。
本篇手算函式採用「僅平均已知詞」,並一起回傳 coverage、有效詞數和總詞數。全部未知或空文件則回傳零向量與明確旗標,不做除以零。
零向量是這段程式的處理約定,不是「這份文件沒有情緒」的證據。 兩份不同的全未知文件都得到零,也不表示它們的意思相同。實際系統可以拒絕低 coverage、送人工、使用 UNK,或改用具子詞機制的模型,但要把規則視為設計的一部分。
外部預訓練詞向量也不是天然適合所有場景。新聞語料、商品評論和客服縮寫的分布不同,語料時間與資料重合也會影響評估。若在本任務重新訓練或微調表示,就要交代哪些文字參與了更新。
Doc2Vec:讓文件自己也有可學習的參數
Le 與 Mikolov 在 2014 年提出 Paragraph Vector。雖然名稱叫 paragraph,方法可用在句子、段落或文件,不是限定只能輸入一個段落。
關鍵改變是:不只詞有向量,文件的識別標記也對應一個可學習向量。模型透過文件內的詞預測任務,讓這個向量參與解釋文件內容。
這個文件標記不是退款、配送或正負情緒標籤。Gensim 的 TaggedDocument(words, tags) 裡,words 是 token 串,tags 通常是獨立文件 ID,例如 t01。同一份文件抽出的不同訓練片段,共享它自己的文件向量;不同文件有各自的參數。
如果把所有退款文件都直接共用 tag 退款,你就改變了參數共享方式,並把已知類別帶進表示。那不是本篇使用的「每文件一個獨立 ID」設定。
PV-DM:文件向量與局部上下文一起預測
PV-DM 把文件向量和局部詞向量組合,用來預測詞。文件向量在不同窗口中反覆出現,提供目前局部詞以外的線索;詞向量則跨文件共享。
組合可以採平均、加總或串接,具體取決於定義及實作。原論文實驗使用串接,可保留局部上下文的槽位差異;平均組合則不保留這個局部組合內的排列。不能把「Doc2Vec」概括成一定記得完整文件語序。
PV-DBOW:用文件向量預測文件中的詞
PV-DBOW 的基本版本不把局部詞向量當輸入,而是從文件抽出要預測的詞,讓文件向量參與這個預測。它不是先把詞向量平均後改個名字。
在 Gensim,dm=0 選 PV-DBOW;dbow_words=0 時不額外訓練輸入詞向量。因此 model.wv 裡有詞和向量列,不代表這些列已受過語意訓練。若需要同時做詞向量訓練,dbow_words=1 又是另一個設定。
本篇實作採基本 DBOW,分開檢查文件向量、輸出參數與輸入詞表。文件與輸出參數確實改變;輸入詞向量保持初值。所以後面的文件分類不會拿這份未訓練的 wv 去假裝平均語意詞向量。
新文件沒有既有 ID,它的向量怎麼來?
對訓練時已存在的文件,model.dv['t01'] 可以查到共同訓練後保存的文件參數。但一張新的客服工單不在原來的 ID 表中,不能只查一列就結束。
Gensim infer_vector 會建立一個臨時文件向量,再用新文件自己的文字作若干次最佳化,調整這個臨時向量。過程固定已學的詞向量與輸出權重,不需要這張新工單的分類標籤。
| 操作 | 改動什麼? | 是否需要分類標籤? |
|---|---|---|
| Doc2Vec 表示訓練 | 文件參數及相關預測參數;詞向量是否更新依模式 | 不需要退款/配送標籤 |
| 新文件 infer_vector | 臨時的新文件向量 | 不需要 |
| 下游分類器 fit | 分類器的權重與偏置 | 需要 train 標籤 |
| 固定分類器 predict | 產生類別或分數 | 不需要待預測文件標籤 |
這是一段最佳化推論,不是一次普通查表,也不等於把整個表示模型重新訓練。新向量回傳後,Gensim 不會自動替它新增一個永久 dv tag。
即使對同一份已知文件重新 infer,也不必和原本 bulk training 的 dv 完全相同。本篇的 t01 兩個向量 L2 距離約為 0.228716。這是不同取得過程的實際差異,不是證明其中一個語意比較好。
還有一個容易誤判的情況:全部 token 都不在詞表中。這時沒有有效詞預測更新,Gensim 4.3.3 可能回傳初始化向量,而非零向量。本篇只輸入「黑洞」的實跑,回傳值與初始化完全相同,norm 約 0.106044。非零不代表模型理解了這個詞。
固定模型的權重,也不表示所有隨機狀態都靜止。推論可能消耗 RNG,重複推論可能有差異;增加 epochs 不是語意品質保證。需要重現時,應記版本、資料順序、單工設定、PYTHONHASHSEED、模型 seed 及推論設定,而不是只貼一個 seed 數字。
表示接上分類器,先檢查 fit 的邊界
文件表示準備好後,可把每份文件的向量排成 文件數×特徵數 的矩陣,交給 Logistic Regression。分類器學的是特徵和標籤的關係,不會自動替上游補回丟掉的語序或未知詞訊號。
文件表示和輸出類別數是不同選擇。二元分類可以從一個分數加上閾值得到決策;互斥多類可以對多個類別分數做softmax再選最大者。本文只實作0/1二元分類,不把右側多類頭說成另一個已訓練模型,也不假定0.5對任何應用都是最佳閾值。
本篇用相同的 8/2/4 文件 ID 走兩條實際路徑:
- TF-IDF:只用 train 建詞表與 IDF,再 transform validation/test;分類器也只 fit train labels。
- Doc2Vec:只用 train 的 words/tags 訓練 DBOW;固定它之後,對 train、validation、test 都用 infer 取得分類特徵,再只用 train labels fit 分類器。
這裡連分類器訓練文件也用 infer,是刻意讓文件特徵經過相同的取得路徑。不是所有 Doc2Vec 應用都必須如此;如果用已保存 dv 訓練、用 infer 部署,就應另外檢查兩種特徵的差異。
程式固定 C=1,沒有搜尋超參數,也沒有根據 test 選模型。驗證資料只讀出結果,沒有在這個教學例中觸發調參。真實專案若要選設定,應在 validation 或合理的交叉驗證內完成,再做最後 test。
Doc2Vec 的新文件推論使用新文件自己的文字,不等於把所有 test 文件加入全域表示訓練。兩者要分清:前者固定共享權重、只求當前文件的表示;後者讓未來評估文本影響了共享模型。
原論文和官方教學,為什麼成績不能直接拼在一起?
原始 Paragraph Vector 論文的 IMDB 實驗,用 75,000 份訓練文字學表示:25,000 份有標籤 train,加上 50,000 份未標註資料。25,000 份 test 則固定其餘參數,另行推論文件向量。
論文下游使用含 50 個 hidden units 的神經網路及 logistic 輸出,不是單純把所有結果都歸給線性 Logistic Regression。作者報告的 7.42% 是那套協定的 error rate,不是本文實跑值。
Gensim 官方 IMDB 教學則讓全部 100,000 份文件文字參與 Doc2Vec 訓練,包括 test 文字;其分類評估直接取保存的 test dv。分類器 fit 只用 train sentiments,test sentiments 用於算 error。
因此準確說法是「評估文本參與無監督表示學習」,而不是沒有證據就指控「test 標籤已被拿去訓練」。這可以是一種 transductive 設定,但不等於只看訓練資料、面向未來未知文件的 inductive 部署評估。
教學頁顯示的文件版本是 4.3.3,內嵌訓練 logs 則來自 4.3.1.dev0/Python 3.8.17。它自行說明未達原論文最佳 error,不能把兩個數字當成本站在同一環境、公平重跑的排名。本文只連回來源,不重刊原結果表。
即使沒有把 test labels 拿去 fit,如果看過多個 test 成績後再挑最佳設定,test 也已參與選擇。這和直接拿標籤訓練是不同問題,但都不能再稱完全未觸碰的最後估計。
跑一個完整且可檢查的小例子
本篇已在 WSL/Linux 的獨立環境實際執行:Python 3.10.12、Gensim 4.3.3、NumPy 1.26.4、SciPy 1.13.1、scikit-learn 1.5.1,CPU。隔離環境避免為了 Gensim 4.3.3 的 scipy<1.14 要求改動既有專案環境。
把下方完整程式存成 document_vector_checks.py,另建環境安裝固定版本,再從新的 Python process 執行:
python3 -m venv .venv-doc2vec
source .venv-doc2vec/bin/activate
python -m pip install gensim==4.3.3 numpy==1.26.4 scipy==1.13.1 scikit-learn==1.5.1 smart-open==9.0.1 joblib==1.6.0 threadpoolctl==3.7.0 cloudpickle==3.1.2 wrapt==2.5.2
PYTHONHASHSEED=0 OPENBLAS_NUM_THREADS=1 OMP_NUM_THREADS=1 python document_vector_checks.py
本次確實建立環境、安裝依賴並執行程式;不是只提供未跑過的指令。實作把推論前的 sampling RNG 依文件位置重設,是為了這個固定環境的機制重現,不保證跨硬體與所有版本逐 bit 一致。Gensim 使用的向量陣列主要是 float32,不能把本例標成上一篇的 float64 算例。
"""Artificial corpus: audit aggregation, train-only fitting and Doc2Vec inference.

Run with PYTHONHASHSEED=0 and the adjacent pinned requirements.
No pretrained semantic model, corpus benchmark, tuning or model ranking.
"""
import hashlib
import json
import os
import platform

import gensim
import numpy as np
import scipy
import sklearn
from gensim.models.doc2vec import Doc2Vec, TaggedDocument
from gensim.models.keyedvectors import pseudorandom_weak_vector
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import confusion_matrix, f1_score
from sklearn.pipeline import make_pipeline


# Deliberately pretokenized teaching data, not a blind real-world evaluation.
ROWS = [
    ("t01", "train", "退款 申請 訂單 取消", 0),
    ("t02", "train", "退費 退款 金額 信用卡", 0),
    ("t03", "train", "訂單 取消 退費 申請", 0),
    ("t04", "train", "信用卡 金額 退款 查詢", 0),
    ("t05", "train", "物流 包裹 配送 查詢", 1),
    ("t06", "train", "包裹 到貨 地址 配送", 1),
    ("t07", "train", "物流 地址 訂單 查詢", 1),
    ("t08", "train", "配送 到貨 包裹 訂單", 1),
    ("v01", "validation", "退款 信用卡 申請", 0),
    ("v02", "validation", "到貨 物流 地址", 1),
    ("e01", "test", "退費 金額 訂單", 0),
    ("e02", "test", "取消 退款 黑洞", 0),
    ("e03", "test", "配送 地址 查詢", 1),
    ("e04", "test", "物流 包裹 到貨", 1),
]


def mean_known(words, table):
    known = [table[w] for w in words if w in table]
    vector = np.mean(known, axis=0) if known else np.zeros(2)
    return {"vector": vector.tolist(), "known": len(known),
            "total": len(words), "coverage": len(known) / len(words) if words else 0,
            "empty_or_all_oov": not known}


def weight_hashes(model):
    return {name: hashlib.sha256(array.tobytes()).hexdigest()
            for name, array in [("wv", model.wv.vectors),
                                ("dv", model.dv.vectors),
                                ("syn1neg", model.syn1neg)]}


def evaluate(classifier, features, rows):
    predicted = classifier.predict(features).tolist()
    actual = [r[3] for r in rows]
    return {"ids": [r[0] for r in rows], "actual": actual,
            "predicted": predicted,
            "confusion_true_rows_predicted_columns": confusion_matrix(
                actual, predicted, labels=[0, 1]).tolist(),
            "support_by_class": [actual.count(0), actual.count(1)],
            "macro_f1": float(f1_score(actual, predicted, average="macro",
                                        labels=[0, 1], zero_division=0))}


def run():
    if os.environ.get("PYTHONHASHSEED") != "0":
        raise RuntimeError("Launch a new Python process with PYTHONHASHSEED=0")
    train = [r for r in ROWS if r[1] == "train"]
    validation = [r for r in ROWS if r[1] == "validation"]
    test = [r for r in ROWS if r[1] == "test"]
    assert len({r[0] for r in ROWS}) == len(ROWS)
    assert len({r[2] for r in ROWS}) == len(ROWS)

    table = {"我": [1., 0.], "你": [0., 1.], "喜歡": [1., 1.]}
    examples = {name: mean_known(words.split(), table) for name, words in [
        ("original", "我 喜歡 你"), ("reordered", "你 喜歡 我"),
        ("repeated", "我 喜歡 你 我 喜歡 你"),
        ("partial_oov", "我 黑洞"), ("all_oov", "黑洞"), ("empty", "")]}
    assert examples["original"]["vector"] == examples["reordered"]["vector"]
    assert examples["original"]["vector"] == examples["repeated"]["vector"]

    tfidf = make_pipeline(TfidfVectorizer(tokenizer=str.split, token_pattern=None,
                                         lowercase=False),
                          LogisticRegression(C=1., random_state=0, max_iter=1000))
    tfidf.fit([r[2] for r in train], [r[3] for r in train])
    tfidf_vocab = tfidf.named_steps["tfidfvectorizer"].vocabulary_
    assert "黑洞" not in tfidf_vocab

    tagged = [TaggedDocument(r[2].split(), [r[0]]) for r in train]
    model = Doc2Vec(vector_size=12, dm=0, dbow_words=0, min_count=1,
                    sample=0, hs=0, negative=3, ns_exponent=.75,
                    workers=1, seed=41, epochs=60, alpha=.025, min_alpha=.005)
    model.build_vocab(tagged)
    initialized = weight_hashes(model)
    model.train(tagged, total_examples=len(tagged), epochs=model.epochs)
    trained = weight_hashes(model)
    assert initialized["dv"] != trained["dv"]
    assert initialized["syn1neg"] != trained["syn1neg"]
    assert initialized["wv"] == trained["wv"]  # DBOW, dbow_words=0.
    assert set(model.dv.index_to_key) == {r[0] for r in train}
    assert "黑洞" not in model.wv.key_to_index

    # Use the same inference path even for classifier-training documents.
    # Reset per-document sampling RNG explicitly; no cross-platform bit promise.
    inferred = {}
    coverage = {}
    for index, row in enumerate(ROWS):
        words = row[2].split()
        model.random.seed(5000 + index)
        inferred[row[0]] = model.infer_vector(words, alpha=.025,
                                               min_alpha=.005, epochs=40)
        coverage[row[0]] = sum(w in model.wv for w in words) / len(words)
    after_inference = weight_hashes(model)
    assert trained == after_inference
    assert set(model.dv.index_to_key) == {r[0] for r in train}

    oov_words = ["黑洞"]
    initial_oov = pseudorandom_weak_vector(model.vector_size,
                                          seed_string=" ".join(oov_words))
    model.random.seed(9000)
    oov = model.infer_vector(oov_words, alpha=.025, min_alpha=.005, epochs=40)
    assert np.array_equal(oov, initial_oov)
    assert np.linalg.norm(oov) > 0
    assert trained == weight_hashes(model)

    d2v_classifier = LogisticRegression(C=1., random_state=0, max_iter=1000)
    d2v_classifier.fit(np.stack([inferred[r[0]] for r in train]),
                       [r[3] for r in train])
    results = {}
    for split, rows in [("validation", validation), ("test", test)]:
        results[split] = {
            "tfidf": evaluate(tfidf, [r[2] for r in rows], rows),
            "doc2vec": evaluate(d2v_classifier,
                                np.stack([inferred[r[0]] for r in rows]), rows)}
    return {
        "environment": {"python": platform.python_version(),
                        "gensim": gensim.__version__, "numpy": np.__version__,
                        "scipy": scipy.__version__, "sklearn": sklearn.__version__,
                        "device": "CPU", "PYTHONHASHSEED": "0"},
        "rows": ROWS, "hand_set_mean_examples": examples,
        "train_only": {"documents": len(train), "vocabulary_size": len(model.wv),
                       "tfidf_vocabulary": sorted(tfidf_vocab),
                       "dv_tags": model.dv.index_to_key,
                       "d2v_shape": [len(train), model.vector_size]},
        "actual_training": {"dv_changed": initialized["dv"] != trained["dv"],
                            "output_changed": initialized["syn1neg"] != trained["syn1neg"],
                            "wv_unchanged_dbow_words_0": initialized["wv"] == trained["wv"]},
        "inference": {"coverage": coverage, "weights_before": trained,
                      "weights_after": after_inference,
                      "known_weights_unchanged": trained == after_inference,
                      "new_tags_added": False,
                      "train_t01_bulk_vs_inferred_l2": float(np.linalg.norm(
                          model.dv["t01"] - inferred["t01"])),
                      "all_oov_matches_initialization": True,
                      "all_oov_norm": float(np.linalg.norm(oov))},
        "results": results,
        "scope": "Artificial known teaching corpus, fixed C/no selection. Actual tiny DBOW training/inference; not IMDB, semantic quality, fair model ranking, or blind generalization benchmark.",
    }


if __name__ == "__main__":
    print(json.dumps(run(), ensure_ascii=False, indent=2, allow_nan=False))
檢查輸出時,先看這些欄位,而不是只看 F1:
- 8 份文件、13 個詞、8 個 train tags、12 維文件向量
- train/test 沒有在詞表與 tag 表混用
- dv/output 有改;wv 未改
- DBOW 的實際參數更新符合這個設定
- true,三套參數前後 hash 一致
- 本次 infer 沒有改掉已學權重
- false
- 新文件推論沒有自動永久加入 dv
- 2/3
- 未知的「黑洞」沒有自動成為已知語意詞
- true
- 全未知輸入的非零向量不能當理解證據
兩條分類路徑在這 2 份 validation 和 4 份 test 上都預測正確,macro F1 為 1。test 混淆矩陣的列是真實、欄是預測,兩類 support 各 2,矩陣為 [[2,0],[0,2]]。
這組資料是作者事先知道並人工編排的教學題,詞和類別關係很簡單;它不是盲測,也不是外部客服資料集。全對只證明這條小流程跑完,不支持「Doc2Vec 和 TF-IDF 一樣強」、任何語意品質排名或真實部署達標。程式完整保留失敗預測也能計算的混淆矩陣與 macro F1,沒有為結果漂亮而省略評估步驟。
若你拿自己的資料來跑,應先固定文件單位、split 和評估方式,再交代表示訓練文字、OOV 規則、推論設定、分類器與模型選擇。平均詞向量、Doc2Vec、TF-IDF 各有不同的資訊來源和限制;比較的重點,是這些差別對你的任務造成什麼影響。
主要來源與版本:
- Le、Mikolov,Distributed Representations of Sentences and Documents,ICML 2014,方法第 2.2–2.3 節及 IMDB 第 3.2 節;作者原報告與本文人工實作分開。
- Gensim Doc2Vec API,4.3.3 文件頁,DM/DBOW 參數、tags、infer_vector 與重現性。
- Gensim 4.3.3 infer_vector 原碼,臨時向量與 learn_words/learn_hidden 範圍。
- Gensim 官方 IMDB 教學,全資料表示訓練、分類器與歷史執行輸出。
- scikit-learn 1.5 評估指標,混淆矩陣、support 與 F1。
- scikit-learn 1.5 Common pitfalls:資料洩漏,fit 僅限訓練資料;本文實跑版本另明示為 1.5.1。
留言0
登入後就能留言。
登入