
上一篇把文件變成 BoW 或 TF-IDF 向量,每一欄代表一個詞彙特徵。如果訓練詞表把「退款」和「退費」當成不同詞,它們就是不同欄;這套表示不會自動知道兩者可能用在相近情境。
詞向量換了一種做法:讓每個詞對應一組可以學習的數字,再透過大量語料中的任務調整這些數字。Word2Vec 用周圍的詞建立預測任務,GloVe 擬合事先累積的詞共現統計,FastText 則讓不同詞共享字元片段的參數。
這篇的目標是讓你說清楚:向量在學什麼、數字怎麼更新,以及遇到沒看過的詞時會發生什麼。 本篇實跑的是手設分數、一次 SGD 更新、共現小矩陣與子詞合成,沒有把幾個人工數字冒充已訓練好的語意模型。
一個詞的向量,和一份文件的向量不同
先把表示的單位分開。上一篇的 TF-IDF通常是一份文件一列,欄位對應詞彙;這裡討論的靜態詞向量,則是詞表中的每個詞各有一列可學習參數。
假設詞表有 V 個詞、每詞用 d 個數字表示,最簡單的 embedding table 就是 V×d 的矩陣。遇到某個詞的 ID,就取出對應那一列。ID 只負責查表,不是語意大小;ID 100 並不比 ID 2 更重要。
用 one-hot 向量乘上這個矩陣,也會選到同一列。查表是取參數的操作,學習則發生在這些參數如何接受損失函數與梯度更新。 詞向量不是把詞的整數 ID 除以一個常數,也不等於一定對 one-hot 做 PCA。
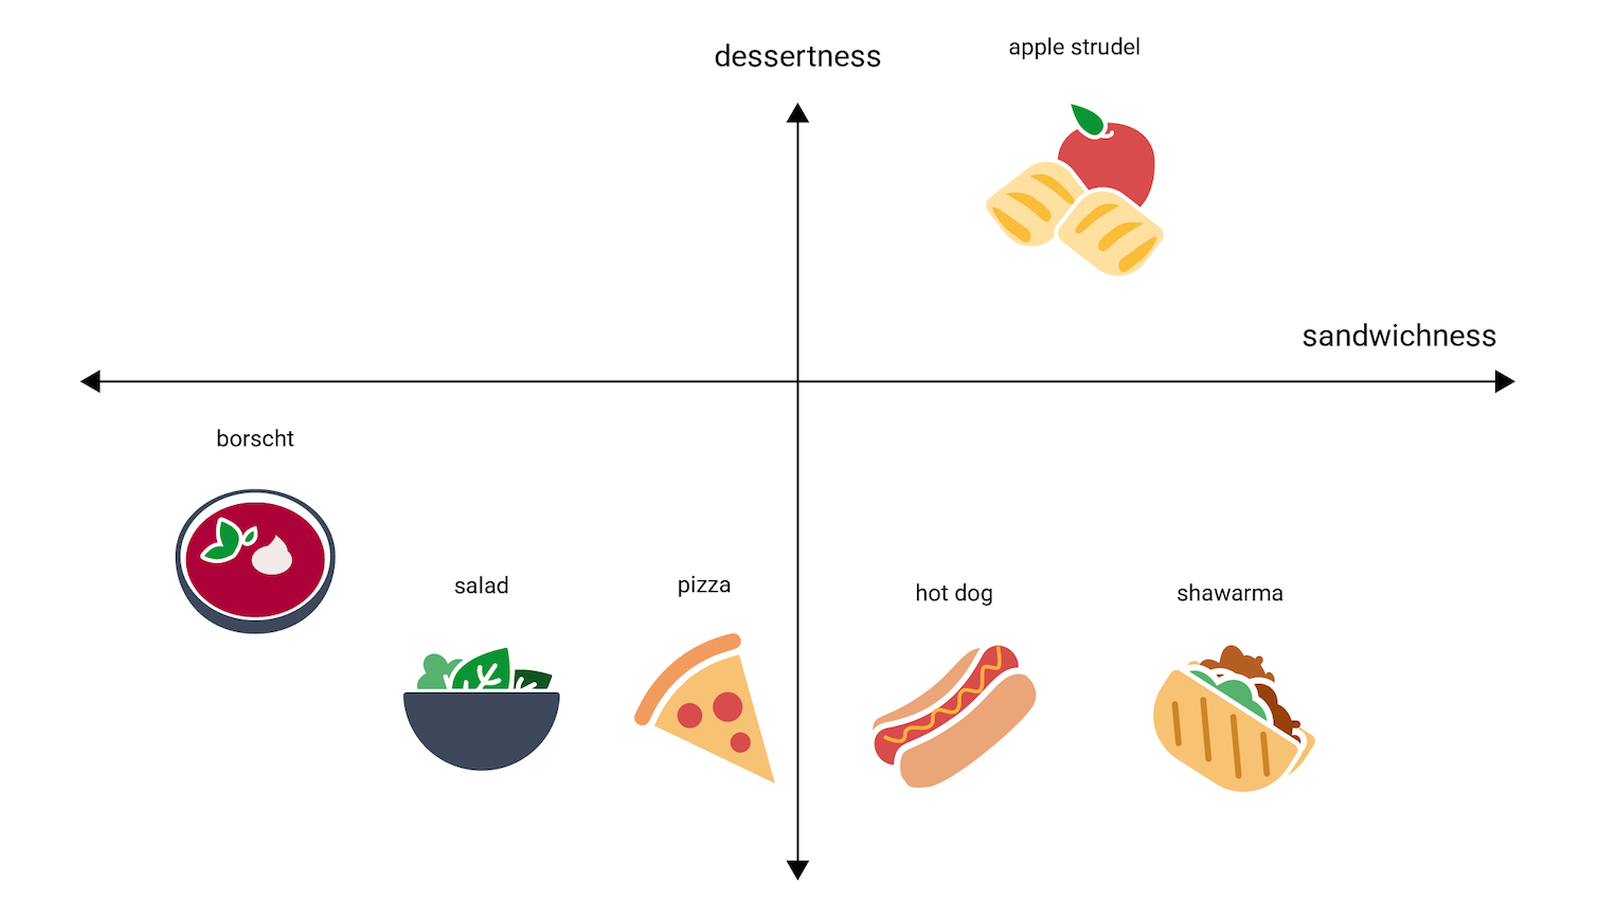
圖中的軸有直覺名稱,是為了教學。真正學到的維度受任務、語料、初始化與參數設定影響;同時對相關向量做正交旋轉,點積仍可不變,所以不能堅持「第 17 維一定代表某個固定語意」。
相近也不等於同義。「便宜」和「昂貴」可能出現在很相似的商品描述位置,卻是相反意思。共現能提供線索,但不是一份保證正確的語言知識庫。
Word2Vec:用上下文建立不需人工類別的任務
Word2Vec 是一組方法與實作選擇,不是一個唯一固定網路。2013 年的核心設計包括 CBOW 與 Skip-gram;監督訊號直接由語料中的位置產生,不需要先替每個詞標上「同義詞類別」。
以 the man loves his son 為例,Skip-gram 可以形成 (loves,the)、(loves,man)、(loves,his)、(loves,son) 等中心與上下文配對。它看的是中心附近的位置,不是只預測下一個詞。
常見 CBOW 做法先平均上下文的輸入向量,再預測中心詞;這個平均不保留上下文內部的排列。它的「bag of words」是在一個局部上下文裡組合已學向量,不是上一篇把整份文件變成詞頻表的同一個操作。
| 方法 | 拿什麼當輸入? | 預測什麼? |
|---|---|---|
| Skip-gram | 中心詞 | 周圍各位置的上下文詞 |
| CBOW | 周圍上下文的向量組合 | 中心詞 |
兩者常有輸入與輸出兩套參數表。例如 Skip-gram 用中心向量 v 和上下文向量 u 計算分數;訓練完成要輸出哪套向量,或如何合併,要看方法與實作,不能只說「模型裡一定只有每詞一列參數」。
窗口決定哪些位置成為訓練對
本文程式採用 the wide road shimmered in the hot sun 八個位置,固定左右半徑 2。各中心可配到的上下文位置數是:
2 + 3 + 4 + 4 + 4 + 4 + 3 + 2 = 26
例如 road 的上下文是 the、wide、shimmered、in。句首和句尾不足兩個鄰居時,不會憑空補出新詞。26 是這個例子的位置配對數,不是所有句子的固定值,也不是任何重複詞序列都會產生 26 種不同詞型配對。
原始 Word2Vec 還有隨機窗口與頻詞 subsampling 等選擇。隨機窗口會改變不同距離被納入的機率;頻詞 subsampling 則會減少部分常見詞出現所形成的訓練訊號。本篇固定窗口是為了手算,沒有宣稱完整重現歷史實驗配方。
點積是分數,softmax 才把整個詞表正規化
對一對中心詞與上下文詞,可以先算 s = u_context · v_center。這是相容分數,還不是「這兩個詞有幾成語意相同」。
在這個版本中,給定中心詞,所有候選上下文的條件機率總和為 1。觀察到的上下文詞若被分配較高機率,對應的負對數損失就較低。
計算上的麻煩在分母:詞表很大時,每個更新都完整計算所有詞的分數,成本也會很高。負採樣提供另一個訓練目標,讓每次更新集中在觀察到的配對與少量抽樣詞,但不能因此把兩個損失寫成完全相同的公式。
負採樣:分辨觀察到的配對與噪音配對
經典 Skip-gram with Negative Sampling,簡稱 SGNS,對一個正配對和 K 個噪音樣本,可寫成要最小化的損失:
L = −log sigmoid(s_positive)
    − Σ_k log sigmoid(−s_negative_k)

  = softplus(−s_positive) + Σ_k softplus(s_negative_k)
這是把每個配對各自放進 sigmoid 的二元判別,不是對 K+1 個候選做一次 softmax。若五個分數全是 0,一正四負的兩種損失會是:
| 目標 | 損失 | 對五個分數的梯度 |
|---|---|---|
| SGNS,加總版本 | 5×ln(2) ≈ 3.465736 | −0.5、0.5、0.5、0.5、0.5 |
| 五候選類別交叉熵 | ln(5) ≈ 1.609438 | −0.8、0.2、0.2、0.2、0.2 |
本篇程式實際算過這些值。即使把 SGNS 除以五改成 mean,也不會變成候選 softmax 的相同梯度。資料中都出現「一正、數負」,不表示訓練目標就相同。
負例來自 noise distribution,不是保證「兩個詞絕不相關」。Mikolov 等人的 2013 NEG 實驗用詞頻的 0.75 次方;FastText 2017 論文第 4.3 節則用詞頻平方根。兩個詞的頻數若是 8 和 1,正規化後的抽樣機率分別約為:
| 來源設定 | 頻數 8 的詞 | 頻數 1 的詞 |
|---|---|---|
| frequency^0.75 | 0.826293 | 0.173707 |
| frequency^0.5 | 0.738796 | 0.261204 |
這只是本篇的兩詞機率算術,沒有實際抽樣測頻率。TensorFlow 圖所屬教學又採 log-uniform sampler,並明說用 categorical cross-entropy 作簡化替代,所以不能把圖、採樣分布和 SGNS 全部混成同一套原版配方。
抽樣是否排除正類、是否允許重複,也要查具體實作。TensorFlow 教學一處說傳入 true_classes 可以排除它,但 v2.16.1 的官方 sampler 原碼說明指出它用來計算 expected counts,候選仍可能重疊;unique=True 只管候選彼此不重複,不能由此推出不撞正類。本文手設負例,不以該 API 當碰撞處理的驗證。
一次更新會改哪些向量?
先看分數的方向。正例項對分數的梯度是 sigmoid(s)−1,負例項則是 sigmoid(s)。梯度下降會嘗試拉高正例分數、降低抽到的負例分數;它不是每次把所有意思相近的詞直接拉到一起。
接著用另一個小例子看向量更新。這次是一個中心向量、三個上下文參數列,配對索引是 [0,1,1,2]:第 0 列是正例,第 1 列這個負例出現兩次,第 2 列出現一次。也就是一正三個負樣本出現次數、共四個分數,和上一個五分數比較例不同。
中心向量 c = [0.4, −0.2]
上下文 u0 = [ 0.1,  0.3]   正例
       u1 = [−0.4,  0.2]   負例,出現兩次
       u2 = [ 0.2, −0.5]   負例

配對分數 = [−0.02, −0.20, −0.20, 0.18]
同一參數列出現兩次,梯度就要把兩次貢獻累加,不能後一次覆蓋前一次。程式先用同一個前向狀態算完所有梯度,再以學習率 0.05 同步更新中心與上下文;不會先改中心,再拿新中心重算其他列的梯度。
這個人工 batch 的 SGNS sum loss 從 2.6866666433 變成 2.6653358553。它證明這一個更新的計算成立,沒有證明任意學習率都會下降,也沒有證明已學出語意。詞向量的用途來自很多訓練訊號共同調整後的表示,還需要另行評估。
GloVe:先累積詞與上下文的共現,再擬合它
GloVe 的「global」指的是先彙整整份語料的共現統計。它不是把整篇文件所有詞無條件配在一起,也不是只有 GloVe 會從整份語料學習;Word2Vec 同樣會走過語料,只是訓練資料與目標的組織方式不同。
令 X_ij 表示詞 j 落在詞 i 的上下文中所累積的權重。它是詞×上下文詞的矩陣,不是上一篇的文件×詞 TF-IDF 矩陣。原始 GloVe 實驗按詞距 d 加上 1/d;窗口範圍、是否雙向和其他預處理都會影響 X。
看本文三個詞位置 甲/乙/甲,採雙向窗口和 1/d 權重:
| 設定,列為中心、欄為上下文 | 甲→甲 | 甲→乙 | 乙→甲 | 乙→乙 |
|---|---|---|---|---|
| 半徑 1 | 0 | 2 | 2 | 0 |
| 半徑 2 | 1 | 2 | 2 | 0 |
半徑 2 多出的甲→甲,是兩個不同位置的「甲」彼此成為上下文,兩個方向各貢獻 1/2;不是把一個位置和它自己配對。這個雙向定義下 X 對稱,但除以各列總和之後,條件機率未必對稱:P(乙|甲)=2/3,P(甲|乙)=1。
可以把每個非零格的目標讀成:
預測分數 = word_vector · context_vector + word_bias + context_bias
單格損失 = f(X_ij) × (預測分數 − ln(X_ij))²

f(x) = (x / x_max)^α,若 x < x_max
       1,其他情況
上圖的 h 與這裡的 f 都是權重函數。原論文採用的一組設定是 x_max=100、α=0.75,不是任何語料都必須照用。沒有共現的零格先省略,不是先計算 ln(0) 再期待乘零自動變安全。
本篇只算一個非零格:X=2、預測分數 0.5、偏置已包含在該分數中。權重約為 0.053182959,不含額外 1/2 的單格平方損失約為 0.0019840346;對預測分數的梯度約為 −0.0205442772。這是公式算例,不是完整 GloVe 訓練。
GloVe 原文還以共現機率比值說明設計動機,可對照 2014 論文第 3 節與 Table 1。機率比值接近 1,可能是兩邊都相關,也可能兩邊都不相關,不能單看比值下語意結論。本文不重刊該原表,也不把它的已四捨五入數字當精確計算輸入。
同樣地,實際輸出向量要看定義;原 GloVe 方法把兩套詞向量相加作輸出。不能把某一套中間參數和另一模型的最終輸出,不經確認就當作可互換的座標。
FastText:讓不同詞共享字元片段
如果每個詞都完全獨立存一列參數,罕見詞能得到的更新就少;詞表以外的詞也沒有專屬的一列。FastText 的 subword 模型把一個詞表示為多個字元 n-gram 向量的組合,讓不同詞能共享部分參數。
先在詞前後加上邊界符號,where 變成 <where>。若只看字元三元片段,會得到:
<wh、whe、her、ere、re>
這些片段彼此重疊,不是把字串切成互不重疊的五份。已知詞還有自己專屬的整詞表示;原論文用特殊序列 <where> 說明它。字元片段 her 和整詞 <her> 也不相同,邊界符號有實際意義。
原方法通常取長度 3 到 6 的字元片段,本篇為了手算只示範 n=3。FastText 仍以中心和上下文的預測訊號調整參數,只是中心表示有了詞內部共享;它不是 BPE 合併規則,也不是自動中文語義斷詞器。
假設 here 沒出現在詞表,它仍有 <he、her、ere、re> 這些字元片段,可以嘗試用子詞參數組合表示;但不能憑空取出一個已訓練的專屬整詞 <here> 列。
下面是本文手設二維向量的算例,完全不是預訓練 FastText 的數值:
| 項目 | 組合方式 | 本例結果 |
|---|---|---|
| 已知 where | 五個字元片段+一個專屬整詞,共六份向量相加 | [1.5, 1.4] |
| 同一組 where 參數取平均 | 上列除以六 | [0.25, 0.233333…] |
| 未知 here | 四個字元片段;本例未提供的 <he 明訂補零 | [0.4, 0.2] |
| 同一組 here 參數取平均 | 包含零 fallback 在內,除以全部四份 | [0.1, 0.05] |
加總和平均要說清楚。論文第 3.2 節的 scoring 寫加總,第 6.3 節的 OOV 分析也提到平均;指定版本 fastText v0.9.2 的 getWordVector則回傳平均。對非零向量做正倍數縮放,不改變它和其他非零向量的 cosine,但會改變長度與點積,所以不能在所有後續運算都當成完全相同。
這個例子的零 fallback 只是為了讓每一項可以手算,不是官方 API 的缺子詞行為。真正 FastText 用 hash buckets 儲存字元片段,可能有碰撞;一個未有效學過的片段也可能映射到某個 bucket。能回傳非零向量,不等於對新詞有可靠的語意證據。
同樣地,形狀相似不保證意思相同。happy 與 unhappy 共享許多字元,卻可能有相反意思。子詞共享改善的是資訊來源,沒有保證每個罕見字串都能被理解。只載入列好的 .vec 詞表,也不等於保留了可合成所有 OOV 的完整子詞模型。
三種方法都還是靜態詞表示
| 比較面向 | Word2Vec | GloVe | FastText subword |
|---|---|---|---|
| 主要訊號 | 窗口中的預測配對 | 預先彙整的窗口共現統計 | 預測配對,加上詞內字元片段共享 |
| 本篇重點目標 | CBOW/Skip-gram;SGNS 是一種訓練選擇 | 加權平方誤差擬合 log 共現 | 用子詞構成表示,再參與預測目標 |
| 基本 word-table 的未知詞問題 | 沒有該詞的專屬已學列,需另訂 fallback | 同左 | 可嘗試以子詞組合,但有涵蓋率與品質限制 |
| 同一詞換到另一句話 | 基本查表表示仍相同 | 仍相同 | 同一字串的基本子詞組合仍相同 |
例如 bank 出現在河岸或銀行情境,這些基本靜態方法不會只因句子改變,就自動給同一詞兩個不同的 contextual vector。FastText 的字元共享也不是句內多義消歧。
若要用於實務,要確認語料領域、語言與斷詞、詞表與 OOV 比例,以及載入的是哪套參數和正規化方式。近鄰與類比可以作檢查,但還要在真正的下游任務與適當保留資料上評估;不能把訓練目標下降,當成分類、搜尋或語意理解已經過關。
用一支 CPU 程式核對三種機制
下面完整程式已在 Python 3.10.12、PyTorch 2.3.1+cu118/CPU 執行,主要計算用 float64。套件版本有 CUDA 標記,但本次沒有使用 GPU、下載語料或預訓練權重,也沒有呼叫 TensorFlow 或 fastText API。
把程式存成 embedding_checks.py,在已有 PyTorch 的環境執行 python3 embedding_checks.py。若要另建 CPU 環境,下列是 WSL/Linux 的準備方式;本次沒有重新執行套件下載安裝,實跑使用前述既有環境:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install torch==2.3.1 --index-url https://download.pytorch.org/whl/cpu
python embedding_checks.py
程式會輸出固定窗口的配對數、兩種 loss 和梯度、一次同步更新、兩種 noise 機率、共現矩陣、GloVe 單格損失,以及手設子詞合成結果。它的全部初值都可見,不以隨機向量的巧合當成語意發現。
"""Hand-set mechanism examples, not trained semantic word embeddings.

Python 3.10.12 / torch 2.3.1+cu118, CPU, float64.
No corpus download, pretrained weights, TensorFlow or fastText API execution.
"""

import json
import math
import platform

import torch
from torch.nn import functional as F


DTYPE = torch.float64


def position_pairs(tokens, radius):
    return [(i, j) for i in range(len(tokens))
            for j in range(max(0, i - radius), min(len(tokens), i + radius + 1))
            if i != j]


def sgns(scores):
    # First score is one observed pair; others are supplied noise occurrences.
    return F.softplus(-scores[0]) + F.softplus(scores[1:]).sum()


def cooccurrence(tokens, words, radius):
    index = {w: i for i, w in enumerate(words)}
    result = torch.zeros((len(words), len(words)), dtype=DTYPE)
    for i, j in position_pairs(tokens, radius):
        result[index[tokens[i]], index[tokens[j]]] += 1 / abs(i - j)
    return result


def character_trigrams(word):
    bounded = "<" + word + ">"
    return [bounded[i:i + 3] for i in range(len(bounded) - 2)]


def run():
    words = "the wide road shimmered in the hot sun".split()
    pairs = position_pairs(words, radius=2)
    assert len(pairs) == 26  # Positions, not a general unique-word-pair count.
    road_contexts = [words[j] for i, j in pairs if i == 2]
    assert road_contexts == ["the", "wide", "shimmered", "in"]

    zero_scores = torch.zeros(5, dtype=DTYPE, requires_grad=True)
    independent_loss = sgns(zero_scores)
    independent_loss.backward()
    candidate_scores = torch.zeros(5, dtype=DTYPE, requires_grad=True)
    candidate_loss = F.cross_entropy(candidate_scores[None, :], torch.tensor([0]))
    candidate_loss.backward()
    assert math.isclose(float(independent_loss), 5 * math.log(2))
    assert math.isclose(float(candidate_loss), math.log(5))
    torch.testing.assert_close(zero_scores.grad,
                               torch.tensor([-.5, .5, .5, .5, .5], dtype=DTYPE))
    torch.testing.assert_close(candidate_scores.grad,
                               torch.tensor([-.8, .2, .2, .2, .2], dtype=DTYPE))

    # One hand-set center, three context rows; negative row1 occurs twice.
    center = torch.tensor([.4, -.2], dtype=DTYPE, requires_grad=True)
    contexts = torch.tensor([[.1, .3], [-.4, .2], [.2, -.5]],
                            dtype=DTYPE, requires_grad=True)
    rows = torch.tensor([0, 1, 1, 2])  # Positive0; fixed negatives1,1,2.
    c0, u0 = center.detach().clone(), contexts.detach().clone()
    scores = contexts[rows] @ center
    before = sgns(scores)
    before.backward()
    coefficients = scores.detach().sigmoid() - torch.tensor([1., 0., 0., 0.])
    expected_c = u0[rows].T @ coefficients
    expected_u = torch.zeros_like(u0)
    expected_u.index_add_(0, rows, coefficients[:, None] * c0)
    torch.testing.assert_close(center.grad, expected_c)
    torch.testing.assert_close(contexts.grad, expected_u)
    c_grad, u_grad = center.grad.clone(), contexts.grad.clone()
    # Both updates use gradients from the SAME pre-update state.
    with torch.no_grad():
        center -= 0.05 * c_grad
        contexts -= 0.05 * u_grad
        after = sgns(contexts[rows] @ center)
    assert after < before

    frequency = torch.tensor([8., 1.], dtype=DTYPE)
    noise = {}
    for name, power in [("mikolov_2013_power_0_75", .75),
                        ("fasttext_2017_power_0_5", .5)]:
        weights = frequency.pow(power)
        noise[name] = (weights / weights.sum()).tolist()

    tiny = ["甲", "乙", "甲"]
    names = ["甲", "乙"]
    x1 = cooccurrence(tiny, names, radius=1)
    x2 = cooccurrence(tiny, names, radius=2)
    torch.testing.assert_close(x1, torch.tensor([[0., 2.], [2., 0.]], dtype=DTYPE))
    torch.testing.assert_close(x2, torch.tensor([[1., 2.], [2., 0.]], dtype=DTYPE))
    conditional = x2 / x2.sum(1, keepdim=True)
    assert not torch.equal(conditional, conditional.T)
    # One nonzero GloVe cell; paper weighting x_max100 / alpha.75, no 1/2.
    observed = float(x1[0, 1])
    score = torch.tensor(.5, dtype=DTYPE, requires_grad=True)
    weight = min((observed / 100) ** .75, 1.)
    glove_loss = weight * (score - math.log(observed)) ** 2
    glove_loss.backward()
    assert math.isclose(float(score.grad), 2 * weight * (.5 - math.log(2)))
    # Zero cells are omitted BEFORE log, not evaluated as 0 * log(0).
    nonzero_cells = int((x1 > 0).sum())
    assert nonzero_cells == 2

    # Self-chosen vectors and zero fallback; NOT the fastText hash-bucket API.
    table = {"<wh": [.1, 0.], "whe": [0., .2], "her": [.3, .1],
             "ere": [-.1, .2], "re>": [.2, -.1], "<where>": [1., 1.]}

    def compose(word, known):
        parts = character_trigrams(word)
        if known:
            parts.append("<" + word + ">")
        missing = [p for p in parts if p not in table]
        vectors = torch.tensor([table.get(p, [0., 0.]) for p in parts], dtype=DTYPE)
        return {"parts": parts, "missing_zero_fallback": missing,
                "sum": vectors.sum(0).tolist(), "mean_all_parts": vectors.mean(0).tolist()}

    known, oov = compose("where", True), compose("here", False)
    assert character_trigrams("where") == ["<wh", "whe", "her", "ere", "re>"]
    assert "<here>" not in oov["parts"] and oov["missing_zero_fallback"] == ["<he"]
    torch.testing.assert_close(torch.tensor(known["sum"]), torch.tensor([1.5, 1.4]))
    torch.testing.assert_close(torch.tensor(oov["sum"]), torch.tensor([.4, .2]))

    return {
        "environment": {"python": platform.python_version(), "torch": torch.__version__,
                        "device": "cpu", "float_dtype": str(DTYPE)},
        "fixed_radius2_position_pairs": len(pairs), "road_contexts": road_contexts,
        "zero_score_sgns_sum": float(independent_loss.detach()),
        "zero_score_sgns_gradients": zero_scores.grad.tolist(),
        "zero_score_candidate_ce": float(candidate_loss.detach()),
        "zero_score_candidate_ce_gradients": candidate_scores.grad.tolist(),
        "single_sgns_update": {"context_row_occurrences": rows.tolist(),
                               "scores_before": scores.detach().tolist(),
                               "loss_before": float(before.detach()), "loss_after": float(after),
                               "center_gradient": c_grad.tolist(),
                               "context_gradients": u_grad.tolist(),
                               "center_after": center.detach().tolist(),
                               "contexts_after": contexts.detach().tolist()},
        "two_word_noise_probabilities": noise,
        "distance_weighted_cooccurrence_radius1": x1.tolist(),
        "distance_weighted_cooccurrence_radius2": x2.tolist(),
        "conditional_context_given_center_radius2": conditional.tolist(),
        "glove_nonzero_cell": {"X": observed, "weight": weight,
                               "loss_without_half": float(glove_loss.detach()),
                               "score_gradient": float(score.grad),
                               "zero_cells_omitted_before_log": True},
        "hand_set_subword_known": known, "hand_set_subword_oov": oov,
        "scope": "One artificial SGD step, scalar GloVe cell and hand-set subword vectors; no learned semantic corpus model or benchmark.",
    }


if __name__ == "__main__":
    print(json.dumps(run(), ensure_ascii=False, indent=2, allow_nan=False))
成功時輸出 JSON,重要欄位應對上本文表格。single_sgns_update 的 loss 下降只屬於該手設 batch;glove_nonzero_cell 只算一格;hand_set_subword_oov 的 missing_zero_fallback 應是 ['<he'],不是工具替你學出新的詞義。
如果改了向量、窗口或負例,結果不再等於本文是正常的;先把改動記清楚再驗算。若改成真實語料訓練,還必須另外交代 tokenization、詞頻門檻、窗口/subsampling、noise 分布、負例規則、更新設定與評估方法。這支機制程式沒有代替那些工作。
Word2Vec、GloVe 和 FastText 的共同價值,是讓詞的表示可以從語料學習並供後續模型使用;差異則在學習訊號、目標與參數共享。能從來源句子追到配對、分數、損失和向量更新,才有基礎判斷一組向量能替你的應用提供什麼。
主要原始來源與版本:
- Mikolov 等,Efficient Estimation of Word Representations in Vector Space,2013,CBOW 與 Skip-gram 架構。
- Mikolov 等,Distributed Representations of Words and Phrases and their Compositionality,2013,尤其第 2.2–2.3 節的 NEG、noise 與頻詞 subsampling。
- Pennington、Socher、Manning,GloVe,2014,尤其第 3 節與第 4.2 節;原論文圖表只提供連結。
- Bojanowski、Grave、Joulin、Mikolov,Enriching Word Vectors with Subword Information,TACL 2017,第 3.2、4.3、5.1、6.3 節;2016 年預印本與 2017 年正式版應分開標示。
- D2L Word Embedding、D2L GloVe,本文教材圖/公式與原論文分開歸屬。
- TensorFlow Word2Vec tutorial,圖用於機制說明,來源明示其為簡化教學,不是原論文的精確實作。
留言0
登入後就能留言。
登入