
一份租車需求模型報告寫著:「溫度越高,預測租借數越高。」接著有人問:如果讓環境升溫,真實需求就會增加這麼多嗎?又有人想知道:為什麼今天這一筆預測特別高?
這三句話的主題相近,實際上問的是不同問題。第一句可能描述模型在一組參考資料上的平均反應;第二句涉及現實中的因果干預;第三句則聚焦某一筆輸入。即使三者都拿同一個模型產圖,答案也不能直接互換。
前面的系列談過模型如何從資料學出預測,並一路走到Diffusion 的加噪與反向生成。現在回到模型交付後經常遇到的問題:怎麼解釋它、解釋到什麼範圍,以及什麼時候還缺少支持決策的因果證據。
本文先讀五組 scikit-learn 原圖,再用一支完整 Python 程式核對三個獨立小例。原圖是來源教材保存的模型或模擬結果,沒有在本站重跑;本篇程式則是手設函數、固定排列與結構方程的算術,不把它們包裝成真實資料的因果估計。
全局、局部說的是範圍;因果說的是另一種問題
「這個特徵有影響」還不夠精確。要先補上:影響哪個模型輸出、針對哪些樣本、採用哪個比較方式?
全局與局部不是兩種固定模型類別:同一個已擬合模型可以做不同範圍的分析。因果也不是比全局、局部更進階的一張圖;它可以問整體平均效果,也可以問特定群體的效果,但需要額外的研究設計與假設。
因此,一張解釋圖至少要交代模型、資料範圍、輸出尺度與比較規則。分類模型的 probability、logit,以及迴歸模型的預測數值,都不是同一個量。解釋圖漂亮,也不能替代模型本身在相關評估資料上的表現檢查;不可靠的模型仍可用解釋工具排錯,但它的行為不宜直接升格成業務規律。
PDP 怎麼算:替換一欄,再對參考資料平均
Partial Dependence Plot(PDP)不是先把資料按溫度分組,計算每組的實際租借平均。它做的是另一個操作:把參考資料裡每一列的某個特徵都替換成指定值,保留該列其他欄位,重新預測,再平均。
把關注的特徵記成 x,其餘欄位記成 z,模型為 f。用 n 筆參考資料近似 PDP:
PDP(a) = (1/n) × sum_i f(a, z_i)

對每個想畫在橫軸的 a:
  複製參考資料 → 全部列的 x 改為 a → 模型預測 → 平均
換一組參考群體,z 的分布可能不同,PDP 也會不同;這不一定表示模型參數改了。它描述的是「這個模型,加上這個平均方式與參考群體」的結果。
讀這張圖時,可以先看溫度面板的平均預測如何改變,再看其他面板是否提供相同或不同的模型反應。不應把 y 軸當成真實資料在該溫度下的平均租借量;圖中的每個點都經過替換其他列的特徵,再交給模型計算。
來源使用 OpenML Bike_Sharing_Demand version 2,並每五列取一列來縮小示範資料。原圖類別字串沿用該版本;season 標籤對應存在版本疑點,不能把另一版的修正默默套回這張圖,更不能由柱序推導真實季節的因果效果。這裡要學的是 PDP 的建構與讀法,不是從這一張圖建立氣候或需求政策結論。
PDP 最需要檢查的前提,是替換後的組合是否合理。例如溫度、體感溫度、濕度可能有關聯;只改其中一欄,就可能製造資料中罕見或根本沒出現的組合。模型仍會給數字,但那是對合成輸入的評估,不能因為曲線平滑,就認為它有同樣強的資料支持。
ICE 把平均拆開:不同資料列可以有不同反應
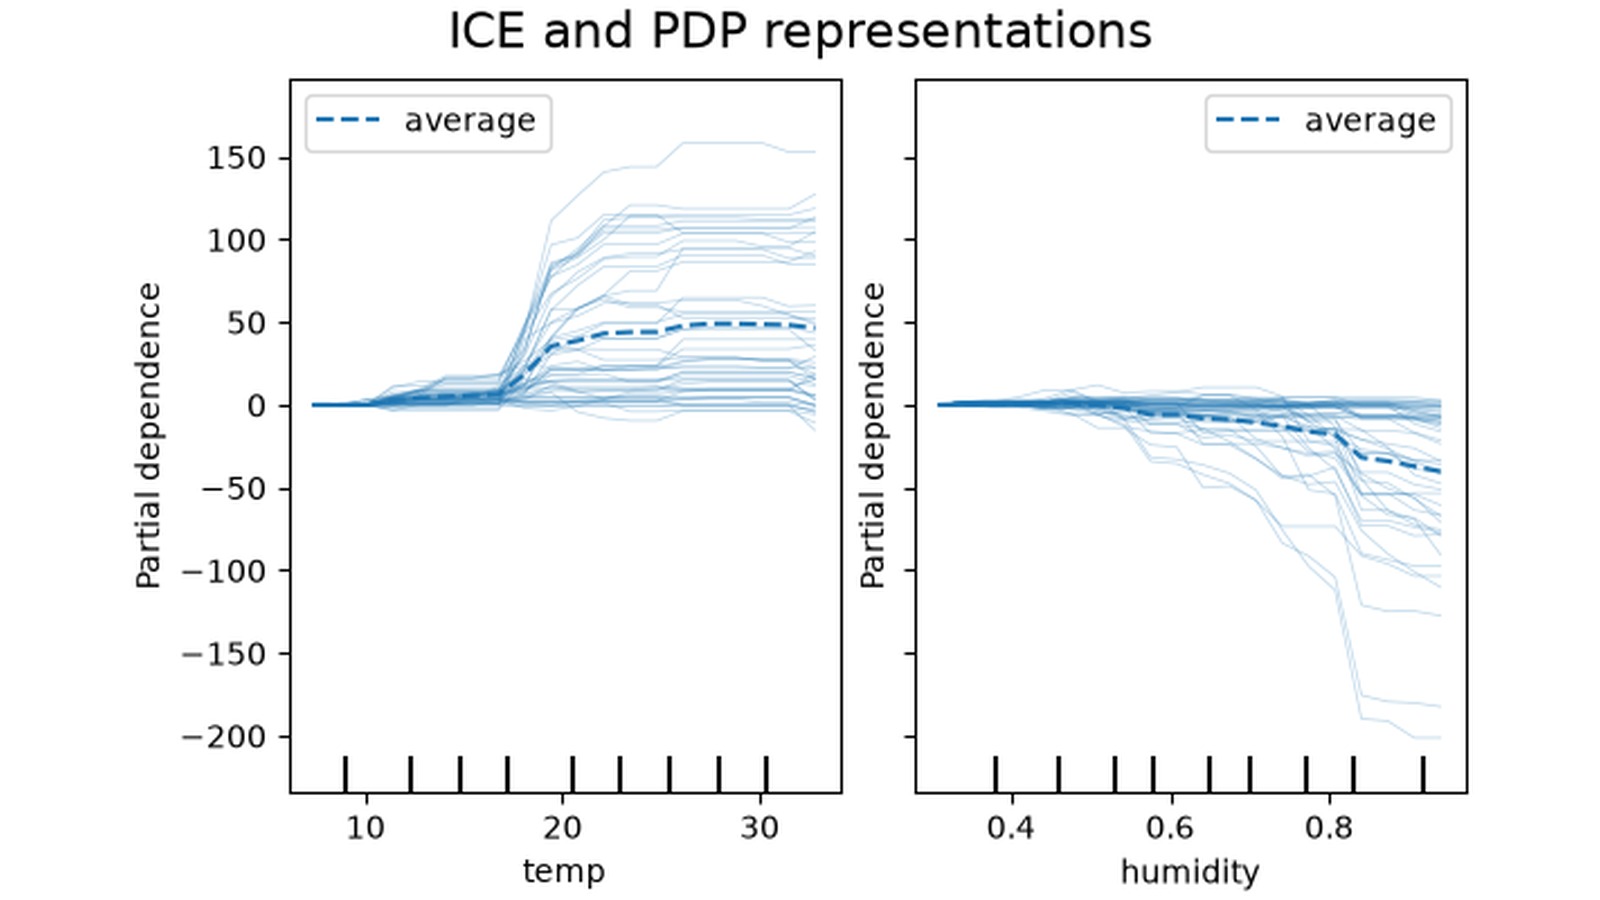
Individual Conditional Expectation(ICE)把其他欄位固定在某一列的值,再改動關注的 x,得到該列的一條模型反應曲線:
第 i 列的 ICE_i(a) = f(a, z_i)
PDP 把很多條反應平均成一條線;ICE 讓我們看見被平均掩蓋的差異。若不同列的曲線形狀不平行,表示這個模型中,x 的反應會隨其他特徵而變。這是模型的交互作用線索,不是某個人的真實因果效果。
置中是為了比較「從共同起點開始,預測改變了多少」。它不是把每個人的實際觀測點設成零,也不表示圖上的負值就是預測出負的租借數量。當前顯示的是相對起始值的變化。
左邊溫度圖,有些細線增加很多,有些較平;右邊濕度圖,有些列的下降幅度明顯較大。平均線把這些差異壓成一條,因此「平均趨勢是上升」不代表每筆都會上升相同幅度。
這裡的 50 是顯示 ICE 的抽樣數,作用是減少圖面擁擠;來源 API 明確保留整個參考資料集來計算平均 PDP。看圖時,不能把虛線當成畫面上這 50 條細線的精確算術平均。PartialDependenceDisplay 文件 說明了 subsample 與 centered 的作用。ICE 和 PDP 也共享替換特徵時的資料支持問題,拆成細線並不會讓不合理的組合自動變合理。
一個能手算的模型:平均斜率 2.5,不代表每筆都變 2.5
先把所有真實資料與訓練問題拿開,手設一個固定函數:
f(x,z) = x + 2z + 3xz
參考資料有四列,兩列 (0,0)、兩列 (1,1),所以 z=0、z=1 各占一半。針對 x 做 PDP 時,我們會各自評估 z=0 與 z=1,再平均:
固定 z=0:ICE_0(x) = x
固定 z=1:ICE_1(x) = 2 + 4x

PDP(x) = 0.5 × x + 0.5 × (2+4x)
       = 1 + 2.5x
| 曲線 | x=0/x=1 的值 | 從 0 到 1 的變化 |
|---|---|---|
| z=0 的 ICE | 0/1 | 1 |
| z=1 的 ICE | 2/6 | 4 |
| 平均 PDP | 1/3.5 | 2.5 |
這說明平均不是假的,但它回答的範圍有限。若有人問這一列 z=1 的輸入,將 x 從 0 改到 1 時模型多預測多少,答案是 4,不是全局平均的 2.5。
還有另一個更重要的差別:觀察資料只有 x=z 的兩種組合。PDP 在 x=0 時仍會用到 (0,1),在 x=1 時會用到 (1,0);這兩種組合都不在觀察支持範圍內。它算的是手設模型在這些位置的輸出,不能把它改名成資料的觀察條件平均,更不能直接叫做干預效果。
單筆預測的解釋,還必須指定對照
在 (x,z)=(1,1),預測是 6。若固定 z=1,只把 x 改成 0,預測變成 2,差 4;若固定 x=1,只把 z 改成 0,預測變成 1,差 5。
這兩個差都算得對,卻不能直接相加,宣稱從 (0,0) 的 0 到 (1,1) 的 6,已被唯一拆成「4+5」。兩個比較使用不同對照,交互作用 3xz 也會被重複計入。
所以「這筆預測為什麼是 6」還要說明基準點、比較範圍與分配規則。局部解釋方法會針對這些選擇給出不同形式的答案;本篇先建立問題,不在這裡推導後續的局部近似或歸因算法。只改模型輸入算出的差,也仍然是模型反應,不是同一個人在現實中採取行動後的結果。
Permutation importance:測的是指定模型依賴什麼
另一種常見圖不畫預測曲線,而是打亂某個特徵,觀察指定評分變差多少。Permutation importance 的核心流程是:固定已擬合的模型,在選定資料集算基準分數;只打亂某一欄的列對應,重新評分;再比較前後差異。
若 score 是越大越好:
importance_j = baseline_score − permuted_score_j
結果同時依賴模型、資料範圍、score 與排列方式。它不是這個特徵在所有模型中的價值,也不是現實世界的因果重要性。
原圖有些排列的 score drop 是負的,表示那次打亂後 accuracy 反而比 baseline 高;這可以來自有限資料與排列的變動,不能直接解讀成特徵有「負的因果作用」。箱型圖描述這幾次排列的變化,也不是由此自動得到母體效果的顯著性檢定。
當特徵相關,某個模型可能已透過其他欄位使用相近資訊,單欄打亂的下降就可能很小。但這不是模型被打亂後重新訓練、臨時學會改用替代欄位;評估時模型固定,其他路徑原本就存在。不同模型對相關欄位的用法不同,不能推成「只要相關,重要性必定是零」。
可以再看一個與前節函數無關的固定小例:x₁、x₂ 都是 [0,0,1,1],目標也相同,但模型規則明確只讀 x₁。
[1,1,0,0]x₂ 含有與 x₁ 相同的資訊,這個固定模型卻沒有讀它。因此要分清「欄位是否有資訊」與「這個模型是否使用它」。此例沒有實作模型切換到 x₂,也沒有為每欄抽很多次排列估計不確定性,只比較一個已指定的排列。
附件的 score_drop 命名指這裡的 MSE 增加量;若把 score 定成負 MSE,才等價於分數下降。不要把輸出的 1 說成 MSE 降低了 1。採用 loss 或 score 時,先確認數值方向,比直接看長條誰比較高更重要。
相關性熱圖提供資料背景,不是另一張因果圖
Permutation 圖上很多欄位接近零時,下一個合理問題是:資料裡是不是有很多重複或相關資訊?這時可以看相關性與分群,但它們描述的是資料關係,不是模型某一筆預測的完整解釋。
讀這張密集圖,先看成塊的相關結構與聚在一起的名稱,不必先逐字背下全部特徵。右圖是相關係數的排列,左樹則整理相近特徵;兩者沒有指出現實中的作用方向。某個特徵與另一個高度相關,可能是量到相近現象、共享原因,或其他資料機制,不能只靠格子亮暗決定誰造成誰。
原示例接著從 cluster 選代表特徵再訓練。本文借圖說明相關背景,不將它包裝成 test 完全隔離的正式選模流程。若你要利用分群結果選欄位並估計泛化表現,應在訓練資料或各個 CV training fold 內學這些選擇,再用未參與選擇的評估資料檢查。不能用 test 的分布協助決策後,仍籠統稱它完全沒參與流程。
PDP、ICE 的替換與 permutation 也都可能打破特徵間原有關係。相關性一方面可能使資訊互相替代,另一方面也可能讓替換後的輸入離開資料支持區域;影響方向與大小要看模型與操作,沒有一張熱圖能替所有解釋工具解除這些限制。
為什麼預測得好,也可能把原因說錯?
考慮學歷與薪資。如果一個未完整觀察的因素,同時影響取得學位的機會與薪資,模型可能把部分關聯歸到學歷。這時,較高學歷對應較高預測,不等於改變學歷這個機制就一定產生同樣幅度的薪資變化。
圖左側 degree 只有兩種值,ability 在這兩組中的分布不同。來源程式刻意如此產生資料:ability 與父母薪資參與 degree 的生成,再讓它們與 degree、experience 一起參與 wage 的生成。最後還把負的 wage 截為 0。
因此,這裡可以學到的是共同原因與遺漏變數的問題。來源另外比較有沒有把 ability 納入迴歸,示範遺漏它可能扭曲 degree 係數,即使預測表現仍相近。本文不把原碼中的線性係數,說成所有樣本截零後的精確平均因果效果,也不把來源較強的「回收真係數」文字當成對任意資料的保證。
更複雜的模型不會僅靠更高預測分數,自動把這個問題解開。機器學習可以成為因果估計流程的一部分,例如輔助擬合某些條件關係;但干預效果能否識別,仍來自研究設計、可辯護的因果假設與資料,而不是解釋圖自己賦予的資格。
兩個世界,一樣的觀察分布,卻有不同干預效果
再用第三個、獨立於前兩個模型小例的手設系統,把差別列到可以全部檢查。設 U 只取 0 或 1,各占一半:
系統 A:X = U,Y = U
系統 B:X = U,Y = X
在 A,U 同時決定 X 與 Y,Y 的結構式沒有 X;在 B,Y 直接由 X 決定。沒有干預時,兩個系統都只觀察到 (X,Y)=(0,0)、(1,1),機率各為 1/2。只看這個聯合分布,無法判斷是哪個系統。
現在定義 do(X=a):把 X 的生成方程換成常數 a,U 的分布與其他結構方程維持原設定。這不是只挑出資料裡原本 X=a 的列,也不是替換模型輸入後,機械地把所有其他結果都固定。
| 明確指定的系統 | do(X=0) 的 E[Y]/do(X=1) 的 E[Y] | 後者減前者 |
|---|---|---|
| A:Y 仍由 U 決定 | 0.5/0.5 | 0 |
| B:Y 由改後的 X 決定 | 0/1 | 1 |
兩個系統的觀察條件平均,從 X=0 到 X=1 都差 1;干預效果卻不同。這不是算式矛盾,而是「觀察到 X=a」與「替換 X 的產生機制」回答不同問題。
此例證明的是,在這兩個明確假設都尚未排除時,僅憑這個觀察分布不足以選出唯一的干預答案。它沒有從真實資料學出 A 或 B,沒有估計教育、薪資或業務行動的效果。若要回答現實中的干預問題,還需要額外能區分這些結構的假設或證據。
完整可重跑程式:三種問題,三組分開的算術
把下面程式存成 explanation_scope_toy.py,使用 Python 3 執行。它只用標準庫,不需 pip、scikit-learn、資料下載或模型權重。保存環境為 Python 3.10.12,原型已有實際執行與獨立數值核對;沒有重跑上面來源的租車、診斷資料或模擬迴歸模型。
python3 explanation_scope_toy.py
"""Small deterministic examples for global, local, and causal questions.

This script does not fit a model or estimate an effect from real data.
"""

import json


def f(x, z):
    return x + 2 * z + 3 * x * z


def mse(actual, predicted):
    return sum((a - p) ** 2 for a, p in zip(actual, predicted)) / len(actual)


def main():
    # Observed support contains only (x, z) = (0, 0) and (1, 1), equally often.
    observed = [(0, 0), (0, 0), (1, 1), (1, 1)]
    pdp = {}
    ice = {}
    for x in (0, 1):
        by_z = {z: f(x, z) for z in (0, 1)}
        pdp[str(x)] = sum(by_z.values()) / 2
    for z in (0, 1):
        ice[str(z)] = {str(x): f(x, z) for x in (0, 1)}

    # Exact duplicate predictors: the fitted toy rule relies on x1 only.
    x1 = [0, 0, 1, 1]
    x2 = [0, 0, 1, 1]
    y = [0, 0, 1, 1]
    baseline_pred = list(x1)
    x1_shuffled = [1, 1, 0, 0]
    x2_shuffled = [1, 0, 0, 1]
    perm_x1_pred = list(x1_shuffled)
    perm_x2_pred = list(x1)  # The fixed model ignores x2.

    # Paired deterministic SCMs. Both have observational U -> X and X == Y.
    # The intervention replaces X's structural equation and holds U fixed.
    u_values = (0, 1)
    observational = [(u, u) for u in u_values]
    scm_a_do = {str(x): sum(u for u in u_values) / 2 for x in (0, 1)}
    scm_b_do = {str(x): float(x) for x in (0, 1)}

    result = {
        "scope": "hand-specified deterministic arithmetic; no fitting, real data, or effect estimation",
        "global_vs_individual": {
            "model": "f(x,z)=x+2z+3xz",
            "observed_support_rows": [
                {"x": x, "z": z, "weight": 0.25, "f": f(x, z)}
                for x, z in observed
            ],
            "support_note": "Observed support has x=z only. PDP values at x!=z require model evaluation off observed support.",
            "pdp_equal_weight_z": pdp,
            "pdp_slope_from_x0_to_x1": pdp["1"] - pdp["0"],
            "ice_by_fixed_z": ice,
            "ice_slopes_from_x0_to_x1": {
                z: curve["1"] - curve["0"] for z, curve in ice.items()
            },
        },
        "single_fixed_permutation_example": {
            "rows": [
                {"x1": x1[i], "x2": x2[i], "y": y[i]}
                for i in range(len(y))
            ],
            "fixed_model": "prediction=x1",
            "metric": "mean squared error on these four rows",
            "baseline_mse": mse(y, baseline_pred),
            "one_fixed_x1_permutation": x1_shuffled,
            "x1_permuted_mse": mse(y, perm_x1_pred),
            "x1_permutation_score_drop": mse(y, perm_x1_pred) - mse(y, baseline_pred),
            "one_fixed_x2_permutation": x2_shuffled,
            "x2_permuted_mse": mse(y, perm_x2_pred),
            "x2_permutation_score_drop": mse(y, perm_x2_pred) - mse(y, baseline_pred),
            "scope_note": "One fixed shuffle for one fixed model and metric; not an uncertainty estimate, a universal feature value, or a causal effect. x2 duplicates x1 in these rows, but this fitted rule reads x1 only.",
        },
        "observationally_indistinguishable_scms": {
            "exogenous_support": [{"u": u, "probability": 0.5} for u in u_values],
            "scm_a": "X=U; Y=U (no structural dependence of Y on X)",
            "scm_b": "X=U; Y=X",
            "shared_observational_joint_xy": [
                {"x": x, "y": y_value, "probability": 0.5}
                for x, y_value in observational
            ],
            "mean_y_under_do_x": {
                "scm_a": scm_a_do,
                "scm_b": scm_b_do,
            },
            "do_effect_mean_y_x1_minus_x0": {
                "scm_a": scm_a_do["1"] - scm_a_do["0"],
                "scm_b": scm_b_do["1"] - scm_b_do["0"],
            },
            "scope_note": "These are two explicitly assumed structures with the same observational distribution and different intervention effects; they show non-identification from that distribution alone, not an effect learned from data.",
        },
    }
    assert result["global_vs_individual"]["pdp_slope_from_x0_to_x1"] == 2.5
    assert result["global_vs_individual"]["ice_slopes_from_x0_to_x1"] == {"0": 1, "1": 4}
    assert result["single_fixed_permutation_example"]["baseline_mse"] == 0
    assert result["single_fixed_permutation_example"]["x1_permuted_mse"] == 1
    assert result["single_fixed_permutation_example"]["x2_permuted_mse"] == 0
    assert result["observationally_indistinguishable_scms"]["do_effect_mean_y_x1_minus_x0"] == {
        "scm_a": 0.0,
        "scm_b": 1.0,
    }
    print(json.dumps(result, ensure_ascii=False, indent=2))


if __name__ == "__main__":
    main()
保存輸出的重點是:PDP 在 x=0/1 為 1/3.5,兩條 ICE 的變化量為 1/4;固定排列的基準 MSE 為 0,打亂 x₁ 後為 1,打亂模型沒讀的 x₂ 後仍為 0;兩個手設 SCM 的 do 差則為 0/1。每一組都有自己的前提,不能把同一份 JSON 中的不同區塊當成同一個真實資料實驗。
下次看到解釋圖,可以先將問題寫成一句完整的話:「我正在用哪個模型、哪些資料、哪個對照,解釋什麼輸出?」如果接著要問「採取某個行動後,現實結果會多多少」,就應另外交代干預與識別假設。PDP、ICE 與重要性圖可以幫你檢查模型;它們不會自動替這一步補齊答案。
圖片、資料來源與授權副本
本文的教學順序、固定模型算術與兩個 SCM 是重新組織的說明;五張原圖保持來源輸出,不把它們改名成本站實測。圖片的 BSD 授權與底層資料來源的署名/授權分開保留。
- scikit-learn PDP/ICE 完整示例:圖 1/2、手機版與完整 ICE 封面。已讀原頁正文及完整 source Python,圖 1 實際模型為 HistGradientBoostingRegressor pipeline。沒有執行來源模型,也未將 source 中季節版本與日曆年標題的疑點照搬成本文結論。
- PartialDependenceDisplay API:centered 與 subsample 的讀法;後者僅影響顯示的 ICE,平均 PDP 仍使用完整指定參考集。
- scikit-learn permutation/相關特徵完整示例:圖 3/4,是同一次示例的不同圖;完整 source Python 的分群使用全 X,包括 test 特徵,本文不宣稱 test 完全隔離。
- scikit-learn 1.8 因果解讀示例:圖 5,原頁正文與完整生成/迴歸 code 已讀,資料有 wage 截零步驟。此處只借模擬資料與共同原因說明,不推真世界的精確因果效果。
- scikit-learn 圖像重用 FAQ:文件生成圖片適用 BSD 3-Clause;不把這個說明擴張為任意第三方圖片或 logo 的授權。
- UCI Bike Sharing Dataset:資料 Creator 為 Hadi Fanaee-T,DOI 10.24432/C5W894,CC BY 4.0。來源實例用的是 OpenML version 2/id42712,其 metadata 欄位是 Public,不是 CC BY 標籤;UCI 的 CC grant 另行存在,兩個 release 的逐列/逐 byte 同一性未核實。version 3 的類別標籤說明不回填 version 2。
- OpenML 資料說明另要求引用 Hadi Fanaee-T 與 João Gama 的 Event labeling combining ensemble detectors and background knowledge。這是資料引用,不聲稱本文已讀或重現該介紹論文的全部結果;Gama 是該文共同作者,不改寫成 UCI 欄位所列的資料 Creator。
- UCI Breast Cancer Wisconsin(Diagnostic):UCI 頁列 William Wolberg、Olvi Mangasarian、Nick Street、W. Street,DOI 10.24432/C5DW2B,CC BY 4.0。本文用它說明指定模型對相關特徵的依賴,不由此推導資料的因果機制。
BSD 3-Clause:圖 1–4 與 ICE 封面來源副本
保留 1.9.1 COPYING 的完整原文與年份,不將不同版本的 copyright notice 合併改寫。
BSD 3-Clause License

Copyright (c) 2007-2026 The scikit-learn developers.
All rights reserved.

Redistribution and use in source and binary forms, with or without
modification, are permitted provided that the following conditions are met:

* Redistributions of source code must retain the above copyright notice, this
  list of conditions and the following disclaimer.

* Redistributions in binary form must reproduce the above copyright notice,
  this list of conditions and the following disclaimer in the documentation
  and/or other materials provided with the distribution.

* Neither the name of the copyright holder nor the names of its
  contributors may be used to endorse or promote products derived from
  this software without specific prior written permission.

THIS SOFTWARE IS PROVIDED BY THE COPYRIGHT HOLDERS AND CONTRIBUTORS "AS IS"
AND ANY EXPRESS OR IMPLIED WARRANTIES, INCLUDING, BUT NOT LIMITED TO, THE
IMPLIED WARRANTIES OF MERCHANTABILITY AND FITNESS FOR A PARTICULAR PURPOSE ARE
DISCLAIMED. IN NO EVENT SHALL THE COPYRIGHT HOLDER OR CONTRIBUTORS BE LIABLE
FOR ANY DIRECT, INDIRECT, INCIDENTAL, SPECIAL, EXEMPLARY, OR CONSEQUENTIAL
DAMAGES (INCLUDING, BUT NOT LIMITED TO, PROCUREMENT OF SUBSTITUTE GOODS OR
SERVICES; LOSS OF USE, DATA, OR PROFITS; OR BUSINESS INTERRUPTION) HOWEVER
CAUSED AND ON ANY THEORY OF LIABILITY, WHETHER IN CONTRACT, STRICT LIABILITY,
OR TORT (INCLUDING NEGLIGENCE OR OTHERWISE) ARISING IN ANY WAY OUT OF THE USE
OF THIS SOFTWARE, EVEN IF ADVISED OF THE POSSIBILITY OF SUCH DAMAGE.
BSD 3-Clause:圖 5 的 1.8.0 來源副本
以下保留 1.8.0 COPYING 的原始年份;不是將當前版年份回填到舊圖來源。
BSD 3-Clause License

Copyright (c) 2007-2024 The scikit-learn developers.
All rights reserved.

Redistribution and use in source and binary forms, with or without
modification, are permitted provided that the following conditions are met:

* Redistributions of source code must retain the above copyright notice, this
  list of conditions and the following disclaimer.

* Redistributions in binary form must reproduce the above copyright notice,
  this list of conditions and the following disclaimer in the documentation
  and/or other materials provided with the distribution.

* Neither the name of the copyright holder nor the names of its
  contributors may be used to endorse or promote products derived from
  this software without specific prior written permission.

THIS SOFTWARE IS PROVIDED BY THE COPYRIGHT HOLDERS AND CONTRIBUTORS "AS IS"
AND ANY EXPRESS OR IMPLIED WARRANTIES, INCLUDING, BUT NOT LIMITED TO, THE
IMPLIED WARRANTIES OF MERCHANTABILITY AND FITNESS FOR A PARTICULAR PURPOSE ARE
DISCLAIMED. IN NO EVENT SHALL THE COPYRIGHT HOLDER OR CONTRIBUTORS BE LIABLE
FOR ANY DIRECT, INDIRECT, INCIDENTAL, SPECIAL, EXEMPLARY, OR CONSEQUENTIAL
DAMAGES (INCLUDING, BUT NOT LIMITED TO, PROCUREMENT OF SUBSTITUTE GOODS OR
SERVICES; LOSS OF USE, DATA, OR PROFITS; OR BUSINESS INTERRUPTION) HOWEVER
CAUSED AND ON ANY THEORY OF LIABILITY, WHETHER IN CONTRACT, STRICT LIABILITY,
OR TORT (INCLUDING NEGLIGENCE OR OTHERWISE) ARISING IN ANY WAY OUT OF THE USE
OF THIS SOFTWARE, EVEN IF ADVISED OF THE POSSIBILITY OF SUCH DAMAGE.
圖源署名與變更紀錄
Source attribution for the model-explanation illustrations

The selected plots were generated in scikit-learn documentation. The scikit-learn FAQ permits repository images and images generated within the documentation under the BSD 3-Clause License, excluding the logo and separately credited third-party content.
FAQ: https://scikit-learn.org/stable/faq.html#how-can-i-obtain-permission-to-use-the-images-in-scikit-learn-for-my-work

Figures 01-04 and the centered-ICE cover use the captured 1.9.1 documentation/source records:
Copyright (c) 2007-2026 The scikit-learn developers.
License: https://github.com/scikit-learn/scikit-learn/blob/1.9.1/COPYING

Figure 05 uses the 1.8.0 documentation/source record:
Copyright (c) 2007-2024 The scikit-learn developers.
License: https://github.com/scikit-learn/scikit-learn/blob/1.8.0/COPYING

Both complete, version-specific BSD license copies accompany this notice. Source copyright years are preserved, not rewritten.

Figure sources:
https://scikit-learn.org/stable/auto_examples/inspection/plot_partial_dependence.html
https://scikit-learn.org/stable/auto_examples/inspection/plot_permutation_importance_multicollinear.html
https://scikit-learn.org/1.8/auto_examples/inspection/plot_causal_interpretation.html

Changes: Five main images are byte-identical copies of the selected original PNGs. Mobile Figure 01 shows the whole figure, then the original temperature and season panels enlarged. Mobile Figure 02 shows the whole figure, then the original temperature and humidity panels enlarged; the humidity panel retains its original shared-y-axis convention, without newly drawn numeric ticks. Mobile Figure 05 shows the whole synthetic-association pairplot first, followed by its complete first column enlarged, containing the degree KDE and four scatter rows with all original left y labels/ticks and bottom degree x labels/ticks; it repeats source pixels and is not a new causal graph. The cover proportionally fits the complete centered-ICE figure on a white 1600x900 canvas. No labels, curves, data or annotations were redrawn. These original documentation examples were not rerun for this article.

Separate dataset attribution:
- Bike Sharing: Hadi Fanaee-T (2013), UCI Machine Learning Repository, DOI 10.24432/C5W894, CC BY 4.0. https://archive.ics.uci.edu/dataset/275/bike+sharing+dataset
- The source example loads OpenML Bike_Sharing_Demand version 2, dataset 42712. Its metadata license field says Public; that field is not a CC BY statement. The upstream UCI page separately grants CC BY 4.0. Row-level/byte-level identity of the two releases was not verified. Season-label ordering has a version caveat; version 3 metadata must not be silently substituted for version 2.
- The OpenML description requests citation of Hadi Fanaee-T and Joao Gama, Event labeling combining ensemble detectors and background knowledge, DOI 10.1007/s13748-013-0040-3. Gama is co-author of this introductory paper, not listed as creator in the cited UCI dataset Creator field. This is dataset citation, not a claim to have reproduced that paper.
- Breast Cancer Wisconsin (Diagnostic): William Wolberg, Olvi Mangasarian, Nick Street, and W. Street (1993), UCI Machine Learning Repository, DOI 10.24432/C5DW2B, CC BY 4.0. https://archive.ics.uci.edu/dataset/17/breast-cancer-wisconsin-data-set
- Figure 05 uses synthetic variables generated by the documentation example, not either of the above datasets or real education/wage observations.

These attributions do not imply endorsement by the source authors or dataset creators. Plot licensing and dataset provenance remain separate.
留言0
登入後就能留言。
登入