
假設你手上有三種需求:指定類別生成圖片、把某張線稿轉成照片,以及讓生成影像的粗略結構和細部外觀能分開調整。它們都可能用 GAN,但你提供的資料、模型能看到的條件,以及「生成正確」的意思並不相同。
一張圖片看起來像照片,只能回答一部分問題。線稿裡的窗戶有沒有被保留?沒有逐張配對的冬景與夏景,如何限制翻譯不要任意改變內容?改變某一層的 latent style,是否真的只會改變你想要的屬性?這些問題,無法只靠真假判別分數作答。
本篇接續 DCGAN、WGAN 與 Mode Collapse,沿著四條方法線索閱讀原圖。最後有一支完整、只用 Python 標準庫的程式:不訓練 GAN,而是用兩個點證明「生成分布相同、往返完全正確」仍可能配錯答案。影像架構與論文結果屬於來源研究;本站實作只支持這個有限反例。
先分清:你要提供什麼條件,資料又告訴了模型什麼?
Conditional GAN 是把額外條件交給 G 與 D 的框架;Pix2Pix 是其中一種影像到影像的配對學習方法。CycleGAN 處理沒有逐張對應的兩個影像域;StyleGAN 則重新設計生成器內部接收 latent 的方式。它們不是四個可以不看資料條件、直接互換的產品版本。
表中的年份是方法首次提出與會議年份。本文查核的固定版本分別為 cGAN v1、Pix2Pix v3(2018 更新)、CycleGAN v7(2020 更新)、原 StyleGAN v3(2019 更新);修訂版日期不表示方法到那一年才出現。後面另用一張 StyleGAN2 單一 block 圖說明後繼改動,會與原 StyleGAN 分開。
先用一個實務問題判斷資料:如果你的資料夾只是有一批線稿、一批照片,卻不知道哪張線稿對應哪張照片,它就不具備 Pix2Pix 的逐張配對監督。檔名排在同一個位置,不會自動建立正確的配對。
Conditional GAN:條件也要交給判別器
原始 GAN 的生成器接收 noise z,再產生樣本。Conditional GAN 多提供條件 c;這裡用 c 避免與下一節 Pix2Pix 的目標影像 y 混淆,原 cGAN 論文則把條件記為 y。
生成:fake = G(z, c)
判別真實配對:D(real, c)
判別生成配對:D(G(z, c), c)

min_G max_D V = E_(real,c)[log D(real,c)]
             + E_(z,c)[log(1 − D(G(z,c),c))]
條件可以是類別標籤,也可以是另一種資料。以類別為例,若 c 指定「鞋」,G 的任務不只是產生一般看起來合理的物體,而是產生這個條件下合理的樣本。D 也必須看到 c;若 D 只看圖片,它能比較的是整體影像分布,無法直接檢查圖片與指定條件是否相符。
圖中的 real、fake 是兩種送進同一個 D 的資料情況,不是兩個不同的判別器。C 指向真實樣本的支線可理解為使用符合該類別的真實資料;不是把類別數字透過某個已畫出的生成器製成真實照片。
條件的監督來源也要說清楚。「鞋」是訓練資料已有的類別標註;某張線稿則可能是另一張照片的對應輸入。即使形式上都叫 conditioning,它們提供的約束並不一樣。原 cGAN 的 MNIST 實驗以 one-hot 類別與 100 維 uniform noise 示範,但這些是當時實驗設定,不是 cGAN 的定義要求。方法依據是 Mirza 與 Osindero,2014,§3.2。
條件輸入也不保證模型一定服從條件、充分使用 noise,或涵蓋所有合理輸出。仍須分別檢查條件符合度、多樣性,以及在未見過資料上的行為。
Pix2Pix:既要像目標域,也要對得上這張輸入
在 Pix2Pix,條件不再只是類別,而是一張輸入影像 x。訓練時另有對應的目標影像 y,例如同一場景的結構標籤圖與照片。D 比較的是真實配對 (x,y) 與生成配對 (x,G(x)),而不是單獨比較兩張輸出照片。
只有對抗學習,還不足以明確要求生成影像逐位置接近這一張 y。因此原方法加入 L1 項:
L_cGAN = E_(x,y)[log D(x,y)]
       + E_(x,z)[log(1 − D(x,G(x,z)))]

L_L1 = E_(x,y,z)[||y − G(x,z)||_1]

min_G max_D [L_cGAN + λ L_L1]
L1 提供可對照目標的訊號,對抗項則由資料學習哪些影像局部結構看起來合理。不能將它簡化成「L1 處理所有正確性,GAN 負責所有細節」的保證;兩項都受資料、架構與訓練影響,權重也會改變取捨。Pix2Pix 原論文 §3.1 定義了這個組合。
L1 與 L2 也有不同的折衷。若只對某一個標量輸出做純誤差最小化,平方誤差的最佳常數是條件平均數,絕對誤差的最佳常數是條件中位數。手算三個可能目標 [0,0,9]:預測 0 的 MAE 是 3,預測 3 的 MAE 是 4;相反地,兩者 MSE 分別為 27 與 18。這是損失偏好的算術說明,並非訓練 Pix2Pix 的結果。加入對抗項、神經網路與多維影像之後,更不能僅由「使用 L1」就保證輸出銳利或語意正確。
逐像素誤差還依賴配準。假如正確照片中的窗戶比輸入標籤平移了幾個像素,L1 仍會懲罰這個差異。遇到配對品質差的資料,先確認兩張圖是否真的應在同位置對應,比直接增加 λ 更能釐清問題。
U-Net 的 skip 保留空間資訊,PatchGAN 的格子不是分割標籤
Pix2Pix 原論文用 U-Net 型生成器,將 encoder 與對應 decoder 層的 feature maps 沿 channel 軸 concatenate。這讓低階邊界與位置資訊能跨過 bottleneck;它不表示網路只能做語意分割。任務由輸出、監督與損失決定,相同的 U 型骨架可用來預測影像。
這張長圖可用三個位置讀懂,不必先背完每一層:
拼接保留兩路 feature channels,不等於逐元素相加。原圖中通道加倍的 Concatenate,是辨認這件事的直接線索。生成器可利用輸入的空間結構,但 skip 本身仍不保證所有物體形狀或數量都維持正確。
判別器的作用不同:它把輸入 x 與候選輸出 y 在 channel 軸拼接,再對局部區域判別真假。
為什麼叫 70×70 PatchGAN,圖上卻是 30×30?因為一個數字描述輸入範圍,另一個描述輸出網格。這個 D 使用 kernel size 4 的五層卷積,stride 為 2,2,2,1,1;依感受野遞推,每層理論範圍為 4,10,22,46,70。最後每個輸出位置參考輸入的一個局部範圍,鄰近位置的範圍會重疊;影像邊界則涉及 padding,不是每個位置都看到 70×70 個不同的真實影像像素。
教材用 BinaryCrossentropy(from_logits=True) 直接接這張 logits map,再做損失聚合。它沒有把 30×30 格當成 900 個語意分割類別,也不是把影像先切成 900 張互不重疊的小圖獨立訓練。這種局部判別有其偏好;僅靠局部看起來合理,仍不能確保整張圖的全域關係正確。
從兩條 loss 路徑讀懂 Pix2Pix 的生成器更新
架構圖告訴我們資料怎麼流,更新圖則說明哪個誤差會推動 G 改參數。
右路的 All 1's 表示:在這一次 G 更新中,希望 D 把生成配對判為真。它不是把訓練 D 時的 fake label 改為真。D 自己仍用 real pairs 的真標籤、fake pairs 的假標籤計算另一個損失。
TensorFlow 教材的生成器損失是 non-saturating 對抗 BCE 加上 100 × mean(abs(target−generated))。這裡的 100 是該設定的 λ,MAE 的 reduction 也已固定。原論文寫的是期望 L1 norm;若改影像尺寸、由 sum 換 mean,或改其他損失的平均方式,兩項相對尺度就會改變,不能把 λ=100 當成所有程式都通用的常數。
更新 G 時,仍需要 D 對生成影像的輸入梯度,再沿生成路徑回到 G;將整個 D forward 包進 no_grad 的想法會切斷這條訊號。這個梯度邏輯與前篇 GAN 的兩階段更新相同;本篇沒有額外實跑 TensorFlow 的訓練。
另一個常被省略的歷史細節是 noise。Pix2Pix 原論文發現 G 容易忽略直接輸入的 z,最後改以部分層的 dropout 提供隨機性,而且原實作在 training、test 都使用 dropout,仍只觀察到有限的隨機變化。不能據此保證同一條件能產生充分多樣的答案,也不能把這個原實作的推論模式,無條件套給每一個後來的 Pix2Pix API 或部署設定。使用教材時,應查其實際 training 旗標與正規化行為。
CycleGAN:沒有逐張答案,改用兩個方向限制映射
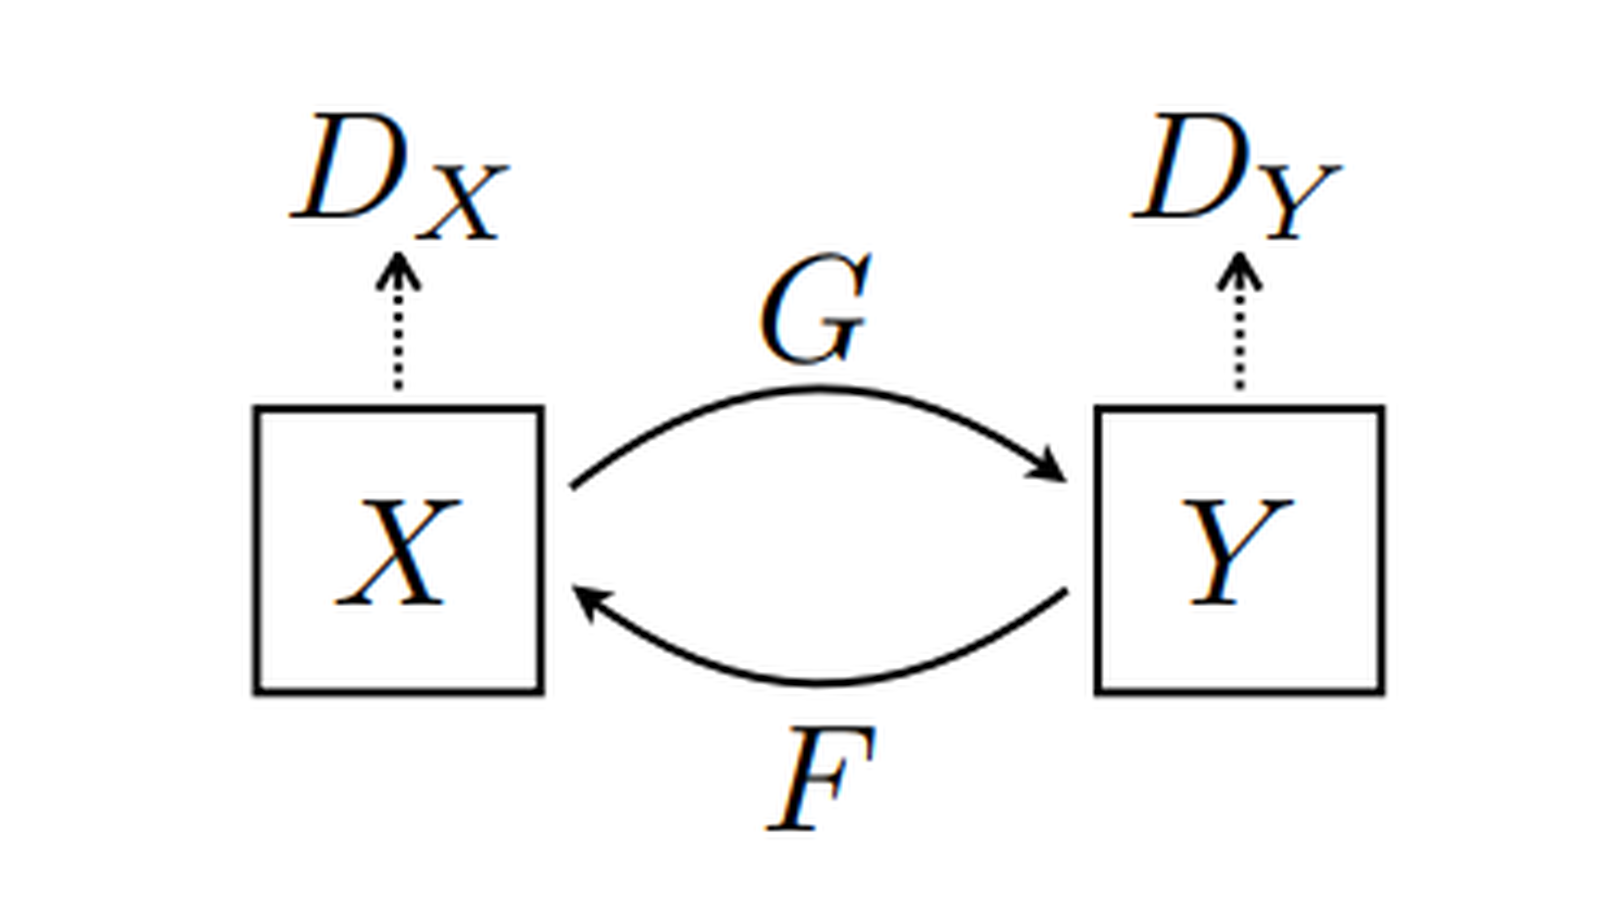
假設 X 是一組冬景,Y 是另一組夏景,兩邊並沒有相同位置、相同構圖的成對照片。CycleGAN 學習兩個映射:G:X→Y 與 F:Y→X,再分別用 D_Y、D_X 檢查翻譯結果像不像各自的目標域。
只要求 G(x) 像 Y、F(y) 像 X,仍允許很多不同的對應。Cycle consistency 再要求兩個方向組合後能近似回到出發點:
X方向:x → G(x) → F(G(x)) ≈ x
Y方向:y → F(y) → G(F(y)) ≈ y

L_cycle = E_x ||F(G(x)) − x||_1
        + E_y ||G(F(y)) − y||_1

L_total = L_adv(G,D_Y) + L_adv(F,D_X) + λ L_cycle
這裡可以比較的是原始 x 與回到 X 的重建、原始 y 與回到 Y 的重建。它不是拿某張任意 y 當成 G(x) 的逐像素標準答案,也不是把未配對資料偷偷當成 Pix2Pix 配對資料。CycleGAN 原論文 §3.1–3.3 定義這兩種約束。
CycleGAN 常被放在 conditional/image-translation 的脈絡談,因為生成結果取決於輸入影像;但標準方法中的 D_Y 不需要接收那張來源 x 作為成對條件。它在 Y 域判真假,D_X 在 X 域判真假。這與上一節 D(x,y) 看配對的任務有別。
來源版本也要分開看:原論文主要使用 ResNet 型生成器,實作採 least-squares adversarial loss;本文選用的 TensorFlow 教材為方便教學,改用 modified U-Net 與 instance normalization。不能將上圖叫成「原論文的完整 U-Net 架構」,也不能把 BCE 與 least-squares loss 的數值刻度直接比較。Optional identity loss 會另外鼓勵 G(y)≈y、F(x)≈x,它與 cycle loss 是不同限制,不是上述往返式自動包含的項。
反例:cycle 完全正確,為什麼仍可能配錯答案?
把影像先縮成能全部列完的兩點世界。已知真正的配對是 0→0、1→10;X 的兩點等機率,Y 的兩點也各占一半。
我們設定兩組映射,各自都有反函數:
| 組合 | G(0)、G(1) | F(0)、F(10) |
|---|---|---|
| 對齊 | 0、10 | 0、1 |
| 對調 | 10、0 | 1、0 |
兩組 G 的輸出都包含一個 0、一個 10,所以 Y 的生成邊際分布完全相同。任何只看 Y 單點的固定判別函數 d,其期望都是 0.5d(0)+0.5d(10);光靠這個邊際,無法區分哪組配對才是我們想要的。
對調組也可以完整往返:0→10→0、1→0→1;從 Y 出發的兩條路也都回到原點。因此兩個方向的 cycle error 都是零。
但逐張配對的 L1 會分出差別。對調組的兩筆誤差分別為 |10−0|=10、|0−10|=10,平均就是 10;對齊組為 0。若 D 還看到來源與目標組成的 pair,它比較的資訊也已經不同。本反例沒有實作或訓練這種 D,只是在數學上區分它可以看到哪些資料。
這證明一個有限的可識別性限制:匹配目標邊際分布,加上完美往返,仍不足以唯一選出預期的配對。 它不是在宣稱真實 CycleGAN 必定失敗,也沒有測量失敗率、影像品質或不同模型誰比較好。
下面是完整附件。存成 paired_cycle_counterexample.py,以 Python 3 執行;只有標準庫,不需 pip、資料下載或 GPU。保存執行環境為 Python 3.10.12,已實際執行並另以有限集合與精確分數算術核對;不同平台的新環境不在這次實測範圍。
python3 paired_cycle_counterexample.py
"""Finite paired-L1 vs cycle-consistency example; no GAN or image model is trained."""
import json


def mean_absolute_error(left, right):
    if len(left) != len(right) or not left:
        raise ValueError("expected equally sized non-empty lists")
    return sum(abs(a - b) for a, b in zip(left, right)) / len(left)


def apply(mapping, values):
    return [mapping[value] for value in values]


def main():
    # Two paired examples: x=0 maps to y=0, and x=1 maps to y=10.
    x_domain = [0, 1]
    y_domain = [0, 10]
    paired_targets = [0, 10]

    # A semantically aligned bijection and a consistently swapped bijection.
    forward_aligned = {0: 0, 1: 10}
    backward_aligned = {0: 0, 10: 1}
    forward_swapped = {0: 10, 1: 0}
    backward_swapped = {10: 0, 0: 1}

    aligned_y = apply(forward_aligned, x_domain)
    swapped_y = apply(forward_swapped, x_domain)
    aligned_x_cycle = apply(backward_aligned, aligned_y)
    swapped_x_cycle = apply(backward_swapped, swapped_y)
    aligned_y_cycle = apply(forward_aligned, apply(backward_aligned, y_domain))
    swapped_y_cycle = apply(forward_swapped, apply(backward_swapped, y_domain))

    aligned_paired_l1 = mean_absolute_error(aligned_y, paired_targets)
    swapped_paired_l1 = mean_absolute_error(swapped_y, paired_targets)
    aligned_x_cycle_l1 = mean_absolute_error(aligned_x_cycle, x_domain)
    swapped_x_cycle_l1 = mean_absolute_error(swapped_x_cycle, x_domain)
    aligned_y_cycle_l1 = mean_absolute_error(aligned_y_cycle, y_domain)
    swapped_y_cycle_l1 = mean_absolute_error(swapped_y_cycle, y_domain)

    # Independent finite-set checks: compare sorted empirical output multisets,
    # and enumerate both compositions directly on every domain element.
    same_output_multiset = sorted(aligned_y) == sorted(swapped_y)
    all_x_roundtrips = all(
        backward_swapped[forward_swapped[x]] == x for x in x_domain
    )
    all_y_roundtrips = all(
        forward_swapped[backward_swapped[y]] == y for y in y_domain
    )

    checks = {
        "paired_targets_match_declared_pairs": paired_targets == [0, 10],
        "output_marginals_are_identical": same_output_multiset,
        "aligned_mapping_has_zero_paired_l1": aligned_paired_l1 == 0.0,
        "swapped_mapping_has_paired_l1_10": swapped_paired_l1 == 10.0,
        "aligned_mapping_has_zero_x_and_y_cycle_error": aligned_x_cycle_l1 == 0.0 and aligned_y_cycle_l1 == 0.0,
        "swapped_mapping_has_zero_x_and_y_cycle_error": swapped_x_cycle_l1 == 0.0 and swapped_y_cycle_l1 == 0.0,
        "swapped_mapping_roundtrips_every_finite_domain_element": all_x_roundtrips and all_y_roundtrips,
    }
    assert all(checks.values()), checks

    print(json.dumps({
        "scope": "Exact two-point scalar mapping counterexample only. It does not implement a discriminator, adversarial optimization, image translation, GAN training, dataset evaluation, or quality/benchmark measurement.",
        "domains_and_pairs": {
            "X": x_domain,
            "Y": y_domain,
            "paired_supervision": [{"x": x, "target_y": y} for x, y in zip(x_domain, paired_targets)],
        },
        "aligned_bijection": {
            "G_X_to_Y": forward_aligned,
            "F_Y_to_X": backward_aligned,
            "G(X)": aligned_y,
            "paired_L1_mean": aligned_paired_l1,
            "F(G(X))": aligned_x_cycle,
            "X_cycle_L1_mean": aligned_x_cycle_l1,
            "G(F(Y))": aligned_y_cycle,
            "Y_cycle_L1_mean": aligned_y_cycle_l1,
        },
        "swapped_bijection": {
            "G_X_to_Y": forward_swapped,
            "F_Y_to_X": backward_swapped,
            "G(X)": swapped_y,
            "paired_L1_terms": [abs(pred - target) for pred, target in zip(swapped_y, paired_targets)],
            "paired_L1_mean": swapped_paired_l1,
            "F(G(X))": swapped_x_cycle,
            "X_cycle_L1_mean": swapped_x_cycle_l1,
            "G(F(Y))": swapped_y_cycle,
            "Y_cycle_L1_mean": swapped_y_cycle_l1,
        },
        "comparison": {
            "same_generated_empirical_marginal": same_output_multiset,
            "cycle_consistency_alone_does_not_identify_the_pairing_in_this_example": True,
            "paired_L1_distinguishes_the_two_mappings": True,
            "interpretation": "The swapped maps are exact inverses and produce the same finite Y marginal as the aligned map, so both directions have zero cycle error. Paired supervision penalizes the swapped correspondence by mean absolute error 10. This finite construction demonstrates an identifiability limitation; it is not evidence about real model quality.",
        },
        "checks": checks,
    }, indent=2, ensure_ascii=False, allow_nan=False))


if __name__ == "__main__":
    main()
保存 stdout 的主要結果如下;JSON 物件中的 mapping keys 會顯示為字串,是序列化格式,不代表程式把算術輸入改成字串。
G(X)[0,10]/[10,0]實際規劃未配對影像翻譯時,應先寫出哪些內容必須保留,再設計獨立於 cycle loss 的驗證。若任務要求物體數量、位置或身分不可變,僅以風格像目標域、往返誤差低作為驗收,仍缺少直接檢查這些要求的證據。
StyleGAN:把 latent 變成逐層控制,而不是另一種配對翻譯
前面問的是「從這張輸入翻成哪張輸出」;原 StyleGAN 問的則是,從 latent 生成新影像時,能否更明確地控制不同尺度的變化。它不要求輸入一張待翻譯照片,也不以某張照片的配對 L1 作為其定義。
原 StyleGAN 的資料流可拆成四部分:
共用 constant 不表示所有輸出相同,因為逐層 style 與 noise 仍會改變生成過程。反過來說,增加 noise 也不等於你已經得到可精確命名、互不干擾的語意控制。
原設計的 AdaIN 先對每個 feature channel,依該樣本的空間位置計算平均與標準差,再套由 style 給定的 scale、bias:
AdaIN(feature_i, style)
  = scale_i(style) × (feature_i − spatial_mean_i) / spatial_std_i
    + bias_i(style)
這裡的 style 來自 w 的 learned affine,不是由一張參考風格照片直接算得;「style」也不只指畫風,它是這個生成器內部控制特徵的方式。實際正規化仍需數值穩定處理,不能由簡式推出任意常數 channel 都可直接除以零。
原論文對 noise 的觀察是:在其人臉實驗中,noise 常影響髮絲、雀斑等隨機細節,而 style 會影響較全域的變化。這是來源設定下的觀察,不是對所有資料、任意權重都成立的完美分離定理。中介空間 W 由 mapping 學出,也不保證仍是標準 Gaussian 或每一個維度都對應獨立的可命名屬性。依據可讀 原 StyleGAN §2–3。
Style mixing:換的是哪些層使用哪個 w
將 z_A、z_B 分別經 mapping 得到 w_A、w_B,再讓不同層使用不同來源的 style,就能做 style mixing。它不是把兩張照片的像素平均,也不是先把兩個 w 做平均後才送進所有層。原論文還在訓練中隨機選 crossover point 做 mixing regularization,減少網路只依賴相鄰層 style 固定相關的情況。
可以開啟原論文 Fig. 3,PDF p4 對照讀;這裡只提供原圖連結,不重刊人臉網格。左欄是 Source A,上排是 Source B。交叉位置的影像,從對應欄的 B 取某一段解析度的 style,其餘 style 仍來自對應列的 A:
這是特定生成器與資料上的分組,不表示「第幾層永遠就是眼鏡開關」,也不表示任意混搭都不會改變其他屬性。要讀的是「改變哪一組層的 style 來源」,再看其觀察結果;不要把 A/B 行列讀反後推導控制效果。
StyleGAN2:將 style 的調制搬到卷積權重
原始 StyleGAN 在 2018 年提出;StyleGAN2 的預印本出現在 2019 年,CVPR 2020 的方法修訂了生成器的正規化方式。接下來這張圖是後者的局部 block,不能拿來當成前面 AdaIN 設計的原架構。
原 StyleGAN 的 AdaIN 依當前 feature map 計算統計量;StyleGAN2 的這個改動,則把每個樣本的 style 尺度作用寫進卷積權重,接著依權重估計輸出尺度作 demodulation。
為了避免圖上的 latent w 與 convolution weights w 混淆,下面把卷積權重改記成 k;i 是輸入 channel、j 是輸出 channel、r 是 kernel 空間位置。
style 經 affine 產生輸入 channel 尺度 s_i

modulation:   k'_ijr = s_i × k_ijr

demodulation: k''_ijr = k'_ijr / sqrt(sum_(i,r) (k'_ijr)^2 + epsilon)

使用這個樣本對應的 k'' 做卷積,再處理 noise、bias 與 activation
其尺度估計建立在輸入激活獨立同分布、單位標準差的分析假設上;epsilon 避免數值問題。這不是對當前 feature map 的實測均值/變異數再套 AdaIN,也不保證任意實際激活都被精確變成單位變異數,更不是讓它們必然服從 Gaussian。StyleGAN2 v2 §2.1–2.2、Eq. 1–3 說明了這個重寫與限制。
圖上的 modulation 與 convolution 不是兩套同時重複套用的 scale:透過把 scale 併入權重,可以實作原本對輸入 feature 先縮放再卷積的效果。demodulation 再依各輸出 channel 的 modulated-weight norm 重縮放。把這三步混成「每張圖都先做一次全圖標準化」,就會失去 style 如何影響權重的重點。
本篇沒有下載或執行 StyleGAN checkpoint,也沒有做 style mixing、影像品質或效能比較。讀這些方法時,最有用的第一個判斷仍是:你缺少的是可用的條件、可靠的配對、對映射的約束,還是對生成器內部變化的控制?條件餵給哪裡、誤差比較哪兩個東西,比單看模型名稱更能幫你選擇資料與驗證方式。
原始方法與圖片來源
本文由原始方法重新組織教學、加入兩點反例與逐圖讀法;沒有重刊原論文的實驗照片或將其結果冒稱本站實跑。實作附件只枚舉有限映射,未使用 TensorFlow/GAN 訓練。六張說明圖各自沿用下列來源授權;圖 1–5 的 CC BY 與圖 6 的 CC BY-SA 分開適用。
- Conditional Generative Adversarial Nets,Mirza/Osindero,2014,v1:條件同時提供給 G 與 D。
- Image-to-Image Translation with Conditional Adversarial Networks,Isola 等,Pix2Pix v3:配對目標、L1、U-Net、PatchGAN 與原實作的 dropout/推論設定。
- Unpaired Image-to-Image Translation using Cycle-Consistent Adversarial Networks,Zhu 等,CycleGAN v7:兩向映射、對抗目標與 cycle consistency。
- A Style-Based Generator Architecture for Generative Adversarial Networks,Karras/Laine/Aila,StyleGAN v3:原始 mapping、AdaIN、noise 與 style mixing;其 Fig. 3 為連結閱讀,未在本站重刊。
- Analyzing and Improving the Image Quality of StyleGAN,Karras 等,StyleGAN2 v2:權重 modulation/demodulation,非本文實跑品質實驗。
- Gao 等,Few-shot SAR vehicle target augmentation based on generative adversarial networks,Fig. 2(a),2024:Dan Gao、Xiaofang Wu、Zhijin Wen、Yue Xu、Zhengchao Chen 的 class-conditioned GAN 示意;只採作者機制圖,不引用 SAR 資料或成效。
- TensorFlow Pix2Pix tutorial:TensorFlow 文件貢獻者的 U-Net/PatchGAN model graphs、generator update 圖;屬教材版本的圖文,未在本站執行該訓練。
- TensorFlow CycleGAN tutorial:TensorFlow 文件貢獻者的兩域映射示意與封面來源,非照片或完整架構。
- Cosmia Nebula,StyleGAN-1 and StyleGAN-2:只用右側 StyleGAN2 block,選區、白底與手機放大如圖說;未採原始 StyleGAN1 左側圖。
- 圖 1–5 適用 CC BY 4.0;圖 6 的裁切與手機改作適用 CC BY-SA 4.0。TensorFlow 頁面的 code-sample Apache 條款不混作圖片授權;本篇可跑 Python 為自訂有限集合反例,不是轉貼 TensorFlow 模型程式。
留言0
登入後就能留言。
登入