
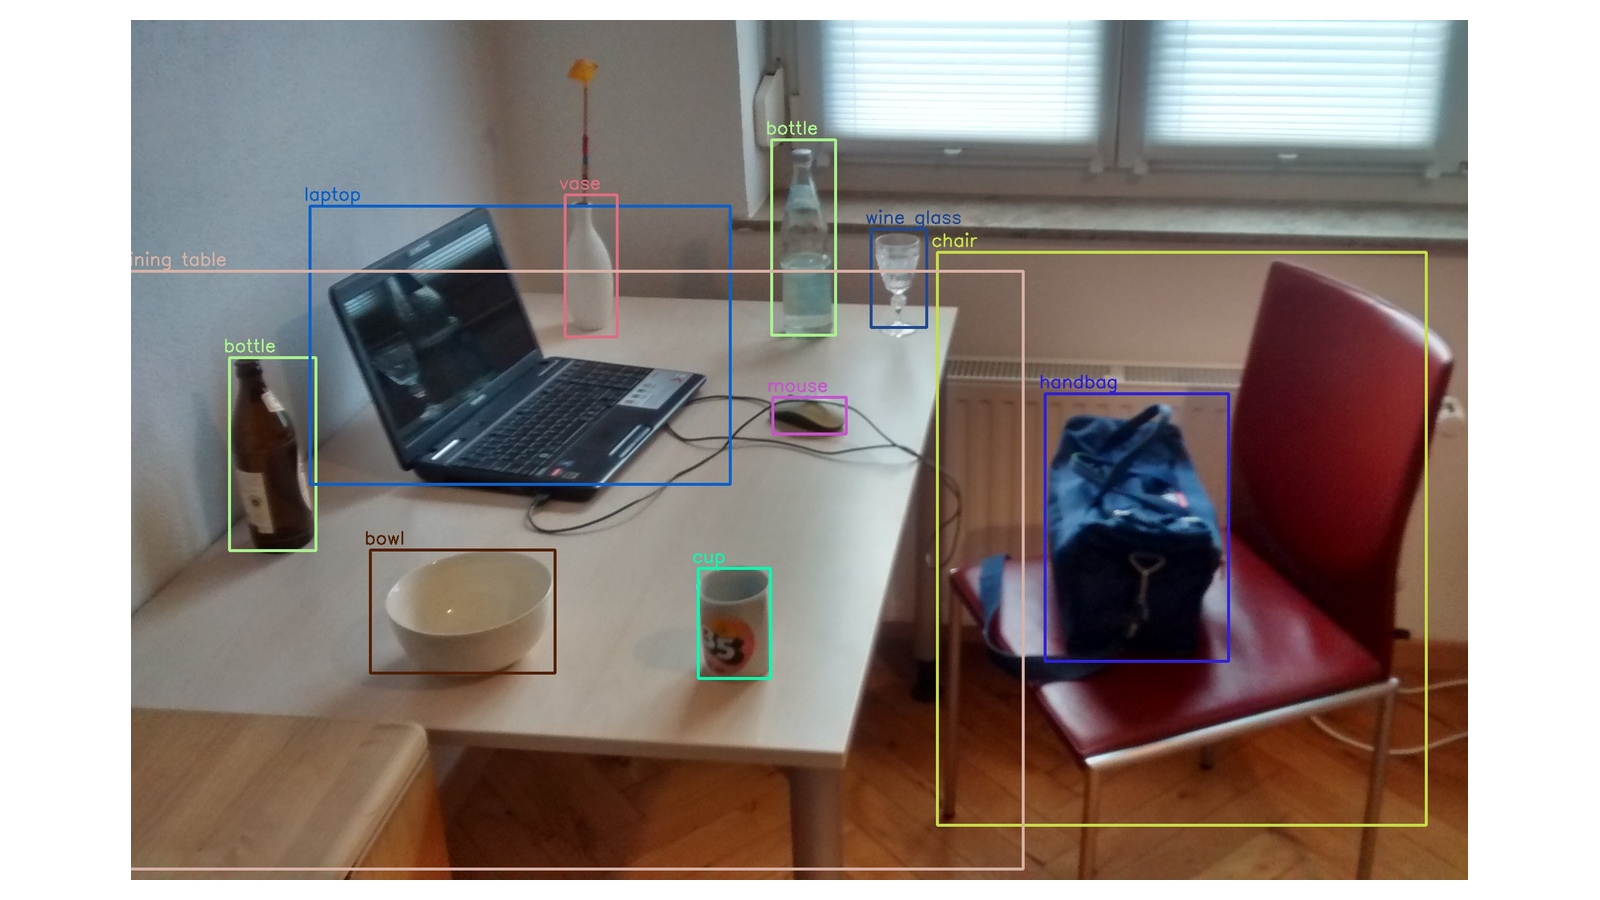
如果要知道桌上有哪些東西,只回傳「這張照片有杯子」還不夠。你可能需要找出每個杯子的位置、區分旁邊的瓶子,再把結果交給盤點或互動介面。物件偵測的輸出因此是一份清單:每個預測包含類別、框的位置,以及供篩選與排序使用的分數。
R-CNN 系列先提出可能有物件的區域,再對區域辨識;YOLOv1 則讓網路直接輸出整張影像的一組框與分數。理解差異之後,還要再分開三件事:分數篩選決定哪些預測值得留下,NMS 減少彼此重複的框,評估則拿預測與標準答案配對。三者即使都出現「0.5」,也不是同一個條件。
上一篇討論如何借用表示、設計影像增強與節省計算。這篇把分類模型往定位任務延伸,先讀架構與既有原圖,再用小程式核對框的幾何及後處理。程式沒有載入 R-CNN 或 YOLO、沒有對照片推論,也沒有測試準確率與速度。
分類給一個答案,偵測要為每個物件留下位置
圖1|這是 MTheiler 提供的 YOLOv3、OpenCV DNN 示範,作者說明使用以 COCO 訓練的模型;不是 YOLOv1 的結果,也不是本站執行。照片上有 laptop、bottle、cup 等預測標籤,表示輸出可以同時包含多個物件。圖中標籤不是逐一驗證過的標準答案,原頁也沒有提供本次精確權重、分數門檻與 NMS 設定,不能用這張圖計算模型品質。照片及標框輸出均為作者 Own work,CC BY-SA 4.0。手機先看完整圖,再看左右局部放大;跨局部的大框邊界仍以完整圖為準。原作左緣部分截斷的標籤保持原樣,未補字或新增分數。
分類通常把整張輸入映射到類別;偵測還要決定哪些區域對應哪些物件。常見的軸對齊框以兩個角表示:
(x1, y1, x2, y2)
若原點在影像左上,x 往右、y 往下增加,這四個數就是左上與右下座標。另一種寫法是中心與寬高:(cx,cy,w,h)。在本篇採用的連續座標慣例下:
cx=(x1+x2)/2,cy=(y1+y2)/2
w=x2-x1,h=y2-y1
框 [0,0,2,2] 的中心是 [1,1],寬高都是2。這是後面算例的抽象座標,沒有對應圖1的某個真實物件。讀實作時,還需確認座標是像素或正規化數值、邊界是否包含端點,以及影像縮放後框有沒有同步變換。部分歷史評分程式採像素邊界含端點的 +1 寫法,不能和這裡的連續面積混算。
框也不是物件的精確輪廓。它會包含背景,兩個物件的框也可能重疊;若任務需要逐像素位置,還要進一步考慮影像分割。
R-CNN 把候選區域交給 CNN,Fast R-CNN 改成共享整圖特徵
早期 R-CNN 的想法是:先縮小要查的範圍,再使用 CNN 判斷。原版以 Selective Search 產生約兩千個與類別無關的候選區域;每個區域被調整成固定尺寸,各自通過 CNN 取出特徵,再由逐類線性 SVM 分類,並以 bounding-box regression 調整位置。
「候選區域」只是值得進一步檢查的地方,不代表已經辨識出某一類。它可能含物件,也可能主要是背景。同一物件附近還可能有多個很像的候選框。
每個區域都重新做 CNN 計算,是這套流程的重要成本。兩個大幅重疊的候選區域,會重複處理許多相同像素。Fast R-CNN 把昂貴的卷積特徵擷取移到整張影像上共享,之後再依每個 RoI 取出對應特徵。
圖2|由下往上讀:CNN 提供共享影像特徵,右側 Selective Search 提供區域位置;兩者在 RoI pooling 匯合,經 FC 後分成類別與位置預測。這張圖保留 D2L 原作者的完整網路示意部分,省略下方輸入照片及其兩條輸入箭頭;並未改畫節點或加入新路徑。原含照片的整張混合圖不在本站重刊。D2L 四位作者,圖像改作 CC BY-SA 4.0。
Fast R-CNN 的「Fast」不表示它已經學會產生候選區域。原論文仍使用外部的 Selective Search。它改變的是特徵共享與 detector 的訓練:每個區域的表示送往 softmax 分類與 box regression,分類和位置損失可以一起訓練。
原版 R-CNN 的逐類 SVM,與 Fast R-CNN 的 softmax head 也不應混稱。若有 K 個前景類別,Fast R-CNN 原論文的分類輸出含背景,共 K+1 類;位置分支提供各前景類別的四個回歸量。教材架構圖只畫功能分支,沒有列出所有 tensor 維度。
RoI pooling:不同大小的區域,如何得到固定尺寸表示?
假設同一張特徵圖上,有一個狹長候選區域和一個接近正方形的區域。後面的全連接層希望收到固定大小的輸入,但這兩個區域直接切出來的尺寸不同。RoI pooling 便在每個區域內設定固定數量的 bins,再對各 bin 做 max pooling。
圖3|左側是值0至15的4×4特徵圖,粗框標出左上3×3 RoI;教材以2×2輸出說明固定大小 pooling,得到 [[5,6],[9,10]]。這是原作者的數值示意,不是物件分類結果,也不是本站新跑出的特徵。來源:D2L,CC BY-SA 4.0;原 SVG 轉白底 PNG。
讀這張圖時,重點是「區域大小可以變,輸出 bins 的數量固定」。實際 API 還有座標縮放、端點量化與 bin 邊界取整,不能把示意圖的每個色塊分區當成所有實作一致的規則。RoI pooling 與後來的 RoI Align 也不同,後者用插值處理對齊問題;本篇先聚焦 Fast R-CNN 的 pooling。
例如 Torchvision0.18 的 roi_pool 若以 K×5 tensor 傳框,第一欄是 batch index,後面才是四個框座標,並不是物件類別。spatial_scale 則把影像座標映射到輸入特徵圖的座標。這些是官方文件的約定;文末標準函式庫程式沒有實作或呼叫 RoI pooling。
Faster R-CNN 把候選區域生成也交給網路
Fast R-CNN 省下重複卷積後,外部候選區域生成仍是一個步驟。Faster R-CNN 加入 Region Proposal Network,簡稱 RPN,讓候選區域生成也使用共享的卷積特徵。
圖4|右側虛線內是 RPN:共享特徵經 Conv,再對參考框預測前景/背景與位置,候選結果經 NMS 送往左側 RoI pooling。左側的最終類別與位置分支仍然存在。這是 D2L 架構示意的網路部分,下方輸入照片、邊框及其輸入箭頭已排除;網路節點、RPN 邊界與標籤保留。手機先保留完整節錄圖,再放大 RPN;跨區域連線需回看完整圖。圖像改作 CC BY-SA 4.0。
RPN 的 objectness 問「這裡像不像我們關心的前景物件」,不等於最後已經分出杯子、瓶子或筆電。Faster R-CNN 仍有兩個功能階段:先提出區域,再對區域做更具體的辨識與定位。
RPN 常以 anchors 作參考。Anchor 是事先定義的框位置與形狀,網路預測相對它的位移與尺寸變化;它不是一開始就準確包住某個物件的答案。共享卷積特徵也不代表所有歷史實作都只用一次完全相同的聯合反向傳播:原 Faster R-CNN 論文的主要實驗採交替訓練,另討論共同訓練方案。理解架構時,先分清共享了哪些計算,再查具體訓練方法。
| 方法 | 區域從哪裡來? | CNN 特徵如何取得? | 後續分類方式 |
|---|---|---|---|
| R-CNN,CVPR2014 | 外部 Selective Search 等方法 | 每個候選區域各自處理 | 原版逐類線性 SVM,加框回歸 |
| Fast R-CNN,ICCV2015 | 仍是外部候選區域 | 整圖卷積共享,RoI pooling 取區域表示 | softmax 與框回歸 head |
| Faster R-CNN,2015 | 共享特徵上的 RPN | RPN 與後段 detector 共用卷積特徵 | 區域提出後,再由 detector 分類與回歸 |
表中以主要會議發表年標示,不代表每篇的最早預印本都在同一年。這是方法差異表,沒有拿不同資料集與硬體的歷史速度數字排出現代設備的名次。
IoU 是重疊量;anchor 配對是在分派訓練工作
圖5|分子是兩框交集,分母是兩框聯集。IoU 衡量幾何重疊,不是分類分數。來源:D2L,CC BY-SA 4.0;完整原 SVG 轉白底 PNG。
兩個正面積框 A 與 B 的 IoU 為:
IoU(A,B)=交集面積/聯集面積
聯集面積=面積A+面積B-交集面積
完全相同時是1,不重疊時是0。文末用 A=[0,0,2,2]、B=[0.2,0.2,2.2,2.2]:交集寬高都是1.8,面積3.24;聯集為 4+4-3.24=4.76,所以 IoU 是 81/119≈0.680672。這個值只說兩框重疊多少,不表示預測有68%的機率正確。
在 anchor 型 detector 的訓練中,還要決定哪些 anchors 負責哪些 ground-truth 物件,才能產生類別與框位移的學習目標。這是訓練配對問題,與輸出後去除重複框不同。
圖6|三個面板的行是9個 anchor 索引、列是4個 ground-truth 索引,格子裡的 x_ij 代表 IoU。教材先示範選出 x23、x71、x54、x92 這些最大剩餘配對,刪去已選的行與列,再處理剩餘 anchors 的門檻配對。藍色區域是逐步保留的搜尋範圍,不是框在影像裡的實際座標。手機先列完整圖,再分開放大三個面板,重用原圖共同的標題與行列索引;沒有加入新數據。來源:D2L,CC BY-SA 4.0。
這張圖說明一種分派策略:先讓每個標準答案有可負責的參考框,再為剩下的候選判斷是否足夠重疊。不同模型的正負例規則、門檻與匹配方式可能不同;不要把這一張教材圖當成 RPN、SSD 和所有 YOLO 版本完全相同的訓練程式。
負例與正例也不是單純把所有框一起做位置回歸。背景 anchor 沒有要對齊的前景物件,常會以 mask 等方式排除其位置損失;類別分支則仍要學會辨認背景。具體 loss 的加權與正負樣本比例,應回到該模型的訓練配方查核。
YOLOv1:直接輸出網格預測,不能混成後來的 anchor 版本
YOLOv1 把整張影像的偵測輸出放進一次網路計算,不先執行外部 region proposal,再逐框做 RoI 特徵擷取。它的設計用網格分派責任:物件中心落在哪格,該格負責處理該物件。
原論文的 PASCAL VOC 設定可以拆成以下幾項:
7×7×(2×5+20)=7×7×30其中 x、y 是相對該格的框中心位置,w、h 相對整張影像寬高。**類別機率是每格一組,不是每個框各有獨立的一組20類。**這些框也不是後來版本先定形狀、再回歸位移的 anchor boxes。
原 YOLOv1 對 box confidence 的定義結合了物件存在與定位品質;推論時,再把每格的條件類別機率與該框 confidence 相乘,形成每類的排序分數。推論沒有 ground-truth 可以直接算 IoU;網路是在預測這種品質訊號,不是偷看答案。這個定義也不能泛化成所有 YOLO 世代的相同公式,更不能把顯示的分數一律當成校準過的正確機率。
「一次網路計算」也不表示沒有任何後處理。原論文仍討論使用 NMS 去除多重偵測。另一方面,每格共享類別表示及有限的框預測,會限制擁擠小物件的表達能力;不能只從「看一次」的名稱推論它永遠比候選區域方法適合所有任務。
YOLOv1 的網格原圖可對照原論文 Figure2。本篇保留原文連結;圖1的 YOLOv3 外部輸出用於看偵測清單的外觀,不拿來填補 v1 架構的版本差別。
SSD:在多個尺度的特徵圖上預測
圖7|由 base network 往上,各個尺度都有自己的參考框與預測分支;不只是最後一張特徵圖輸出結果。D2L 圖中使用 Anchor box 這個名稱,原 SSD 論文通常稱 default boxes。本站只保留原作者網路示意部分,省略底部輸入照片與其輸入箭頭,其他分支不重畫。手機先保留完整節錄圖,再分尺度放大;放大區省略跨尺度縱線的裁切殘段,僅供讀取各分支,跨尺度關係以完整圖為準。圖像改作 CC BY-SA 4.0。
SSD 同樣不使用外部候選區域管線,但它和 YOLOv1 的輸出安排不同。SSD 在不同解析度的特徵圖上配置 default boxes,對每個位置的參考框預測類別與位置偏移,再合併多尺度結果。
較高解析度的特徵圖有較密集的位置,較深層的特徵圖常有較大的感受野。不同尺度有助於覆蓋不同大小的物件,但不能由這個概念直接保證「小物件一定被低層找到」。參考框尺寸、解析度、訓練資料與特徵品質都會影響結果。
教材的 TinySSD 是幫助理解積木的簡化模型,不能直接當成原論文 SSD 的完整重現。原 SSD 訓練包含 hard-negative mining 等設計,而教材把負例下採樣列為後續改進練習;教材訓練過程的 anchor class error 也不等於偵測 mAP。本篇沒有訓練任何一種 SSD。
分數篩選與 NMS:留下高分框,再減少重複
分數篩選只看分數:例如保留 score>=0.5。兩個高度重疊的框可以同時超過0.5,所以單靠分數門檻,未必消除對同一物件的重複預測。
Greedy NMS 先按分數由高到低排序,保留最高分框,再刪掉與它過度重疊的低分框;接著對剩下的框繼續處理。這是保留與抑制,不是把幾個框的座標平均成一個新框。
圖8|來源手工設定三個 dog 框分數0.9、0.8、0.7,以及一個 cat 框0.9;這些不是某個已訓練 detector 跑出的分數。本站移除來源中獨立的背景照片圖層,保留原框、分數、顏色與座標軸,讓重疊關係可以單獨閱讀;不重畫原數據。D2L,改作 CC BY-SA 4.0。
圖9|來源以 NMS IoU 門檻0.5處理後,保留 dog0.9 與 cat0.9,原有兩個 dog 低分重疊框被抑制。兩個保留框在這張來源輸出中都畫成藍色,顏色不代表變成同一類。本站同樣只移除背景照片,保留原作者的框與標籤;不是本站程式的輸出。D2L,改作 CC BY-SA 4.0。
還有一個設定差別:class-aware NMS 只在同類之間比較,class-agnostic NMS 則可能跨類別抑制。兩個框重疊,不一定就是同一物件;擁擠或遮擋的場景中,強硬抑制可能把有用框一起刪掉。
D2L 這段簡化實作先取每個框的前景最大分數,再對全部框呼叫一次 NMS,並不是按類別分組。圖中的 cat 與 dog 能同時留下,是因為它們的幾何重疊沒有超過該門檻,不能用它證明程式在保護不同類別。Torchvision0.18 的 batched_nms 則明示依 category 隔離;具體產品設定仍應按實作確認。
文末另外設四個純數字框,獨立展示三種結果:
| 操作,各自對原始四框執行 | 保留的原始索引 | 原因 |
|---|---|---|
| score>=0.5 | [0,1,2] | 索引3分數低,但重疊框1仍在 |
| IoU門檻0.5,class-aware NMS | [0,2,3] | 1被同類0抑制;不同類2保留;遠處3沒有重疊 |
| IoU門檻0.5,class-agnostic NMS | [0,3] | 2雖不同類,仍因與0重疊而被抑制 |
這三列沒有先串接分數篩選再做 NMS,所以 NMS 結果仍含低分的3。若真的先篩掉3,再做 NMS,保留原索引會分別是 class-aware 的 [0,2] 與 class-agnostic 的 [0]。
本例 NMS 在 IoU 嚴格大於門檻時抑制;相等仍保留。同分時,本程式用原索引決定先後,方便重現;這不是宣稱所有函式庫在 CPU/GPU 上都有相同 tie 行為。
AP 評估:與標準答案配對,重複框仍可能是 FP
輸出看起來有框,不等於偵測正確。評估時還要問:類別對不對?和正確物件的位置重疊夠不夠?是否同一個物件被重複報告?
以下是文末的單影像、單類別、小型規則示例。有兩個標準答案 A 和 D,四個預測按分數由高到低處理。先找該預測對所有 GT 的最大 IoU;達到本例門檻且 GT 尚未被使用,才算 TP。最高重疊的 GT 已被使用時,本例判 FP,不再改配別的 GT。
| 排序位置 | 預測內容 | 本例判定 | 累計 Precision | 累計 Recall |
|---|---|---|---|---|
| 1 | 正確的A | TP | 1 | 1/2 |
| 2 | 另一個也指向A的重疊框 | FP,重複 | 1/2 | 1/2 |
| 3 | 遠處背景框 | FP,無匹配 | 1/3 | 1/2 |
| 4 | 正確的D | TP | 1/2 | 1 |
本例再把 precision 轉成向右取最大值的 envelope,在 recall 變化的位置積分:
AP=(1/2-0)×1+(1-1/2)×(1/2)=3/4
它不是四個 precision 的平均,也不是把這四點直接做梯形面積。沒有任何預測、但有 GT 時,本例 AP 為0;完全沒有 GT 的情況則明確不在這個教學函式的定義內。
這裡的配對與 AP 不是完整 COCO 或指定 VOC 版本的評分器。例如 COCO 會略過已配對的非 crowd GT 再搜尋其他可配對目標;對兩個互相重疊的 GT,本例與它可能得到不同結果。正式評估還有多張影像、多類別、ignore、difficult、crowd、最大輸出數與面積範圍等規則。
VOC2007 的11點 AP、後續使用 precision envelope 的全點積分,以及 COCO 常用的10個 IoU 門檻與101個 recall 取樣點,也不是一個數值口徑。因此讀到 mAP,至少要看清資料集、切分與評分協定。本文沒有用這個小例宣稱任何模型取得75%的正式 mAP。
| 看起來都像「門檻」的東西 | 比較的是誰? | 工作 |
|---|---|---|
| 輸出 score cutoff | 模型分數與最低分數 | 篩選候選 |
| NMS IoU threshold | 預測框與預測框 | 減少重複輸出 |
| 評估 IoU matching threshold | 預測框與 ground truth | 判斷定位是否足以計作命中 |
| 訓練 anchor matching threshold | 參考框與 ground truth | 分派訓練目標 |
這四種用途應各自設定與記錄。文末的評估命中採 IoU>=0.5,NMS 抑制採 IoU>0.5;不要因為數字相同就把運算子和語意一起換掉。
跑一個不用模型與照片的機制核對
將下列程式存為 detection_checks.py,執行 python detection_checks.py。實際核對環境是 Python3.10.12,只用標準函式庫;Fraction 讓幾何運算保留精確分數。輸入限定正面積的連續座標框,並固定小例的排序規則,不是通用偵測 SDK。
成功時所有 assert 會通過,印出 IoU 81/119、上表的三組索引、TP/FP/FP/TP,以及 toy AP 3/4。這只能證明這些明示規則在手設資料上的運作;原型不包含 anchor assignment、RoI pooling、R-CNN、YOLO 或 SSD 推論。
"""Exact toy geometry/postprocessing; no image, detector, weights or benchmark."""
from fractions import Fraction as Q
import platform


def box(values):
    result = tuple(Q(str(x)) for x in values)
    if len(result) != 4 or result[2] <= result[0] or result[3] <= result[1]:
        raise ValueError("Need positive-area continuous xyxy boxes")
    return result


def center_wh(b):
    x1, y1, x2, y2 = b
    return ((x1+x2)/2, (y1+y2)/2, x2-x1, y2-y1)


def corners(b):
    cx, cy, width, height = b
    return (cx-width/2, cy-height/2, cx+width/2, cy+height/2)


def iou(a, b):
    width = max(Q(0), min(a[2], b[2])-max(a[0], b[0]))
    height = max(Q(0), min(a[3], b[3])-max(a[1], b[1]))
    intersection = width*height
    area = lambda t: (t[2]-t[0])*(t[3]-t[1])
    return intersection/(area(a)+area(b)-intersection)


def nms(boxes, scores, classes, threshold, class_aware):
    # Deterministic original-index tie break, not a promise about library ties.
    order = sorted(range(len(boxes)), key=lambda i: (-scores[i], i))
    kept = []
    while order:
        current, *rest = order
        kept.append(current)
        order = [j for j in rest
                 if (class_aware and classes[j] != classes[current])
                 or iou(boxes[current], boxes[j]) <= threshold]
    return kept


def toy_ap(predicted, scores, ground_truth, threshold):
    """One image, one class, no ignore/crowd/difficult or maximum-detection rule.

    Match each detection's best-IoU GT, then reject already matched GT.
    Integrate the precision envelope at every recall change; not COCO AP.
    """
    if not ground_truth:
        raise ValueError("Toy AP requires at least one ground-truth box")
    order = sorted(range(len(predicted)), key=lambda i: (-scores[i], i))
    used, true_positives, flags, recalls, precisions = set(), 0, [], [], []
    for rank, i in enumerate(order, 1):
        overlaps = [iou(predicted[i], g) for g in ground_truth]
        best = max(range(len(overlaps)), key=lambda j: (overlaps[j], -j))
        is_tp = overlaps[best] >= threshold and best not in used
        if is_tp:
            used.add(best)
            true_positives += 1
        flags.append("TP" if is_tp else "FP")
        recalls.append(Q(true_positives, len(ground_truth)))
        precisions.append(Q(true_positives, rank))
    envelope = precisions[:]
    for i in range(len(envelope)-2, -1, -1):
        envelope[i] = max(envelope[i], envelope[i+1])
    ap, previous = Q(0), Q(0)
    for recall, precision in zip(recalls, envelope):
        ap += (recall-previous)*precision
        previous = recall
    return flags, recalls, precisions, ap


print(f"python={platform.python_version()} exact_fraction_geometry; no external packages")
a = box([0, 0, 2, 2])
b = box([0.2, 0.2, 2.2, 2.2])
d = box([3, 0, 5, 2])
assert corners(center_wh(b)) == b
assert iou(a, a) == 1 and iou(a, d) == 0 and iou(a, b) == Q(81, 119)
print(f"xyxy_round_trip=True IoU_identical=1 IoU_disjoint=0 IoU_shifted={iou(a,b)} ({float(iou(a,b)):.6f})")
boxes = [a, b, a, d]
scores = [Q('.9'), Q('.8'), Q('.85'), Q('.4')]
classes = [0, 0, 1, 0]
aware = nms(boxes, scores, classes, Q('.5'), True)
agnostic = nms(boxes, scores, classes, Q('.5'), False)
score_filter = [i for i, score in enumerate(scores) if score >= Q('.5')]
assert aware == [0, 2, 3] and agnostic == [0, 3]
assert score_filter == [0, 1, 2]
assert nms([a, a], [Q('.9'), Q('.8')], [0, 0], Q(1), True) == [0, 1]
print(f"score_threshold_0.5_indices={score_filter}; NMS_IoU_threshold_0.5_class_aware={aware}; class_agnostic={agnostic}")
print("NMS_suppresses_only_IoU_strictly_greater_than_threshold=True; exact_ties_use_original_index")
predicted = [a, b, box([6, 0, 8, 2]), d]
flags, recalls, precisions, ap = toy_ap(
    predicted, [Q('.9'), Q('.8'), Q('.7'), Q('.6')], [a, d], Q('.5'))
assert flags == ['TP', 'FP', 'FP', 'TP']
assert recalls == [Q('.5'), Q('.5'), Q('.5'), Q(1)]
assert precisions == [Q(1), Q(1,2), Q(1,3), Q(1,2)] and ap == Q(3,4)
assert toy_ap([], [], [a], Q('.5'))[-1] == 0
print(f"toy_match_flags={flags} recall={[str(x) for x in recalls]} precision={[str(x) for x in precisions]} all_point_interpolated_AP={ap}")
print("scope=hand-specified positive-area continuous xyxy boxes; exact IoU, score filter, class-aware/agnostic greedy NMS and one-image/single-class all-point interpolated AP; no trained detector, photo inference, anchor assignment implementation, COCO/VOC benchmark score, accuracy gain or latency measurement")
如果要把偵測用到自己的影像,先定義「要找什麼、標註框怎麼畫、漏掉和誤報各造成什麼問題」,再依資料集規格建立切分與評估。載入預訓練模型後,記錄輸入縮放、類別表、score 與 NMS 設定,並抽看小物件、遮擋、密集物件等錯誤切片。只有在相同條件下比較,才能知道是特徵、定位、後處理,還是資料覆蓋需要改善。
來源與圖片署名
本文新增的是版本與流程比較、不同門檻的對照、純數字的 NMS/AP 說明與可重跑核對;外部示例、教材圖與本站程式輸出分開。未訓練模型、未執行照片偵測,未提供模型精度或硬體延遲的實測排名。
- 圖1:MTheiler,偵測輸出原作及底層照片原作,兩者均採 CC BY-SA 4.0。本站重刊完整既有輸出;必要的手機局部放大與封面縮放不新增預測框,圖像改作維持相同授權。原作說明是 YOLOv3/OpenCV DNN/COCO,不代表原 YOLOv1 或本站重跑。
- 圖2至圖9的原作者示意層與數值圖:Aston Zhang、Zachary C. Lipton、Mu Li、Alex Smola,D2L 英文教材,採 CC BY-SA 4.0。來源為Region-based CNNs、Anchor Boxes、SSD。本站將純圖轉白底 PNG;Fast/Faster/SSD 只保留可分離的原作者架構示意部分,排除照片與相關輸入部分;NMS 圖移除獨立照片層而保留原框、分數和軸;手機必要時將原面板放大重排。上述圖像改作均沿用 CC BY-SA 4.0。含未核照片的原始混合圖不在本站重刊,也不把教材授權延伸到那張底照。
- 原論文方法:R-CNN,CVPR2014、Fast R-CNN,ICCV2015、Faster R-CNN、YOLOv1,CVPR2016、SSD。主要核對模型設計與方法段落,沒有宣稱逐字讀完所有論文;原論文圖保留連結,未重刊。
- API 行為依 Torchvision0.18 官方文件核對:RoI pooling、NMS、依類別的 batched NMS。文件約定不代表文末程式呼叫了這些 API。
- 評估原則:VOC2012 官方 devkit 文件、Fast/Faster R-CNN 的 VOC reference implementation、COCO 官方 evaluator。官方 VOC 站在本次查核連線逾時,讀者可先參照同列的 reference code;該實作並非把本站小程式變成官方評分器;COCO 的完整 matching、ignore/crowd 與多門檻規則未由本篇程式實作。
留言0
登入後就能留言。
登入