
假設你要替幾種商品照片做分類,手上只有少量標記影像,最後還希望放進一般設備執行。這時有三個不同的問題:模型能不能借用別處學過的表示?有限的訓練影像可以產生哪些合理變化?每次推論需要多少計算?
遷移學習處理第一個問題,資料增強處理第二個問題,輕量 CNN 處理第三個問題。它們可以一起使用,但互不替代:翻轉一張照片不會新增一位獨立拍攝者;載入預訓練權重不會自動學會你的新類別;參數變少也不保證在某支手機上更快。
上一篇的 ResNet 與 DenseNet討論跨層連接,這篇接著看小資料與計算限制下的選擇。圖中的花朵是 TensorFlow 教材原有示例,卷積方格是既有教材的數字圖。本站實跑的是文末的 CPU 小程式,用來檢查凍結、模式與算子;沒有用這些照片訓練分類器,也沒有測試手機速度。
遷移學習借用的是表示,分類頭仍要對上新任務
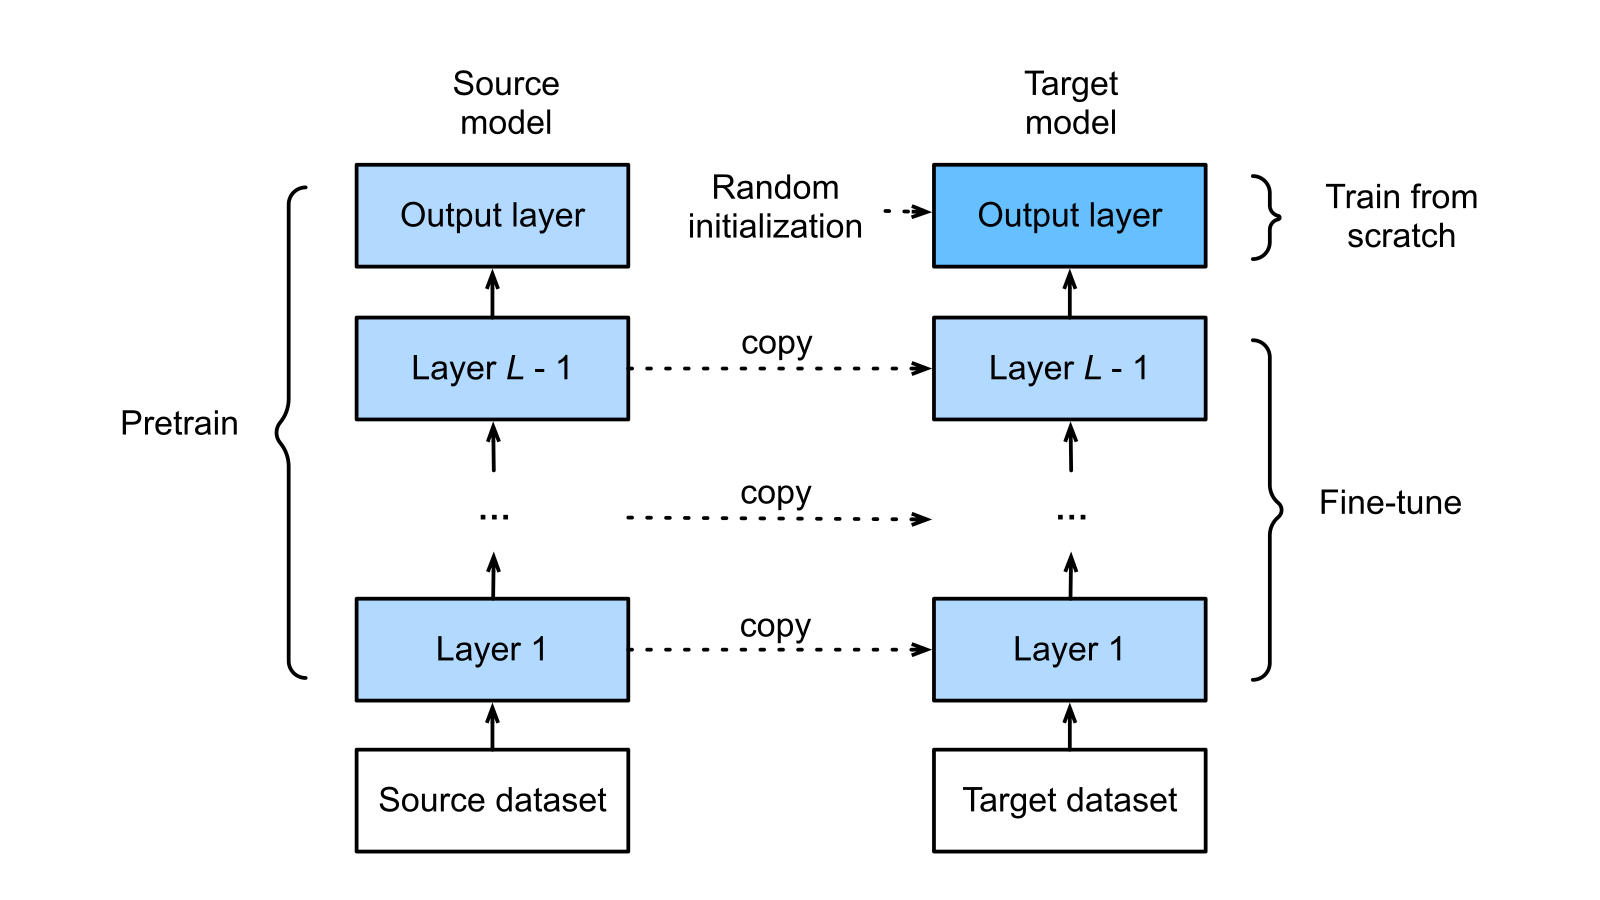
圖1|由下往上讀:來源資料訓練來源模型;虛線把中間層參數複製到目標模型;新輸出層另外初始化,再以目標資料學習。圖中右側標的是微調流程,並沒有比較「全凍結」與「全解凍」的準確率。來源:Aston Zhang、Zachary C. Lipton、Mu Li、Alex Smola,D2L,CC BY-SA 4.0;SVG 轉白底 PNG;手機先保留完整圖,再分別放大來源與目標欄,跨欄的copy關係仍以完整圖為準。手機放大區清除了裁切留下的虛線起點殘片,完整圖保持原樣。
CNN 的中間表示可以把像素轉成供下游辨識使用的特徵。預訓練提供的是一組已經學過的參數起點;這些表示能否幫上忙,取決於來源資料、目標影像和任務有多相容。自然照片的經驗未必能直接處理特殊感測器影像,甚至可能把不適合的偏好帶進來。
把模型拆成兩部分會容易理解:backbone 產生表示,head 把表示映射成新任務的輸出。假設原模型辨識一千類物件,而你只辨識四種零件,新 head 就要輸出四個 logits;不是保留原本一千類的名稱,再期待它自行理解新標籤。
常見做法有三種:
| 起點與更新範圍 | 實際做什麼 | 需要觀察什麼 |
|---|---|---|
| 隨機初始化、從頭訓練 | 表示與分類頭都由目標資料學習 | 資料量、算力與合適基準是否足夠 |
| 預訓練 backbone 凍結,只訓練新 head | 把已有表示當固定輸入 | 表示是否足以區分類別;head 是否真的在更新 |
| 預訓練後微調部分或全部 backbone | 讓既有表示向目標任務調整 | 驗證表現是否改善,是否快速過擬合或破壞原有表示 |
可以先做凍結 backbone 的基準,再試著解凍後段。這是便於比較的起點,不是所有任務的最佳配方。新 head 與舊 backbone 使用不同學習率也是一種選擇,仍需驗證。
D2L 的微調章節以預訓練初始化和隨機初始化比較;其 PyTorch 配方讓微調 backbone 的學習率為 5e-5、新 head 為 5e-4,從頭訓練則使用 5e-4。因此不能把該比較說成只有初始化不同、其餘完全相同,更不能把它改稱凍結與解凍的控制實驗。本篇不重刊該訓練曲線,也不把來源的收益當成你的資料一定會得到的結果。
凍結參數、切換模式、停止梯度,是不同操作
在 PyTorch 裡,最容易誤會的地方,是把「模型沒有更新某些權重」當成「模型的所有狀態都不再變」。BatchNorm 除了可訓練的縮放和平移參數,還有 running_mean、running_var 這類 buffers。
backbone.requires_grad_(False)- 指定模組的參數不再累積新的 autograd 梯度
- 不會自動切換 BatchNorm/Dropout 的模式
model.eval()- 模組改用 evaluation 行為
- 不會自動停止建立梯度圖
with torch.no_grad():- 區塊內一般運算不記錄反向傳播圖
- 不會自動把 train-mode BatchNorm 改成 eval
head.parameters()- 這個 optimizer 只更新 head 參數
- 不會阻止 forward 修改其他 buffers
這裡的 BN 討論以預設 track_running_stats=True 為前提。若特地關掉 running stats,eval 時也可能使用當前 batch 的統計,不能套同一解讀。
文末小程式用一個二維線性層與 BatchNorm 當 backbone,參數由手工指定,沒有預訓練。三筆輸入為 [1,3]、[3,5]、[5,7],線性層設為單位矩陣,所以 BN 看見的 batch mean 是 [3,5]。從零開始,以 momentum 0.1 更新一次後,running mean 變成 [0.3,0.5]。這個變動發生在 forward,與 backbone 的參數是否凍結無關。
實跑得到以下差別:
- 一次 head SGD 更新後,backbone 的八個參數元素保持原值,head 的四個元素有變;BN 的 running mean 同時更新了。
- 切到 eval 後做 backward,head 仍然有梯度,但 BN 的 running mean 不變。這一步沒有再執行 optimizer 更新。
- 切回 train 並包住
no_grad,輸出不帶梯度圖,BN 的 running mean 卻再次更新到[0.57,0.95]。 model.train()後另做backbone.eval(),可以讓 head 保持 train,而 backbone 的 BN 使用已有統計。
若你要固定特徵提取器及其 BN 行為,可以採用最後一種設定。每次呼叫外層 model.train() 都會遞迴切換子模組,所以需要在它之後重新設定 backbone 的模式。若希望 BN 適應新分布,則是另一種策略;它應該是刻意選擇,而不是不知道 buffers 在變。
也別直接對整個模型凍結後,就以為新 head 自動例外。先分清模組,再確認 trainable parameters 與 optimizer 收到的是誰。若在訓練中途改變凍結範圍,也要處理舊梯度和 optimizer 設定;本文的原型是在首次 backward 之前就完成凍結。
資料增強先問:變換之後,原標籤還成立嗎?
資料增強把訓練樣本轉成不同版本,讓模型不必把某個位置、拍攝方向或光線當成必要條件。例如商品仍是同一種商品,但出現在畫面另一側。不過「照片看起來還合理」和「任務標籤仍正確」不是同一件事。
以下圖2至圖10均為 TensorFlow 官方 augmentation 教材既有輸出,左側是同一張原圖,右側是變換後影像。底層鬱金香照片由 Chris Isherwood 拍攝,CC BY 2.0;教材組圖為 CC BY 4.0。它們用來看操作造成的變化,不是本站實驗,也不是增強有效性的評分圖。手機版先保留左右對照,再將兩個原面板上下放大;原有座標與色條保留。
圖2|flip_left_right 交換左右方向。原圖右側的大花移到左側,可用來觀察構圖改變。花種分類可能容許此變換;如果任務辨識文字、左右手或方向標誌,標籤就未必能原封不動沿用。來源:TensorFlow;照片 Chris Isherwood,授權如本節及文末。
圖3|rot90 做的是直角旋轉,右圖花莖與畫面方向都改變,高寬互換。這張圖不代表任意角度的旋轉都不會裁切,也不代表具有重力方向意義的任務適合大幅旋轉。來源:TensorFlow;照片 Chris Isherwood。
水平翻轉可以不改變花種,卻會改變「向左箭頭」的意義。旋轉一張數字影像也可能讓原類別變得不明確。挑選增強時,應先描述部署時真的可能遇到什麼變化,再看變換後的影像是否仍能由人可靠標註。
對物件偵測或分割,還多了一個位置問題:影像翻轉時,box 或 mask 必須做對應的幾何變換。分別隨機抽一次影像與 mask 的裁切位置,會把監督訊號對錯地方。文末只檢查一個固定的數字影像/mask 同步水平翻轉,沒有實作完整隨機分割 pipeline。
色彩與裁切會拿走哪些辨識線索?
圖4|來源程式先用 rgb_to_grayscale 轉成單通道,再以 Matplotlib 預設色盤顯示,所以右側看起來是藍綠黃的偽彩色,並附亮度值色條;它不是新增了這些真實花瓣顏色,也不是肉眼黑白顯示。顏色差異被壓成單一強度後,依賴顏色的分類線索可能減少。來源:TensorFlow;照片 Chris Isherwood。
圖5|來源以 adjust_saturation(image, 3) 增加飽和度。右側紅花與綠色背景的色彩更強烈。這是操作示例,因子3並不是建議所有資料集採用的預設值。來源:TensorFlow;照片 Chris Isherwood。
圖6|來源呼叫 adjust_brightness(image, 0.4);右側整體變亮,部分亮部更難區分。這個參數是 API 的亮度增量,不是「準確率提升40%」,也不是把亮度乘1.4。實作時需同時核對像素 dtype、數值範圍與裁切規則。來源:TensorFlow;照片 Chris Isherwood。
同一個變換,在不同任務中的價值可能相反。若你依花形分類,可以考慮讓模型不要過度依賴拍攝光線;若要估計水果成熟度或辨識色碼,色彩本身可能就是目標證據。灰階化或過強的 color jitter 可能把答案一起消掉。
裁切則改變模型可以看見的內容。它可能減少背景依賴,也可能把主體裁走。應抽看實際輸出,而不是只看 transform 的名字。
圖7|central_crop(..., central_fraction=0.5) 保留高與寬的中央部分,右圖座標範圍較小。這裡的0.5不是保留一半面積;高寬各取一半時,面積約為四分之一,實際像素邊界另有取整。來源:TensorFlow;照片 Chris Isherwood。
圖8|來源使用 stateless_random_crop,輸出大小為 [210,300,3],本圖保留較局部的視野。它與固定從正中央裁切不同;同一輸入與 seed 可重現同一結果。這是來源迴圈的一個既有輸出,不是三個 seed 的拼圖,也沒有展示裁掉主體時的完整失敗分布。來源:TensorFlow;照片 Chris Isherwood。
如果資料中每張圖只標「有某種物件」,裁切後該物件可能已不在視野,卻仍保留原標籤。這時要限制 crop、同步檢查標註,或重新設計任務,不應用「資料增強通常有效」跳過標籤問題。
隨機增強要能追查,驗證流程則要固定
圖9|來源以 stateless_random_brightness、max_delta=0.95 示範隨機亮度;所選輸出明顯變暗,花朵細節更難看清。這提醒我們檢查取樣強度,不能把 API 示範範圍直接視為訓練建議。來源:TensorFlow;照片 Chris Isherwood。
圖10|來源使用 stateless_random_contrast、lower=0.1、upper=0.9;右圖的明暗差異變小。這個範圍不包含大於1的增強對比,也不是在說「對比越低模型越好」。來源:TensorFlow;照片 Chris Isherwood。
Stateless 操作把 seed 當成輸入;對相同輸入、相同參數和 seed,可得到可重複的該次變換。這有助於重現某張失敗影像,但如果每筆、每輪都固定使用同一個 seed,也可能讓你一直看見相同變化。資料順序、每個樣本的 seed、epoch 與使用的版本,都應納入可重現設計;一個 seed 不能替整個訓練系統保證跨設備逐位相同。
一般訓練比較可以這樣安排:
- 先以原始個體切分訓練、驗證與測試;同一物件的連拍、同一病患或同一影片片段,依任務分組,避免近似資料跨集合。
- 對訓練集產生隨機增強。若預先輸出多個版本,也要讓同一原始樣本的所有版本留在同一個 split。
- 驗證與測試使用固定的必要預處理,例如縮放、中心裁切與權重要求的正規化。必要預處理不等於每次抽樣的隨機增強。
- 在同一切分、評估指標與相近訓練預算下,比較無增強、單一增強和適合任務的組合。先看驗證結果與錯誤切片,選定配方後才做測試評估。
有些方法會使用 test-time augmentation,將事先定義的多個視角預測合併。那是另一個需要固定、公開並計算額外推論成本的評估方案,不能與單視角結果混在一起比較。本文未實測它。
增強後的照片張數也不等於獨立樣本數。把一百張圖各做十種變換,沒有變成來自一千次獨立拍攝的資料;它仍然無法補齊沒有出現過的材質、設備與人群。若原始覆蓋不足,增強只是改變既有內容,仍需要補資料。
輕量 CNN 怎麼把空間濾波與通道混合拆開?
先回到一般卷積。一個輸出通道的某個位置,會把所有輸入通道對應區域的乘積加總。它同時處理「鄰近位置」與「不同通道」的訊息。
圖11|這是一般的全通道卷積:輸入為 1×3×6×6,kernel 為 1×3×3×3,無 padding、stride1 的輸出為 1×1×4×4。三個通道一起產生同一個輸出位置。它不是 depthwise 卷積。來源:dvgodoy,Deep Learning Visuals,CC BY 4.0。
圖12|同一計算展開後,紅、綠、藍三個通道的乘積和分別是18、13、8,最後加成39。這三個中間值不是三張獨立輸出通道的最終結果。來源:dvgodoy,CC BY 4.0;本圖對應上一張圖左上輸出格。
MobileNet V1 使用的 depthwise separable convolution 把事情分成兩步。先以 depthwise 做各通道自己的空間濾波,再以 pointwise 做通道組合。
以 depth multiplier 為1的情況來說,若輸入有 M 個通道,depthwise 有 M 個 K×K kernel,每個只看自己的輸入通道,產生 M 個結果;這一步不把不同通道相加成一個新通道。接下來用 N 組 1×1×M 權重,將每個位置的 M 個值混合成 N 個輸出通道。
圖13|pointwise 的「1×1」只說空間範圍是一個位置,並不是只看一個通道。圖中每個 filter 都有三個通道權重;兩組 filter 把三通道變成兩通道,空間仍為6×6。這張圖說明通道混合,沒有畫出前置的 depthwise 階段。來源:dvgodoy,CC BY 4.0。
圖14|同一位置是 [5,0,4]:第一組算 5×(-1)+0×2+4×0=-5,第二組算 5×2+0×0+4×(-2)=2。所以1×1卷積可以混合與改變通道數,即使不跨鄰近位置。來源:dvgodoy,CC BY 4.0;透明背景以白底顯示。
圖11至圖14的手機版先呈現完整運算,再依原面板或算式放大;分區只是閱讀輔助,跨區關係以完整圖為準。這裡用既有數字圖分別看一般卷積和 pointwise,depthwise 的連接關係則由前述通道說明與下面程式核對。不要把圖11中沿三個通道加總的算子改稱 depthwise:正是拿掉這個階段的跨通道混合,才需要後續 pointwise 補上。
令輸入通道為 M、輸出通道為 N、kernel 邊長為 K,輸出空間為 Hout×Wout,只計無 bias 的 kernel 權重,且 depth multiplier 為1:
| 算子 | kernel 權重數 | 單筆樣本的稠密邏輯 MAC 數 |
|---|---|---|
| 一般 K×K 卷積 | K²MN | Hout×Wout×K²MN |
| depthwise K×K | K²M | Hout×Wout×K²M |
| 接續 pointwise 1×1 | MN | Hout×Wout×MN |
| 後兩者合計 | K²M+MN | Hout×Wout×(K²M+MN) |
MAC 是一次乘法及累加的計數口徑。若換成 FLOPs,要先說清楚一個 MAC 算一個還是兩個浮點運算。上表不含 bias、BN 的可訓練參數、activation、資料搬移與其他層成本;也不是硬體實際執行指令的量測。
把 M=3、N=4、K=3 代入,一般卷積有108個 kernel 權重,分離後有 27+12=39 個。若輸出是5×5,對應邏輯 MAC 為2700與975。這只支持這兩個算子的理論計數,沒有證明整個模型少相同比例的記憶體或端到端延遲。
也別把「可代換架構位置」當成「任意權重都能無損分解」。在無非線性的 multiplier1 分離層裡,固定一個輸入通道時,所有輸出通道的空間 kernel 都是同一張 depthwise kernel 的倍數;一般卷積沒有這個限制。文末程式特地先構造一個能如此分解的 full kernel,檢查兩條路輸出一致,並未證明任意卷積可以這樣還原。
MobileNet V1 與 V2:省計算以外,還要照顧表示
MobileNet V1 是2017年的架構,主要積木是 depthwise 加 pointwise;原始模型在這些卷積後還包含 BN 與 ReLU,並不是本文為算式核對所用的純線性兩層。縮小通道寬度與降低影像解析度也能降低計算,但可能一併減少辨識所需資訊。
2018年的 MobileNet V2 進一步討論倒置殘差與線性瓶頸。其一般 bottleneck block 可以用下表讀,具體通道、stride 與是否有 shortcut 仍依每個 block 而定:
- 先把窄輸入擴到較寬的通道空間
- 擴張階段可使用 ReLU6;並非一開始就把所有通道壓小
- 在擴張通道中各自做空間濾波
- 此階段也可使用 ReLU6,stride 可用來降採樣
- 投影回較窄的 bottleneck
- 末端不再加 ReLU 類非線性,以減少窄表示被截斷的問題
- 連接窄的輸入與輸出
- 一般需 stride1 且輸入輸出形狀相容;不是每個 block 都相加
「線性瓶頸」不是整個 block 都沒有 activation;「倒置」也不是把資料流倒過來。它描述的是先窄、內部擴張、再回窄,以及 shortcut 連接窄端的安排。擴張倍率為1的特殊 block 可以省略前面的擴張層,不宜把表格當成每一層都完全相同的施工圖。
若最終要挑設備上的模型,先比較實際任務表現,再在目標硬體與推論後端量測相同 batch、解析度和精度設定下的延遲、記憶體與模型大小。depthwise 的 MAC 少,實際速度仍受 kernel 實作、記憶體存取與後端支援影響。本文沒有提供此類 benchmark。
預訓練權重也帶著輸入約定
架構名稱一樣,不代表不同框架的權重能共用同一套像素處理。把預處理混用,可能讓輸入偏離預訓練時的分布。
本篇依 PyTorch 2.3、Torchvision 0.18 與 TensorFlow 文件標示的2.16.1版本核對以下例子;這是文件約定,不是本站跑過的模型輸入測試:
MobileNet_V2_Weights.IMAGENET1K_V1[0,1],再依 ImageNet mean/std 正規化MobileNet_V2_Weights.IMAGENET1K_V2preprocess_input[0,255] 的像素輸入縮放到 [-1,1]這裡 Torchvision 的 mean 為 [0.485,0.456,0.406]、std 為 [0.229,0.224,0.225]。權重枚舉裡的 V1、V2 是同一 MobileNetV2 架構的不同權重配方,不是 MobileNet V1 與 MobileNet V2 兩種架構。
實作時,先選定模型與權重,再依它的 transforms 或 preprocess 文件接上資料。訓練時可另外設計隨機 crop 等增強,但像素尺度與正規化仍要相容。不要先做 Keras 的 [-1,1] 縮放,又不加判斷地接上另一套 [0,1] 的 mean/std 流程。
用一個小程式核對容易混淆的行為
以下程式的實際執行環境為 Python3.10.12、torch 2.3.1+cu118,運算使用 CPU、float64;名稱含 cu118 不表示這次用了 GPU。安裝相容的 PyTorch2.3.1 環境後,將程式存為 transfer_checks.py,執行 python transfer_checks.py。不需下載權重或照片。
成功時程式應完成所有 assert,印出凍結參數數量8、head參數數量4、BN running mean 的兩次變化,以及卷積權重108對39、邏輯 MAC2700對975。head 只做一次 SGD 更新;eval 段另外檢查梯度、沒有第二次更新。影像與 mask 是小型數字矩陣;卷積也是手設參數,不是從資料學到的濾波器。
import torch
from torch import nn
from torch.nn import functional as F

print(f"torch={torch.__version__} device=cpu dtype=float64")
backbone = nn.Sequential(nn.Linear(2, 2, bias=False), nn.BatchNorm1d(2, momentum=.1)).double()
head = nn.Linear(2, 2, bias=False).double()
with torch.no_grad():
    backbone[0].weight.copy_(torch.eye(2, dtype=torch.float64))
    head.weight.copy_(torch.tensor([[.5, -.25], [-.5, .25]], dtype=torch.float64))
backbone.requires_grad_(False)
model = nn.Sequential(backbone, head)
X = torch.tensor([[1., 3.], [3., 5.], [5., 7.]], dtype=torch.float64)
labels = torch.tensor([0, 1, 1])
old_parameters = {n: p.detach().clone() for n, p in backbone.named_parameters()}
old_head = head.weight.detach().clone()
optimizer = torch.optim.SGD(head.parameters(), lr=.1)
model.train()
optimizer.zero_grad(set_to_none=True)
F.cross_entropy(model(X), labels).backward()
assert all(p.grad is None for p in backbone.parameters())
assert head.weight.grad is not None and torch.count_nonzero(head.weight.grad) > 0
optimizer.step()
assert all(torch.equal(p, old_parameters[n]) for n, p in backbone.named_parameters())
assert not torch.equal(head.weight, old_head)
assert torch.allclose(backbone[1].running_mean, torch.tensor([.3, .5], dtype=torch.float64))

def rounded(tensor):
    return [round(float(v), 8) for v in tensor.detach().flatten()]

print(f"frozen_parameter_elements={sum(p.numel() for p in backbone.parameters())} trainable_head_elements={sum(p.numel() for p in head.parameters())} backbone_parameters_unchanged=True head_one_step_updated=True BN_running_mean={rounded(backbone[1].running_mean)}")
# eval changes module behavior but does not disable gradient recording.
model.eval()
old_mean = backbone[1].running_mean.clone()
optimizer.zero_grad(set_to_none=True)
F.cross_entropy(model(X), labels).backward()
assert head.weight.grad is not None and torch.count_nonzero(head.weight.grad) > 0
assert torch.equal(old_mean, backbone[1].running_mean)
print("eval_mode_head_gradient_recorded=True BN_running_mean_unchanged=True")
# no_grad does not switch a training BatchNorm module into inference behavior.
model.train()
optimizer.zero_grad(set_to_none=True)
with torch.no_grad():
    prediction = model(X)
assert not prediction.requires_grad and head.weight.grad is None
assert torch.allclose(backbone[1].running_mean, torch.tensor([.57, .95], dtype=torch.float64))
print(f"train_with_no_grad_output_requires_grad={prediction.requires_grad} BN_running_mean={rounded(backbone[1].running_mean)}")
# A frozen feature extractor can be put in eval while its new head stays in train.
model.train()
backbone.eval()
old_mean = backbone[1].running_mean.clone()
with torch.no_grad():
    model(X)
assert not backbone.training and head.training
assert torch.equal(old_mean, backbone[1].running_mean)
print("feature_extractor_eval=True head_train=True BN_running_mean_unchanged=True")

# Fixed geometric transform on a tiny numeric image and its paired mask.
image = torch.tensor([[1, 2, 3], [4, 5, 6]])
mask = torch.tensor([[0, 1, 1], [0, 0, 1]])
flipped_image, flipped_mask = image.flip(-1), mask.flip(-1)
assert torch.equal(flipped_image, torch.tensor([[3, 2, 1], [6, 5, 4]]))
assert torch.equal(flipped_mask, torch.tensor([[1, 1, 0], [1, 0, 0]]))
print(f"fixed_paired_horizontal_flip image={flipped_image.tolist()} mask={flipped_mask.tolist()}")

# Multiplier-one depthwise + pointwise, no activation, BN or bias.
depthwise = nn.Conv2d(3, 3, 3, padding=1, groups=3, bias=False).double()
pointwise = nn.Conv2d(3, 4, 1, bias=False).double()
with torch.no_grad():
    depthwise.weight.copy_(torch.arange(1., 28., dtype=torch.float64).reshape(3, 1, 3, 3))
    pointwise.weight.copy_(torch.tensor([[1., 0., 0.], [0., 1., 0.], [0., 0., 1.], [1., -1., 2.]], dtype=torch.float64)[:, :, None, None])
u = torch.arange(1., 76., dtype=torch.float64).reshape(1, 3, 5, 5)
with torch.no_grad():
    separated = pointwise(depthwise(u))
    # This particular full kernel is factorized by construction.
    full_weight = pointwise.weight[:, :, 0, 0, None, None] * depthwise.weight[:, 0][None]
    direct = F.conv2d(u, full_weight, padding=1)
assert torch.equal(separated, direct)
standard_count = 3 * 4 * 3 * 3
separable_count = sum(p.numel() for p in depthwise.parameters()) + sum(p.numel() for p in pointwise.parameters())
assert standard_count == 108 and separable_count == 39
assert list(separated.shape) == [1, 4, 5, 5]
print(f"depthwise_weight_shape={list(depthwise.weight.shape)} pointwise_weight_shape={list(pointwise.weight.shape)} output_shape={list(separated.shape)}")
print(f"no_bias_convolution_weights standard={standard_count} separable={separable_count} dense_logical_MACs_per_sample={standard_count*25}_vs_{separable_count*25} constructed_factorized_full_kernel_output_matches=True")
print("scope=hand-set CPU toy-backbone/head one SGD step, BatchNorm buffers and mode/gradient checks, fixed paired flip, multiplier-one depthwise/pointwise counts and one constructed factorization; no pretrained weights, real-image training, stochastic augmentation pipeline, general kernel equivalence, accuracy, latency or GPU benchmark")
這個核對能幫你抓住機制,卻不能替代真實影像的驗證。開始實際任務時,先檢查切分與標籤,再固定權重及預處理、建立凍結基準;一次改變一個有理由的增強或解凍策略。等分類品質達到需求,再量測部署成本,才知道該優先補資料、調表示,還是換算子與推論後端。
來源與圖片署名
本文重新組織教學順序,加入凍結/模式對照、標籤失效例、固定同步翻轉與手設卷積核對。教材花朵圖均為來源輸出,沒有把它們當成本次程式產物;本篇也沒有新增模型準確率、遷移收益或硬體加速實測。
- D2L:Fine-Tuning、Image Augmentation。圖1作者為 Aston Zhang、Zachary C. Lipton、Mu Li、Alex Smola,採 CC BY-SA 4.0;本站將原 SVG 轉為白底 PNG,封面等比縮放加白邊,相關圖像改作沿用同一授權。D2L 原文完整閱讀範圍與未採照片/曲線的原因記於素材筆記。
- 圖2至圖10:TensorFlow Data Augmentation,教材組圖 CC BY 4.0;所用鬱金香原照片作者 Chris Isherwood,Flickr 原作,依官方花卉資料集所附逐檔聲明採 CC BY 2.0。教材已對照片作翻轉、旋轉、灰階、色彩及裁切變換;本站重刊既有輸出,保留原數值、色盤與對照內容。頁面通用授權沒有取代底層照片的署名。
- 圖11至圖14:dvgodoy,Deep Learning Visuals — Convolutions,原刊於 Deep Learning with PyTorch Step-by-Step: A Beginner's Guide;採 CC BY 4.0。本站保留數字與運算關係,必要時白底顯示、加入供手機閱讀的原面板重排;未把它們改稱 MobileNet 論文圖。
- Howard 等人:MobileNets,2017,主要對照§3.1–3.3的算子、成本與寬度乘數;Sandler 等人:MobileNetV2,CVPR2018,主要對照§3.1–3.3與表1。原論文圖僅連結,未在本站重刊。
- PyTorch2.3:Autograd mechanics、BatchNorm;Torchvision0.18:MobileNetV2 權重與 transforms、Mask 與 TVTensors。文件用來核對梯度、模式、buffers 及標註處理,完整隨機分割 pipeline 未實測。
- TensorFlow:Keras MobileNetV2、preprocess_input。這些來源支持的是所列版本的輸入約定,不能外推為所有預訓練模型的通用規則。
留言0
登入後就能留言。
登入