
有一批客服訊息,要分成產品問題、付款問題與服務問題。如果直接把中文句子交給傳統分類器,它不會自動知道「退費」和「退款」的關係,也不會自行決定哪些字比較重要。你得先定義:一份文件要變成什麼數字,這些數字保留了哪些資訊。
在大型語言模型普及以前,常見的一條路是先切出文字片段,建立詞彙表,計算每份文件有哪些詞,再用 TF-IDF 調整權重。這些方法也能用於文件檢索、分群與分類的基準實驗;它們沒有完整語言理解,卻讓我們能直接檢查每個維度代表什麼。
這篇要做的是把「文字變向量」拆開,讓你能核對每一步。 後半會用四份人工文件實跑向量化、相似度與一次小型分類 fit/predict。它不是大型語料測試,不以這四份資料宣稱分類準確率或中文斷詞品質。
先決定 token:一個字、一個詞,還是一段字元?
Token 是你決定拿來處理的文字單位。它可以是一個詞、一個字元,也可以是一段子詞;不是任何 tokenizer 的輸出都等於自然語言中的「詞」。
英文常以空白和標點作為切分線索,中文卻不能只靠空白。拿「資料科學很好用」來說,可以依事先規定切成「資料科學/很/好用」,也可以改成相鄰字元片段;這是不同的特徵定義。
scikit-learn 的預設 CountVectorizer 並不是中文語義斷詞器。它預設找至少兩個連續的 Unicode word 字元,這類字元包含文字、數字及底線。它既不是只認英文字母,也不會替你找到中文詞義邊界。
- 只留下「資料」「科學」
- 獨立的單字元「我」「愛」被略過
- 整串是一個 token
- 不是自動切成四個詞
tokenizer=str.split, token_pattern=None- 使用已放好的空白邊界
str.split本身不會做中文語義斷詞;word analyzer 的其他步驟仍在
analyzer='char', ngram_range=(2,2) 處理「資料科學」- 「資料」「料科」「科學」
- 是三個字元片段,不代表三個語義詞
本篇的小例子已經人工用空白標出詞界,目的是讓計數可以手算;沒有偷偷把人工切好的結果當成分詞模型的能力。實際應用要選擇合適的中文斷詞方式、字典和專有名詞規則,再檢查真實訊息。
也要留意否定詞。如果你先把句子切成「我/不/喜歡」,再套用會刪單字元的預設規則,「不」可能消失,意思卻完全不同。停用詞、大小寫、標點和編碼處理都應依任務決定,不是刪得越多越乾淨。
n-gram 增加局部順序,不會把整句語意找回來
假設斷詞結果是 我/喜歡/你。Unigram 是單一 token;bigram 是相鄰兩個 token;trigram 則是相鄰三個。
ngram_range=(1,1)ngram_range=(2,2)ngram_range=(1,2)「我 喜歡 你」和「你 喜歡 我」的 unigram 計數相同,因為三個詞都出現一次。加上 bigram,這兩句可以有不同向量,因為「我 喜歡」和「你 喜歡」是不同特徵。
但這不表示 bigram 已完整保留句子。「甲 乙 甲 丙 甲」與「甲 丙 甲 乙 甲」仍有相同的 unigram 與 bigram 計數;片段的整體安排已經不同,袋狀表示卻可能一樣。它保留的是有限局部資訊,不是完整語法或推理能力。
這裡的「相鄰」也要看處理順序。若先刪停用詞,原本隔開的兩個 token 可能在處理後相鄰。scikit-learn 的 word n-grams 是根據這條處理後序列建立,而不是保證原始字串的位置完全相連。
使用自訂函式時,tokenizer=str.split 和 analyzer=str.split 也不同。前者只換掉斷詞,仍可以做 word n-grams;後者接管整個 analyzer,不能再期待 ngram_range=(1,2) 自動幫你加入 bigram。相關設定可對照 CountVectorizer 文件。
BoW:一列是一份文件,一欄是一個特徵
Bag of Words,簡稱 BoW,把每份文件看成詞的集合或計數。只用 unigram 時,同樣的詞出現同樣次數,就會得到同樣向量,原始排列順序不再保留。
先用四份本文手寫文件來看可以逐格核對的版本:
D0:模型 好用 好用 推薦
D1:模型 便宜 推薦
D2:服務 好用 快速 推薦
D3:服務 便宜 推薦
本次學到的詞彙表順序是 便宜、好用、快速、推薦、服務、模型。對這份小資料,計數矩陣如下:
- 0
- 2
- 0
- 1
- 0
- 1
- 1
- 0
- 0
- 1
- 0
- 1
- 0
- 1
- 1
- 1
- 1
- 0
- 1
- 0
- 0
- 1
- 1
- 0
「好用」在 D0 出現兩次,因此是 2。沒有出現的詞是 0,不需要為每份文件重新建立一套欄位。四份文件共用相同六欄,模型才知道第幾個位置代表同一個特徵。
詞彙表中的整數索引只負責定位欄位,不是詞頻排名、重要性或語意大小。本例的特徵名由工具排序輸出;使用自己指定的詞彙表,也可以安排不同索引。不能因「模型」在第六欄,就認為它比第一欄重要。
如果只關心有沒有出現,可以把非零計數改為 1,得到 binary presence。那是一份文件可能同時有很多個 1 的表示,不能和「整個向量只有一個 1」的嚴格 one-hot 混為一談。
多數位置用不到,為什麼還要保留那麼多欄?
如果訓練語料總共出現五萬個不同特徵,每份短訊息卻只用到其中幾十個,那份訊息的向量就會有大量的 0。欄位多是為了讓不同文件能在同一個特徵空間比較,不代表每份文件都要出現所有詞。
稀疏矩陣讓我們儲存非零值及其位置資訊,而不是每次把所有零格都展開。CountVectorizer 的輸出就是稀疏矩陣,能供支援這種格式的模型使用;不需要一看到 sparse 就先 .toarray()。
本文只有 4×6,為了教學可以印完整矩陣;這 24 格中有 13 個非零,不能拿它當大型文字資料的稀疏比例。若是十萬份文件、五萬個特徵,完整展開就有 50 億格,僅 float64 數值便約 400 億位元組,還不含其他物件開銷。這時為了「看一眼資料」直接轉成 dense,可能比訓練本身更早耗盡記憶體。
實際需要保存的也不只有數值:斷詞規則、詞彙表、欄位順序與後續權重都要一起保存。換了詞表後仍拿舊分類器使用,即使形狀碰巧相同,各欄的意義也可能已經錯位。
TF-IDF:把單篇詞頻和跨文件普遍程度分開
在四份文件中,「推薦」每篇都有;「快速」只出現在 D2。它們對區分文件的作用可能不同。TF-IDF 的想法是結合兩種統計:一個詞在這份文件出現多少,以及它在整份訓練語料中有多普遍。
先分清兩個量:
- TF,term frequency:這裡採該詞在單篇文件的原始出現次數。
- DF,document frequency:訓練語料中有幾份文件出現這個詞。同一份文件出現十次,DF 仍只加一。
本篇按照 scikit-learn 的預設平滑公式,用自然對數計算:
IDF(t) = ln((1 + N) / (1 + DF(t))) + 1
未正規化權重(t,d) = TF(t,d) × IDF(t)
N 是訓練文件數,本例是 4。這個公式有兩種不同位置的加一:分子、分母的平滑,以及對數外側的加一。 在所有訓練文件出現的詞,IDF 是 1,不是 0。
| 詞 | 訓練 DF | 本例平滑 IDF,取到小數點後 6 位 |
|---|---|---|
| 便宜 | 2 | 1.510826 |
| 好用 | 2 | 1.510826 |
| 快速 | 1 | 1.916291 |
| 推薦 | 4 | 1.000000 |
| 服務 | 2 | 1.510826 |
| 模型 | 2 | 1.510826 |
「好用」在 D0 出現兩次,所以未正規化權重是 2×1.5108256≈3.0216512;「推薦」是 1×1=1。高 IDF 代表在這份訓練語料較少見,不代表比較正確、有價值或有助分類;錯字、流水號或個人識別資訊也可能很少見。
TF-IDF 沒有一個所有工具都相同的公式。有些教材用 ln(N/DF),有些先把 TF 除以文件長度;那不是本例採用的中間量。scikit-learn 設 smooth_idf=False 後,公式變成 ln(N/DF)+1,外側加一仍在,不能把它誤解成完全沒有加一。
此外,sublinear_tf=True 是把正計數換成 1+ln(TF),不是 ln(1+TF);隱含的零格仍為零。D0 的「好用」改用這個選項後,未正規化權重約為 2.55805015,與原始 TF 的 3.02165125 不同。
預設還有最後一步:逐份文件做 L2 正規化。把該列每個權重除以整列的歐氏長度,非零列的平方和就成為 1;這不是讓數值總和等於 1。
以 D0 的三個非零欄位,依「好用/推薦/模型」排列:
計數:           [2,          1,          1         ]
乘上 IDF:      [3.02165125, 1.00000000, 1.51082562]
除以 L2 長度:  [0.85764287, 0.28383251, 0.42882143]
因此要比較數字時,必須確認看到的是計數、IDF、本篇未正規化權重,還是最後的 normalized TF-IDF。它們分屬不同步驟。公式與參數可查 TfidfTransformer;直接從文字走完這條流程則可用 TfidfVectorizer。
變成向量後,可以用什麼方式比較文件?
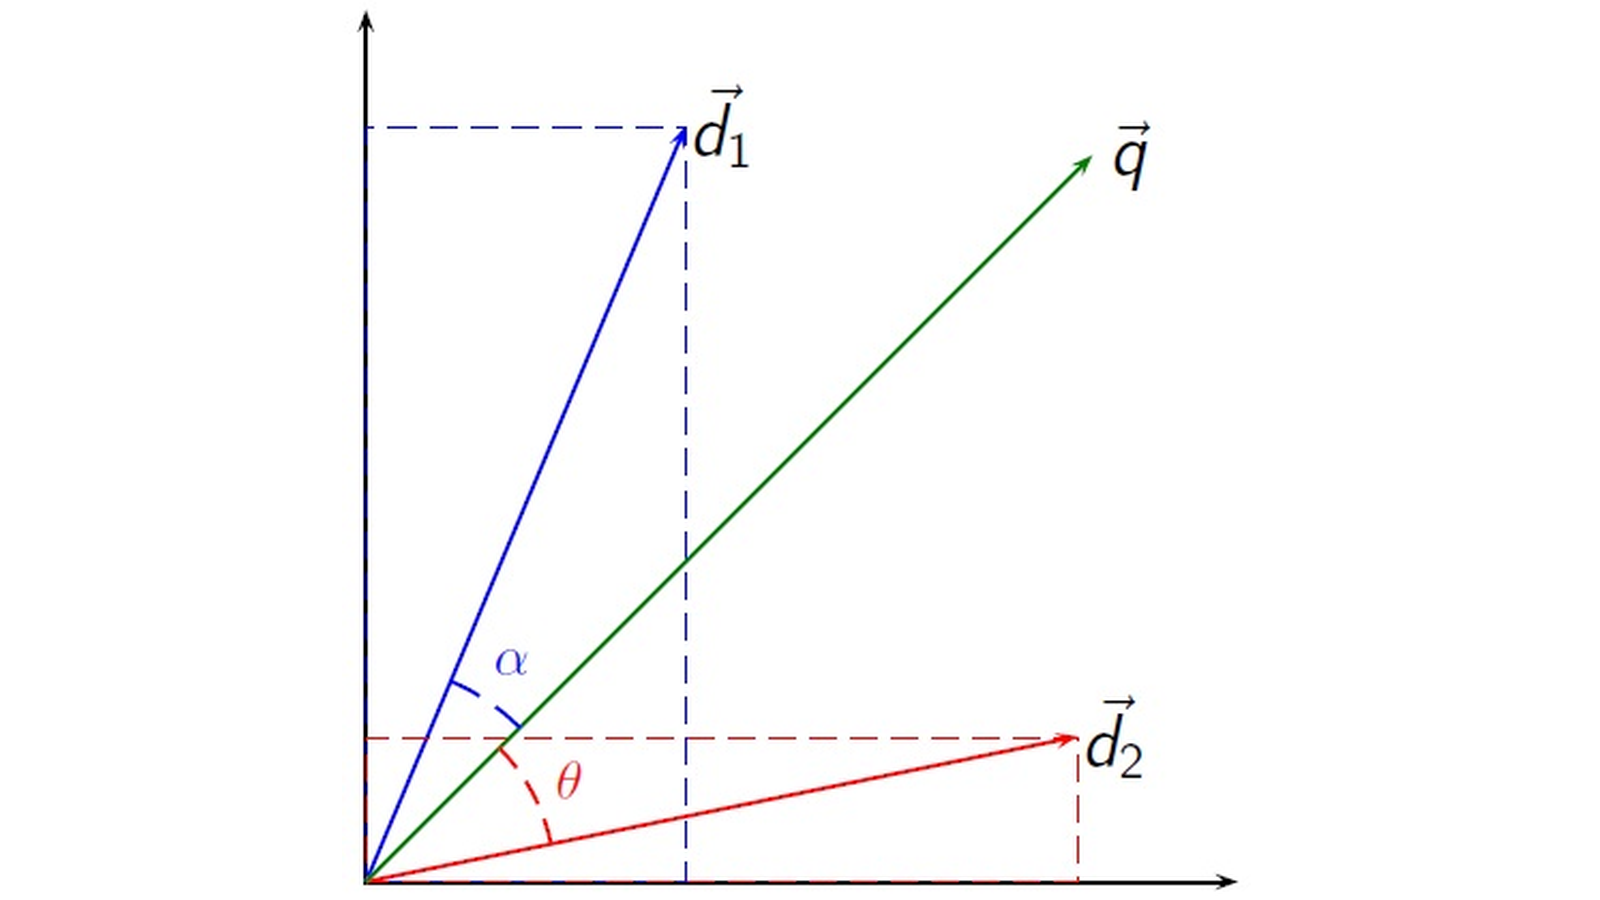
對兩個非零向量,餘弦相似度是點積除以兩邊的長度。如果兩邊都已做 L2 正規化,分母就是 1,可以直接用點積。這讓我們能比較查詢和文件在這套詞彙特徵中的方向。
本文把查詢「好用 模型」轉成相同的 TF-IDF 空間,與 D0–D3 的餘弦相似度依序約為 0.909668、0.452855、0.351500、0,D0 最高。這是本次小例實際計算,不是搜尋系統品質測試;0.91 也不是「有 91% 機率是正確答案」。
限制很直接:若查詢全是訓練時未出現的詞,例如「神奇 新品」,本例輸出會是六欄全零,沒有新增「神奇」那一欄。零向量沒有一般非零餘弦公式所需的分母,應另外判斷,不能把它當成一份已充分理解的新內容。
即使分類器仍對全零向量給出類別,也可能只是截距等既有參數的結果。對「退款」和「退費」這樣的不同詞形,純詞彙重疊未必能連起來;對同一個詞的不同意思,這套表示也不會自動依上下文變成不同詞義向量。
詞彙表和 IDF 也會洩漏,不能只把分類器分開訓練
如果目的是估計對未知文件的泛化,應先切分資料,再只用訓練區 fit 詞彙表與 IDF。驗證和測試資料使用已學好的規則 transform,不是在各集合重新建不同詞表,也不是先對全部資料 fit_transform 才切分分類器輸入。
為什麼不使用標籤也可能洩漏?本篇故意做一個錯誤版本:把保留的「神奇 新品」和四份訓練文件一起拿來 fit。這時訓練文件數從 4 變成 5,詞表加入兩個新詞;「推薦」仍只在四份出現,但 IDF 從 1 變成 ln(6/5)+1≈1.18232156。保留資料已改變特徵,不需要讀到它的標籤。
這個對照證明的是「統計量會被改變」,沒有測出準確率一定上升多少。如果任務本來就允許使用指定的未標註語料,那需要另行定義評估情境,不能把不同設定的成績混在一起比較。
也要一起控制重複訊息、同一客戶、同一對話與時間關係。把同一封罐頭訊息的近似版本隨機分到兩邊,模型可能是在辨認模板。切分方法應跟未來會遇到的新資料相符,可回看本系列的資料洩漏與切分。
先做可檢查的 Pipeline,再調整特徵範圍
Pipeline 可以把向量化和分類器放在同一條 fit/predict 流程。本文實際執行四份人工文件的 TF-IDF+Logistic Regression;「模型 神奇」得到「產品」類別,其中「模型」是已知詞,「神奇」仍被略過。這不等於模型學懂了「神奇」,也不是測試集準確率。
如果做交叉驗證,則把整條 Pipeline 交給交叉驗證工具,讓每個 fold 只在該 fold 的訓練區 fit 詞彙表、IDF 及分類器。先全資料建好詞表,再只對最後分類器做交叉驗證,仍有相同的問題。本篇不另宣稱執行過 CV,相關原則可對照 scikit-learn 的 Common pitfalls。
想調整詞彙大小時,可以先理解幾個參數:
| 參數 | 實際控制什麼? | 本例的可檢查結果 |
|---|---|---|
min_df=2 | 至少出現在兩份訓練文件 | 排除只在 D2 出現的「快速」 |
max_df=0.75 | 排除出現在超過 75% 訓練文件的詞 | 四份訓練文件都有的「推薦」被排除 |
| 兩者合用 | 保留 DF 介於 2 和 3,包含邊界 | 留下便宜、好用、服務、模型 |
max_df=1,整數 | 最多出現在一份文件 | 本例只留下「快速」 |
max_df=1.0,浮點數 | 最多出現在 100% 文件 | 本例保留六個詞 |
DF 是文件數,不是單篇出現次數;整數與浮點比例也不是同一種設定。N-gram 範圍越大,可能增加有用片段,也可能增加大量罕見片段。這些選擇應以驗證資料判斷,不能用某篇文章的固定維度或比例當成通則。
Pipeline 能管理它內部的訓練步驟,不能修復你在外部已用全部資料學好的詞表、洩漏的標註,或不合適的切分。實驗紀錄仍要保留這些前提。
用一支程式走過完整的小例子
下列程式已在 Python 3.10.12、NumPy 1.26.3、SciPy 1.14.0、scikit-learn 1.5.1/CPU 執行。文中參照的官方 /1.5/ 文件顯示 1.5.2;本例相關核心方法已另與 1.5.1 來源核對,不把文件版本冒稱為實跑版本,也不宣稱這是最新版本。
四份文件和標籤全在程式內,沒有下載語料或預訓練模型。空白是人工設定的邊界;分類器只在四個人工例子上 fit,目的是確認操作串接,而不是比較模型效果。
把完整程式存成 text_vectorization_checks.py 後,執行 python3 text_vectorization_checks.py。如果需要獨立環境,以下是 WSL/Linux 的準備方式;下載安裝並未在本次重新執行,實際驗證使用前述已有環境:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install numpy==1.26.3 scipy==1.14.0 scikit-learn==1.5.1
python text_vectorization_checks.py
"""Hand-written text examples, not a real-world classification benchmark.

Executed with Python 3.10.12, scikit-learn 1.5.1, NumPy 1.26.3 on CPU.
Spaces in TRAIN are manually specified token boundaries, not tokenizer output.
"""

import json
import math
import platform

import numpy as np
import scipy
import sklearn
from sklearn.feature_extraction.text import CountVectorizer, TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import make_pipeline


TRAIN = ["模型 好用 好用 推薦", "模型 便宜 推薦",
         "服務 好用 快速 推薦", "服務 便宜 推薦"]
LABELS = ["產品", "產品", "服務", "服務"]


def word_options():
    # Replace only tokenizer: the word analyzer still constructs n-grams.
    return {"tokenizer": str.split, "token_pattern": None}


def rounded(array):
    return np.asarray(array).round(8).tolist()


def run():
    defaults = CountVectorizer().build_analyzer()
    assert defaults("我 愛 資料 科學") == ["資料", "科學"]
    assert defaults("我愛資料科學") == ["我愛資料科學"]
    chars = CountVectorizer(analyzer="char", ngram_range=(2, 2))
    assert chars.build_analyzer()("資料科學") == ["資料", "料科", "科學"]

    cv = CountVectorizer(**word_options())
    counts = cv.fit_transform(TRAIN)
    words = cv.get_feature_names_out().tolist()
    expected = np.array([[0, 2, 0, 1, 0, 1], [1, 0, 0, 1, 0, 1],
                         [0, 1, 1, 1, 1, 0], [1, 0, 0, 1, 1, 0]])
    assert words == ["便宜", "好用", "快速", "推薦", "服務", "模型"]
    np.testing.assert_array_equal(counts.toarray(), expected)
    df = np.asarray((counts > 0).sum(axis=0)).ravel()
    np.testing.assert_array_equal(df, [2, 2, 1, 4, 2, 2])

    raw = TfidfVectorizer(norm=None, **word_options())
    weighted = raw.fit_transform(TRAIN)
    expected_idf = np.log((1 + len(TRAIN)) / (1 + df)) + 1
    np.testing.assert_allclose(raw.idf_, expected_idf)
    np.testing.assert_allclose(weighted.toarray(), expected * expected_idf)
    normal = TfidfVectorizer(**word_options())
    unit = normal.fit_transform(TRAIN)
    dense = weighted.toarray()
    np.testing.assert_allclose(unit.toarray(), dense / np.linalg.norm(dense, axis=1)[:, None])
    np.testing.assert_allclose(np.asarray(unit.multiply(unit).sum(axis=1)).ravel(), 1)
    common = words.index("推薦")
    assert raw.idf_[common] == 1

    sub = TfidfVectorizer(norm=None, sublinear_tf=True, **word_options())
    sub.fit(TRAIN)
    sub_value = sub.transform([TRAIN[0]])[0, words.index("好用")]
    assert math.isclose(sub_value, (1 + math.log(2)) * expected_idf[1])
    no_smoothing = TfidfVectorizer(norm=None, smooth_idf=False, **word_options())
    no_smoothing.fit(TRAIN)
    np.testing.assert_allclose(no_smoothing.idf_, np.log(len(TRAIN) / df) + 1)

    filtered = CountVectorizer(min_df=2, max_df=0.75, **word_options())
    filtered.fit(TRAIN)
    assert filtered.get_feature_names_out().tolist() == ["便宜", "好用", "服務", "模型"]
    integer_max = CountVectorizer(max_df=1, **word_options()).fit(TRAIN)
    float_max = CountVectorizer(max_df=1.0, **word_options()).fit(TRAIN)
    assert integer_max.get_feature_names_out().tolist() == ["快速"]
    assert len(float_max.vocabulary_) == 6

    sentences = ["我 喜歡 你", "你 喜歡 我"]
    unigrams = CountVectorizer(**word_options()).fit_transform(sentences).toarray()
    np.testing.assert_array_equal(unigrams[0], unigrams[1])
    bigrams = CountVectorizer(ngram_range=(2, 2), **word_options())
    pairs = bigrams.fit_transform(sentences).toarray()
    assert not np.array_equal(pairs[0], pairs[1])
    tokens_and_pairs = CountVectorizer(ngram_range=(1, 2), **word_options())
    combined = tokens_and_pairs.build_analyzer()(sentences[0])
    assert combined == ["我", "喜歡", "你", "我 喜歡", "喜歡 你"]

    # transform uses frozen vocabulary and IDF. All unseen -> zero row.
    old_idf, old_vocab = normal.idf_.copy(), dict(normal.vocabulary_)
    unseen = normal.transform(["神奇 新品"])
    assert unseen.nnz == 0
    np.testing.assert_array_equal(normal.idf_, old_idf)
    assert normal.vocabulary_ == old_vocab
    query = normal.transform(["好用 模型"])
    # All four training rows and this query have nonzero L2 norm.
    # Dot products are cosine similarities in THIS nonzero normalized case.
    similarities = (unit @ query.T).toarray().ravel()
    assert int(similarities.argmax()) == 0

    # Deliberately wrong evaluation setup to expose what changes, not to use it.
    leaked = TfidfVectorizer(**word_options()).fit(TRAIN + ["神奇 新品"])
    assert "神奇" in leaked.vocabulary_ and "神奇" not in old_vocab
    leaked_common_idf = leaked.idf_[leaked.vocabulary_["推薦"]]
    assert math.isclose(leaked_common_idf, math.log(6 / 5) + 1)

    # One actual fit/predict on four artificial documents; no accuracy claim.
    baseline = make_pipeline(TfidfVectorizer(**word_options()),
                             LogisticRegression(solver="liblinear", random_state=0))
    baseline.fit(TRAIN, LABELS)
    prediction = baseline.predict(["模型 神奇"]).tolist()
    assert prediction == ["產品"]

    return {
        "environment": {"python": platform.python_version(), "numpy": np.__version__,
                        "scipy": scipy.__version__, "sklearn": sklearn.__version__,
                        "device": "cpu"},
        "training_texts": TRAIN, "feature_names": words,
        "count_matrix": expected.tolist(), "document_frequency": df.tolist(),
        "shape": list(counts.shape), "stored_nonzeros": counts.nnz,
        "idf_smooth": rounded(raw.idf_), "weighted_before_l2": rounded(weighted.toarray()),
        "tfidf_l2": rounded(unit.toarray()),
        "sublinear_double_count_weight": round(float(sub_value), 8),
        "idf_without_smoothing": rounded(no_smoothing.idf_),
        "filtered_features": filtered.get_feature_names_out().tolist(),
        "integer_max_df_1_features": integer_max.get_feature_names_out().tolist(),
        "word_unigrams_and_bigrams": combined,
        "bigram_feature_names": bigrams.get_feature_names_out().tolist(),
        "bigram_matrix": pairs.tolist(), "unseen_document_nnz": unseen.nnz,
        "nonzero_query_cosines": rounded(similarities),
        "leaked_common_term_idf": round(float(leaked_common_idf), 8),
        "artificial_pipeline_prediction": prediction,
        "scope": "Artificial fit/predict and arithmetic only; no held-out accuracy, CV or benchmark.",
    }


if __name__ == "__main__":
    print(json.dumps(run(), ensure_ascii=False, indent=2, allow_nan=False))
成功時會輸出 JSON。可以先核對 feature_names、count_matrix 和 document_frequency,再對照 idf_smooth、weighted_before_l2 及 tfidf_l2;這些欄位就是本文一步步拆開的中間量。unseen_document_nnz 應為 0,artificial_pipeline_prediction 則是 ['產品']。
若遇到 empty vocabulary,先看斷詞後還剩哪些 token,以及 min_df/max_df 是否把全部特徵篩掉。若自己的數字與本文不同,優先比對文件內容、斷詞、詞表順序、IDF 平滑與正規化設定,不要只看向量形狀相同就認為內容一致。
看懂這套表示,才知道何時需要更進一步
BoW 與 TF-IDF 讓我們能直接追問:模型看到了哪個詞、出現多少、在什麼語料下被賦予什麼權重。對可解釋的文字基準、詞彙重疊型檢索及初步分類,這些問題都很有用。
同時也能清楚指出界線:詞形不同不一定連得起來,語意相近不保證向量接近;少量 n-grams 沒有保存完整句法;未知詞可能整份變成零向量;高 IDF 也不代表重要或可信。
要處理這些界線,可以調整斷詞與特徵,也可以進一步學習稠密詞向量。下一篇會談 Word2Vec、GloVe 與 FastText;在那之前,先確定你能從一列數字,說回它是哪份文件、用了哪套詞表,以及每個數值是如何算出來的。
主要來源:
- scikit-learn 1.5:Text feature extraction,BoW、稀疏矩陣、TF-IDF、n-gram 與自訂 analyzer 的完整脈絡。
- CountVectorizer、TfidfTransformer、TfidfVectorizer,參數與公式;實際版本差異按正文交代。
- Google Text Classification Guide:Prepare your data,n-gram 與 sequence 表示的區別。來源的跨資料集準確率/特徵數結論不作本篇通則。
- scikit-learn:Common pitfalls and recommended practices,訓練區學轉換、Pipeline 與資料洩漏的界線。
留言0
登入後就能留言。
登入