
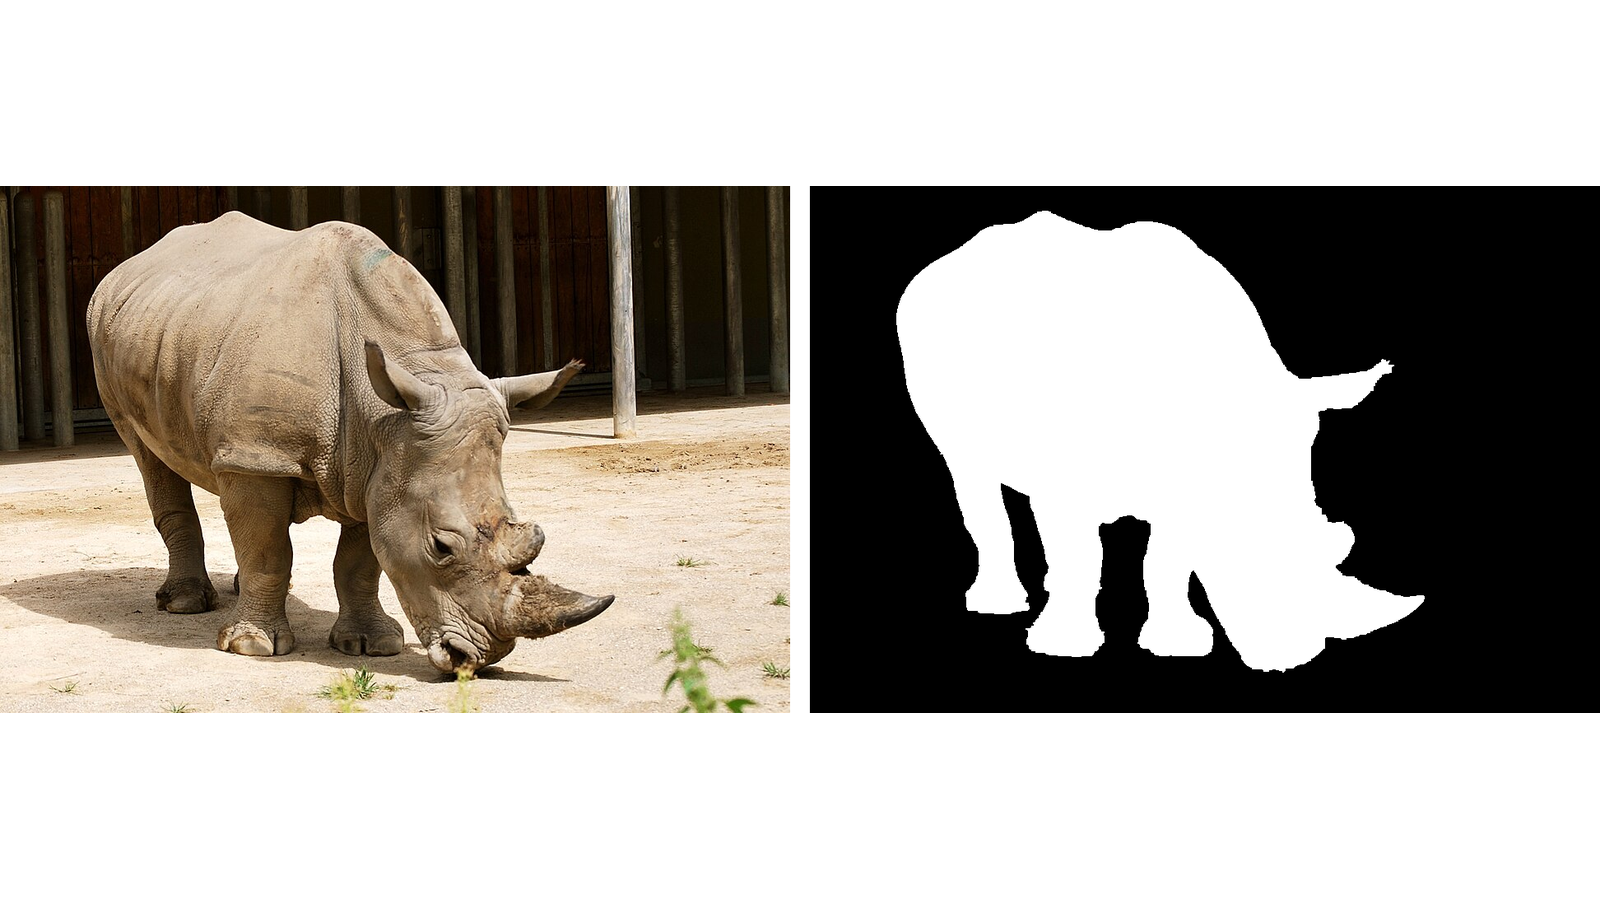
假設你想把一張犀牛照片的背景去掉。分類模型回答「這張照片有犀牛」,物件偵測再給你一個包住犀牛的方框;但方框裡還有地面、欄杆,以及腿與腿之間的空隙。要決定哪些像素應該留下,就需要更細的輸出。
語義分割把問題變成:每一個像素屬於哪個類別? 影像中的位置還在,模型要為每個位置提供分類分數,最後轉成類別遮罩。難處在於,判斷「這是什麼」需要看周圍脈絡,畫準「邊界在哪裡」又需要保留位置細節。
這篇從一組真正的照片與遮罩開始,理解 FCN 和 U-Net 如何處理這個矛盾,再檢查常見的實作錯誤。本文實跑的是手設矩陣與 logits 的 CPU 算例,沒有訓練分割網路,也沒有把來源遮罩冒充本站模型的預測。
照片、類別遮罩與物件個體,是三種不同資訊
照片的 RGB 值描述顏色;訓練用遮罩中的數字描述類別。假設背景是 0、犀牛是 1,遮罩中的 1 不是灰階亮度,也不是「有一隻犀牛」。它表示這個位置的標籤是犀牛類。
常見的彩色分割圖,通常只是把類別編號映射到方便辨識的顏色。模型真正需要的標籤,可能是一張整數矩陣;若資料提供 RGB 標註圖,還需要按照資料集的色票把每個顏色轉回類別 ID,不能把三個 RGB channel 直接當成三類。
| 任務 | 一張有兩隻犀牛的照片,應輸出什麼? | 能否直接數出兩隻? |
|---|---|---|
| 影像分類 | 整張圖有犀牛這個類別 | 不能 |
| 物件偵測 | 各物件的框、類別與分數 | 可依偵測框計數,但受漏檢與重複框影響 |
| 語義分割 | 每個像素的類別,兩隻都可標成犀牛 | 不能只靠類別 ID 區分個體 |
| 實例分割 | 每個物件各有遮罩與類別 | 輸出包含個體區分,但仍可能漏檢或分錯 |
把同一類的連通區數量當成物件數,也未必可靠:兩隻靠在一起可能黏成一塊,一隻被遮擋則可能分成多塊。Torchvision 的實例分割範例中,每個 instance 都有自己的 mask,和一張只存語義類別的遮罩不同。
FCN:把整張圖的一個答案,改成一張分類分數地圖
在卷積與感受野的討論中,特徵圖的每個位置已經對應輸入中的一片區域。影像分類常把這些空間資訊彙整成整張圖的向量,再產出一個類別;分割則希望保留空間網格,讓不同位置有不同答案。
2015 年 Long、Shelhamer、Darrell 的 FCN 論文把成熟的分類網路改成密集預測網路,並以像素級損失端到端微調。這不是影像分割的起點,也不是第一個出現卷積式密集輸出的工作;它的重要性在於把分類預訓練、全卷積計算、可學習上採樣與多層融合串成一套有效的方法。
先看這個基本結構,不必一次記完所有層。假設特徵圖形狀是 N×D×h×w,N 是批次大小、D 是特徵通道數,h×w 是較粗的空間網格。
1×1 卷積在每個位置混合 D 個特徵通道。若要分 C 類,它可以把形狀轉成 N×C×h×w:每個位置都有 C 個未正規化分數,也就是 logits。1×1 卷積主要在這裡改變通道數,不會自行把粗網格變回細網格。
接著透過上採樣,把分數地圖對齊目標像素網格,得到例如 N×C×H×W 的輸出。對互斥多類別任務,在類別維度取 argmax,才得到 N×H×W 的類別 ID。上採樣的對齊、裁切及 padding 都要明確安排,不能只看到「全卷積」就認定任何輸入尺寸都會自動原樣對齊。
例如 D2L 的教學實作以 ResNet-18 特徵為基礎,320×480 輸入得到 10×15 的粗特徵,再安排上採樣。那是教材的一個具體設定,不是 2015 原論文的全部架構,也不代表所有 FCN 都固定輸入 320×480。
FCN-32s、16s、8s:加入細節時,融合的是什麼?
如果把非常粗的類別分數圖直接放大,輸出像素數雖然增加,原本丟失的邊界資訊卻不會因此自動回來。FCN 原論文於是把較淺、解析度較高的層接回來。
- 從最終 stride 32 的粗分數圖一次上採樣回像素網格
- 粗預測的位置間隔
- 把粗分數圖上採樣 2 倍,與 pool4 經 1×1 卷積產生的類別分數對齊相加,再上採樣
- 融合到較細的 stride 16 網格
- 進一步納入 pool3 的類別分數,在 stride 8 網格融合,再上採樣
- 又加入更細的空間資訊
這裡的數字不是卷積層數、類別數,也不是輸出圖片的固定寬度。原論文的 skip 融合是類別分數逐位置相加。兩邊先成為相同類別數、相同空間對齊的張量,才能合理相加。
若兩組分數各是 N×C×h×w,相加之後仍是 N×C×h×w。這和稍後 U-Net 把特徵通道接在一起不同。兩者都叫 skip connection,不能因此把操作混為一談。
想看原始架構與三個版本的結果,可對照 FCN 論文圖 3、圖 4 與第 4.2 節。本文以連結提供原論文圖,不把論文實驗數字寫成本站跑出的成績。
U-Net:把編碼時的細節交回解碼端
U-Net 也處理「理解脈絡」與「定位細節」的拉扯。左側的 contracting path 透過卷積與下採樣擷取脈絡;右側的 expanding path 提高空間解析度,再利用左側對應層的特徵改善定位。
假設解碼端目前是 N×128×h×w,同一解析度的編碼特徵是 N×64×h×w。沿通道維度 concatenation 之後,得到 N×192×h×w;後面的卷積再學習如何使用這些資訊。這不是把兩張分數圖平均,也不會直接得到已經判好的遮罩。
右側多了細節來源,不代表辨識必然正確。陰影、標註錯誤或不同設備的影像差異,仍然可能讓模型分錯;skip connection 提供的是資訊路徑,不是保證。
還要把原版 U-Net與圖 3 這類後來的簡化版本分開。Ronneberger、Fischer、Brox 的 2015 論文使用不補邊的 3×3 卷積,每次卷積都縮小特徵圖,因此橫向特徵要先 crop,再和解碼特徵串接。
所以,原始圖中的 572×572 輸入對應 388×388 輸出不是算錯,也不是一定要把輸出任意拉伸回 572。原文搭配 overlap-tile 與邊界鏡射處理大圖。現在有些實作用 padding 維持尺寸,是可行的設計選擇;比較或重現時要說是哪一種。
原論文也使用大量資料增強,並在訓練損失中特別加重接觸細胞之間的分隔區域。這些是完整方法的一部分,不能把成效只歸功於 U 字形。它的前景/背景輸出,也不能因圖中細胞用不同顏色標示,就直接解讀成網路原生輸出每個細胞的 instance ID。
上採樣增加位置,轉置卷積不會把原圖倒算回來
上採樣是增加空間網格的操作。它可以採固定插值,也可以採帶有可學習權重的轉置卷積;不同網路會在不同位置使用它們。
把這張圖想成「分送後相加」會比「還原圖片」更容易檢查:左上角的 0 送出一片零;右上角的 1 送出一片 kernel,位置向右移;左下角的 2 送出兩倍 kernel,位置向下移;右下角的 3 送出三倍 kernel,向右、向下各移一格。中間格會收到多份貢獻,因此要加總。
stride 1 輸出:
0   0   1
0   4   6
4  12   9
單一方向的尺寸可用 PyTorch 2.3 文件核對:
輸出長度 = (輸入長度 − 1) × stride − 2 × padding
         + dilation × (kernel_size − 1) + output_padding + 1
圖 4 是 (2−1)×1 + (2−1) + 1 = 3;圖 5 是 (2−1)×2 + (2−1) + 1 = 4。高度與寬度分別代入,不能把通道數拿來套這條式子。
「轉置」來自對應線性運算的矩陣轉置。若不含 bias 的卷積寫成 y = W x,對應轉置運算是 Wᵀ y,一般並不是 W⁻¹ y。即使輸出形狀與原輸入相同,也不表示內容相同。後面的程式會用一個 3×3 矩陣實際驗證。
stride 大於 1 時,不同輸入尺寸還可能被普通卷積縮到同一尺寸。output_padding 用來決定轉置卷積的輸出形狀歧義,不是在輸出圖片周圍真的補一圈零,更不是補回失去的資訊。
轉置卷積也可能出現棋盤格狀 artifact。Distill 的分析指出,kernel 與 stride 造成不均勻重疊時,不同位置接收的貢獻數量可能不同。這是需要檢查的風險,不是「所有轉置卷積一定產生棋盤格」。調整 kernel/stride 或改用 resize 後接卷積,都需要觀察實際輸出,不能只換一個層名就保證消失。
開始訓練以前,先確認 mask 沒有被處理壞
分割模型很容易在「程式能跑」的情況下學錯東西。尤其 image 與 mask 看起來都是圖片,卻不應共用所有處理方式。
第一,兩者要使用同一個空間變換。若照片向左裁 20 像素,遮罩也必須裁相同區域;隨機翻轉、旋轉也要同步。分開呼叫兩次隨機裁切,得到的是兩個各自合法、但彼此不對齊的輸入。
第二,離散類別 ID 的遮罩縮放,應明確選擇最近鄰這類保留標籤的方式,避免把 ID 當成可混合的亮度。照片可以採雙線性插值,類別遮罩照搬同一設定卻可能製造不存在的類別。
本文用 PyTorch nearest-exact,把下面的 2×2 遮罩縮放為 3×3:
原遮罩:       nearest-exact:     bilinear,align_corners=False:
0  2          0  2  2             0  1  2
0  2          0  2  2             0  1  2
              0  2  2             0  1  2
原來只有 0 和 2,雙線性插值卻產生 1。即使 1 剛好也是合法類別,那也不是這張標註真的提供的資訊;最後 .long() 不會自動修復語義。官方 interpolate 文件另說明 nearest 和 nearest-exact 的歷史對齊差異,跨函式庫重現時要記錄具體模式。
這個建議針對「類別索引遮罩」。已經是連續機率的 soft target 或分數圖,則要按它的定義處理,不能把所有叫 mask 的資料都強制最近鄰。
第三,要保留 ignore label 的意義。有些資料以 255 表示不評估或未標註,不是第 256 類,也不應直接變成背景。讀圖、色票轉換、裁切、縮放、loss 和 metric 都要沿用相同約定。
CrossEntropy 與 BCE:先看每個像素允許幾個答案
如果每個像素只能選一類,例如背景、道路、車輛三選一,可以用多類別交叉熵。以 class-index target 格式為例:
| 項目 | 互斥 C 類,使用 CrossEntropy | 一個獨立二元前景,使用 BCEWithLogits |
|---|---|---|
| logits | 浮點 N×C×H×W | 浮點 N×1×H×W |
| target | 整數 long,N×H×W | 浮點,與 logits 同形狀 |
| target 的意義 | 每像素一個類別 ID,另可指定 ignore_index | 每位置的二元目標,值在 0 到 1 |
| 送入 loss 以前 | 不先 softmax | 不先 sigmoid |
| 轉成硬預測的常見方式 | 在類別維度 argmax | sigmoid 後依閾值判斷,0.5 是一個選擇 |
兩個類別也可以用兩個 logits 加 CrossEntropy;不是「二元任務只能 BCE」。若同一像素允許多個獨立標籤,可以用多個二元 channel,但這和互斥多類別的問題定義不同。
CrossEntropy 在內部處理 logits 對應的 log-softmax;BCEWithLogits 則把 sigmoid 和 binary cross-entropy 合在一起,以提高數值穩定性。先手動做 sigmoid 再交給 BCEWithLogits,等於把它預期的 logits 換成機率,改掉了問題。CrossEntropy 文件也允許同形狀的機率 target,但那是另一種 target 格式,不能和上表的整數索引要求混用。
BCEWithLogitsLoss 沒有 CrossEntropy 那樣的 ignore_index 參數。有未標註像素時,要自行選取有效元素或以 unreduced loss 遮罩後除以有效權重;若沒有任何有效元素,須明確跳過或另定處理方式,不能期待空集合平均仍有意義。CrossEntropy 的 mean reduction 在全部 target 都是 ignore 時,同樣沒有有效平均分母;不能把指標函式回傳的 null 當成 loss 會自動安全的證據。
同樣地,類別不平衡也不會因為網路叫 U-Net 就消失。加權交叉熵、抽樣或 Dice 類型損失可以是處理方向,但權重、空集合與 reduction 定義都會改變目標;本文沒有把其中任何一種宣稱為所有資料的最佳配方。
IoU 與 Dice:相同預測,也可能得到不同的「平均」
對某個類別,把預測前景集合叫 A、真實前景集合叫 B:
IoU  = 交集像素數 / 聯集像素數
     = TP / (TP + FP + FN)

Dice = 2 × 交集像素數 / (預測像素數 + 真實像素數)
     = 2TP / (2TP + FP + FN)
在分母有效、同一組硬遮罩的前提下,Dice = 2×IoU / (1+IoU)。例如 IoU 是 0.5,Dice 是 2/3;不能因 Dice 數字較大,就說同一份預測突然變好了。各類先換算再平均,也不等於把平均 IoU 直接代入這條式子。
看這個本文手設例子,255 是忽略位置:
真值 target:    預測 pred:
0  0   1        0  1  1
0  2 255        0  0  2
先排除真值為 255 的位置,再建立「列是真值、欄是預測」的混淆矩陣:
| 真值\預測 | 0 背景 | 1 | 2 |
|---|---|---|---|
| 0背景 | 2 | 1 | 0 |
| 1 | 0 | 1 | 0 |
| 2 | 1 | 0 | 0 |
五個有效像素有三個判對,pixel accuracy 是 0.6。各類 IoU 分別是 0.5、0.5、0;含背景的 macro mean 是 1/3,只平均前景類 1、2 則是 0.25。同一組輸出,僅改「是否把背景納入平均」,數字就不同。
本文程式採用的約定是:先在所有有效像素上累積混淆矩陣,再逐類計算、等權平均;不是每張圖各自算分再平均。函式只彙整當次傳入的像素;評估整份資料時,須傳入完整集合,或逐批累加混淆矩陣後再算比值,不能直接平均每批 mIoU。若某類在真值和預測都沒有出現,分母為零,回傳 None 並略過該類平均,不加 epsilon。若真值沒有該類、卻預測出該類,聯集非零,該類 IoU 是 0,仍要受到處罰。
全部都是 ignore 的情況,程式回傳沒有有效分數,而不是漂亮的 1。別人的工具可能採不同空集合規則,或固定平均全部類別;比較前要把背景、ignore、平均範圍、平滑項與空集合規則一起核對。
當背景占大部分時,全猜背景也可能得到高 pixel accuracy。IoU/Dice 能補上重疊品質,但也不能單獨描述邊界錯在哪裡、漏掉多少個物件,或應用的錯誤成本。實務評估還應回看原圖、真值和預測,按情境分析細小物件、邊界與不同來源影像的失敗案例。
用一個 CPU 練習,把處理規則跑過一次
下方完整程式使用手設 logits、類別遮罩和卷積核,不需要資料集、GPU 或預訓練權重。本文已在 Python 3.10.12、PyTorch 2.3.1+cu118 的 CPU 執行;套件版本中的 CUDA 標記不表示本練習用了 GPU,也不是宣稱這是最新版本。
在已有 PyTorch 的 Python 環境,把程式存為 segmentation_checks.py,執行 python3 segmentation_checks.py。若要建立獨立 CPU 環境,以下是 WSL/Linux 的準備指令;它會下載套件,與本練習不下載模型權重是不同的事:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install torch==2.3.1 --index-url https://download.pytorch.org/whl/cpu
python segmentation_checks.py
這是固定版本的重現方式,安裝需求可另查 PyTorch 官方歷史版本頁。本文沒有另行執行新建環境的下載安裝;實際運算驗證使用前述已存在環境。
程式會檢查插值是否產生新 ID、零 logits 的兩種 loss、含 ignore 的混淆矩陣、缺席類別和全忽略情況,再驗證圖 4/5 的轉置卷積算例,以及「形狀回來、數值卻沒有回來」的反例。
"""CPU arithmetic examples; no training, image inference or downloaded weights.

Checked with Python 3.10.12 / torch 2.3.1+cu118, using CPU only.
All masks and logits below are hand-specified teaching inputs.
"""

import json
import math
import platform

import torch
from torch.nn import functional as F


def class_metrics(pred, target, classes, ignore=255):
    """Dataset-global confusion, rows=true, cols=predicted; ignore by target.

    Classes absent in BOTH prediction and truth have undefined IoU/Dice,
    represented as None and omitted from macro means. No epsilon smoothing.
    Background is class 0 and is included in the all-class macro means.
    """
    if pred.shape != target.shape:
        raise ValueError("prediction and target must have the same shape")
    if pred.dtype != torch.long or target.dtype != torch.long:
        raise ValueError("class-index masks must be torch.long")
    valid = target != ignore
    truth, guessed = target[valid], pred[valid]
    if ((truth < 0) | (truth >= classes)).any():
        raise ValueError("target class outside valid range")
    if ((guessed < 0) | (guessed >= classes)).any():
        raise ValueError("predicted class outside valid range")
    cm = torch.bincount(truth * classes + guessed,
                        minlength=classes * classes).reshape(classes, classes)
    tp = cm.diag()
    actual, predicted = cm.sum(1), cm.sum(0)
    union = actual + predicted - tp
    denominator = actual + predicted
    iou = [int(t) / int(u) if u else None for t, u in zip(tp, union)]
    dice = [2 * int(t) / int(d) if d else None
            for t, d in zip(tp, denominator)]

    def mean_defined(values):
        defined = [v for v in values if v is not None]
        return sum(defined) / len(defined) if defined else None

    return {
        "confusion_true_rows": cm.tolist(),
        "valid_pixels": int(valid.sum()),
        "pixel_accuracy": int(tp.sum()) / len(truth) if len(truth) else None,
        "iou_per_class": iou,
        "dice_per_class": dice,
        "miou_including_background": mean_defined(iou),
        "macro_dice_including_background": mean_defined(dice),
        "miou_foreground_only": mean_defined(iou[1:]),
    }


def run():
    # IDs 0 and 2 are classes; class 1 does not occur in the input mask.
    mask = torch.tensor([[[[0., 2.], [0., 2.]]]])
    near = F.interpolate(mask, size=(3, 3), mode="nearest-exact")
    linear = F.interpolate(mask, size=(3, 3), mode="bilinear", align_corners=False)
    assert near.unique().tolist() == [0., 2.]
    assert linear.unique().tolist() == [0., 1., 2.]

    target = torch.tensor([[[0, 0, 1], [0, 2, 255]]], dtype=torch.long)
    pred = torch.tensor([[[0, 1, 1], [0, 0, 2]]], dtype=torch.long)
    logits = torch.zeros((1, 3, 2, 3))
    ce = F.cross_entropy(logits, target, ignore_index=255)
    assert math.isclose(float(ce), math.log(3), rel_tol=1e-6)
    # One independent binary foreground channel, same shape and float target.
    binary_target = torch.tensor([[[[0., 0., 1.], [0., 1., 0.]]]])
    bce = F.binary_cross_entropy_with_logits(torch.zeros_like(binary_target),
                                           binary_target)
    assert math.isclose(float(bce), math.log(2), rel_tol=1e-6)
    # BCE has no ignore_index: explicitly select valid elements if applicable.
    valid_binary = (target != 255).unsqueeze(1)
    masked_bce = F.binary_cross_entropy_with_logits(
        torch.zeros_like(binary_target)[valid_binary], binary_target[valid_binary])
    assert math.isclose(float(masked_bce), math.log(2), rel_tol=1e-6)

    metrics = class_metrics(pred, target, 3)
    assert metrics["confusion_true_rows"] == [[2, 1, 0], [0, 1, 0], [1, 0, 0]]
    assert metrics["valid_pixels"] == 5
    assert metrics["iou_per_class"] == [0.5, 0.5, 0.0]
    assert math.isclose(metrics["miou_including_background"], 1 / 3)
    assert metrics["miou_foreground_only"] == 0.25
    empty = class_metrics(torch.zeros((1,), dtype=torch.long),
                          torch.zeros((1,), dtype=torch.long), 3)
    assert empty["iou_per_class"] == [1.0, None, None]
    ignored = class_metrics(torch.zeros((1,), dtype=torch.long),
                            torch.full((1,), 255, dtype=torch.long), 3)
    assert ignored["miou_including_background"] is None

    x = torch.tensor([[[[0., 1.], [2., 3.]]]])
    kernel = x.clone()
    stride1 = F.conv_transpose2d(x, kernel)
    stride2 = F.conv_transpose2d(x, kernel, stride=2)
    assert stride1[0, 0].tolist() == [[0., 0., 1.], [0., 4., 6.], [4., 12., 9.]]
    assert stride2.shape == (1, 1, 4, 4)

    # Transpose is an adjoint, not an inverse. Bias-free, matching geometry.
    original = torch.arange(9.).reshape(1, 1, 3, 3)
    k = torch.ones((1, 1, 2, 2))
    reduced = F.conv2d(original, k)
    returned = F.conv_transpose2d(reduced, k)
    assert returned.shape == original.shape
    assert not torch.equal(returned, original)
    probe = torch.tensor([[[[1., 2.], [3., 4.]]]])
    assert torch.equal((reduced * probe).sum(),
                       (original * F.conv_transpose2d(probe, k)).sum())
    # Both sizes collapse to 2; output_padding selects geometry, not content.
    k3 = torch.ones((1, 1, 3, 3))
    for size in (5, 6):
        assert F.conv2d(torch.zeros(1, 1, size, size), k3, stride=2).shape[-1] == 2
    coarse = torch.zeros(1, 1, 2, 2)
    shapes = [list(F.conv_transpose2d(coarse, k3, stride=2,
                                    output_padding=p).shape[-2:]) for p in (0, 1)]
    assert shapes == [[5, 5], [6, 6]]

    return {
        "environment": {"python": platform.python_version(), "torch": torch.__version__,
                        "device": "cpu", "training": False},
        "nearest_exact_mask": near[0, 0].tolist(),
        "bilinear_mask": linear[0, 0].tolist(),
        "ce_zero_logits": float(ce), "bce_zero_logits": float(bce),
        "bce_valid_pixels_only": float(masked_bce),
        "metrics": metrics, "absent_classes": empty, "all_ignored": ignored,
        "transpose_stride1": stride1[0, 0].tolist(),
        "transpose_stride2": stride2[0, 0].tolist(),
        "transpose_is_not_inverse": returned[0, 0].tolist(),
        "output_padding_shapes": shapes,
    }


if __name__ == "__main__":
    print(json.dumps(run(), ensure_ascii=False, indent=2, allow_nan=False))
執行成功會輸出 JSON;重要欄位應接近以下數值,浮點數尾端可能因環境顯示略有差異:
如果看到 AssertionError,先保留報錯位置與環境版本,檢查是否改了矩陣、維度、插值模式或 ignore 值。不要刪掉 assertion 後把「能印出數字」當成重現成功。這些檢查證明的是算例與處理約定,沒有證明任何模型能準確分割犀牛、道路或細胞。
選模型以前,先把你要交付的遮罩說清楚
要落地一個分割應用,可以先問:每像素只選一類,還是允許多標籤?需要區分個體嗎?標註裡有哪些忽略區域?細小結構與邊界錯誤的代價是什麼?輸出必須對應原圖哪些位置?這些答案會決定標註、loss、後處理和驗收方式。
FCN 教我們把分類特徵轉成密集分數,並用不同解析度的預測融合細節;U-Net 則把編碼端的特徵交回解碼端,讓上採樣不必只依賴最底層的粗表示。讀懂兩者時,應能指出資訊從哪裡來、在哪裡相加或串接,以及輸出如何與標註對齊。
先把照片和 mask 對上,再確認處理後的類別集合與形狀;最後用已寫明約定的指標評估,並回看失敗案例。這幾步成立,架構比較才有可解讀的基礎。
主要技術來源與版本:
- Long、Shelhamer、Darrell:Fully Convolutional Networks for Semantic Segmentation,CVPR 2015,尤其第 3.3、4.1、4.2 節及圖 3;架構與原論文指標設定。
- Ronneberger、Fischer、Brox:U-Net,2015,尤其圖 1、第 2–3 節;原版 valid convolution、crop-concat 與訓練設計。
- D2L:Fully Convolutional Networks、Transposed Convolution;教材的基本結構與數值示意,不替代原論文各版本。
- PyTorch 2.3:CrossEntropyLoss、BCEWithLogitsLoss、ConvTranspose2d、interpolate;本文固定核對的 API 版本。
- Odena、Dumoulin、Olah:Deconvolution and Checkerboard Artifacts,Distill 2016;不均勻重疊與 artifact 的機制討論。
留言0
登入後就能留言。
登入