
如果門市想知道下個月該備多少貨,第一個問題不是要用哪個模型,而是:現在已經知道哪些資料?要一次預測未來一天,還是未來十二個月?預測期間會不會拿到新的實際銷量?
這些條件會直接改變難度。拿昨天銷量預測今天,與站在年初一次預測全年,不能放在同一張排行榜上比較。把所有月份隨機打散,也可能讓模型先看見未來的水準或季節樣貌,再回頭回答過去的問題。
本篇從這個時間邊界開始,走到季節基線、STL、差分與 ARIMA。最後會真的擬合兩種 ARIMA,用相同十二步預測做驗證,並留下最後十二點才評估。資料是我們明確設計的人工序列,適合核對流程;它不代表任何產業資料或模型的通用排名。
預測的單位,是「從現在往後幾步」
設最後已知的時間是 T,未來第 h 步的預測寫成下面這樣。直線右邊提醒我們:答案只能依賴當時已知的資訊。
ŷ(T+h | T),   h = 1, 2, ..., H
T:預測起點最後已知的時間
h:離起點的步數
H:一次要交付的預測範圍(horizon)
每步多久取決於資料頻率。每月資料的十二步通常是一年;每日資料的十二步是十二天。只有一串數字而沒有頻率,不能自行把 lag 12 稱為年度季節性。實際資料還要確認缺日、時區、假期與統計口徑;不規則時間間隔中的「前一筆」,未必是固定時間前的狀態。
可用資料也有發布時間。月底的銷量可能隔月才結算,不能只因欄位日期寫上個月,就假設當時已拿得到。未來的日曆與已排定活動可能預先知道,未來實際氣溫則不同。需要留空檔的情境,可以在訓練與驗證之間設 gap,但 gap 不能取代逐項確認資料何時可見。
時間切分的基本做法,是在較早的資料訓練,對後面的區段評分,再把起點往前推。擴張視窗會保留過去資料;固定長度的移動視窗則會丟掉較舊的部分。是否保留很久以前的資料,要看機制是否已改變。
scikit-learn 的 時間序列交叉驗證說明也以固定時間間隔資料說明這個切法。它解決的是先後順序,沒有替我們處理所有特徵洩漏。標準化、缺值填補、分解或選參數,仍應在各折當時可用的歷史內完成。
先建立兩個簡單到可以手算的預測
第一個基線是 naive:不知道未來如何變化,就先把最後觀察值延伸出去。
naive:ŷ(T+h | T) = y(T),所有 h 都一樣
它沒有斜率,也沒有季節調整。若最後銷量是 125.2,接下來十二步就都預測 125.2。這不是隨便猜:對某些接近隨機漫步的序列,它是很有意義的參照。複雜模型必須說明自己比「維持最新狀態」多掌握了什麼。
第二個基線是 seasonal naive:預期同一季節位置會再出現。若每十二步是一輪,未來第一步複製十二步前對應的位置,而不是複製最後一點。
季節週期 m,且 1 ≤ h ≤ m:
ŷ(T+h | T) = y(T+h-m)

若要重複最後一個完整季節到更遠處:
k = floor((h-1)/m)
ŷ(T+h | T) = y(T+h-(k+1)m)
本文只做 H=m=12 的版本,直接取最後十二點,按原順序複製。週期十二是教學設計的一部分,不是偷看測試結果後才找到的最佳週期。真實任務要先有時間頻率與業務依據,再用歷史驗證檢查這個假設。
這個基線會保留季節形狀,卻沒有把持續成長自動加上去。如果今年同月份普遍比去年高,預測就可能整段偏低。因此「比上一期」和「比上一季同位置」是兩個不同的參照,值得同時保留。
趨勢、季節與不規則波動,混在同一條線上
時間序列不只有相鄰點的關係。長期水準可能慢慢改變,固定時間位置可能反覆高低,剩下還有未被這些規律描述的變動。
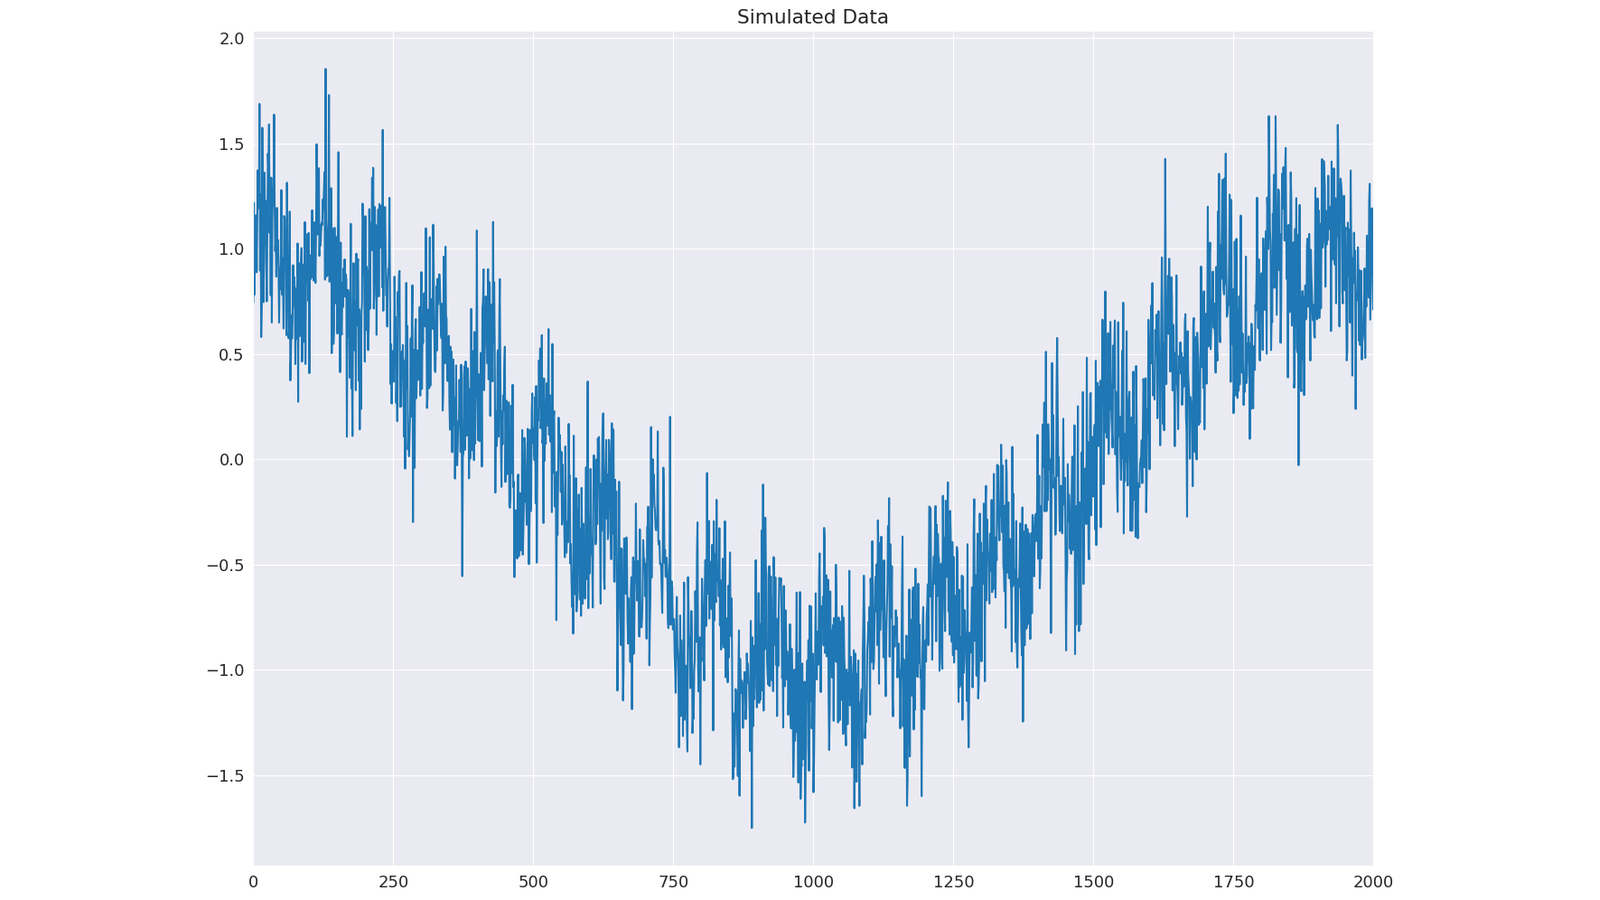
看圖 2 時,先把眼光從每個尖峰拉遠:整體先下降再上升,是這段資料較慢的變化;沿途較快的重複起伏,則來自來源刻意加入的週期成分。趨勢不必是直線,也不一定永遠延續。季節性通常指相對固定週期的反覆變化;經濟循環等長短會變的波動,不宜只因「看起來會重複」就指定一個固定季節長度。
STL 是用 LOESS 平滑進行季節與趨勢分解的方法。加法表示法把觀測拆成三部分:
y(t) = T(t) + S(t) + R(t)
T:較慢的趨勢成分
S:季節成分
R:扣除前兩者後的餘項
分解讓我們分開看變動,但「分得漂亮」不等於已經能預測。STL 本身不是完整的未來預測規則;還需要決定趨勢與餘項怎麼向外延伸,季節成分如何重複。官方另示範 STLForecast,但本文程式沒有執行它。
同樣要守住時間界線:描述一整段已觀察資料,可以對整段做分解;模擬過去某個起點的預測,卻不能先把其後的資料放進平滑,再把得到的趨勢當成當時已知的特徵。
差分是在改寫要建模的變化,不是把資料縮放
若序列水準一直移動,直接套用假設穩定水準的模型可能不合適。普通一階差分改看「這一步比前一步多多少」;季節差分則改看「比上一輪同位置多多少」。
普通一階差分:Δy(t) = y(t) - y(t-1)
週期 m 的一階季節差分:Δm y(t) = y(t) - y(t-m)
假設每步固定增加 0.4,普通差分會把線性成長變成常數 0.4,但季節起伏仍在。若每十二步的季節形狀完全重複,lag-12 差分可以消去那部分形狀,留下十二步的水準變化和其他擾動。本文手設資料的 lag-12 差分第一筆就是 6.8,而不是零,因為同季節位置仍有趨勢與擾動差異。
差分後的值與原始水準是不同目標。若我們預測的是差分,最後必須把差分累積回去,才是顧客要的未來銷量;也不能拿差分 MAE 與原始銷量 MAE 混在一起比較。下面 ARIMA 的 API 會在原始輸入尺度上輸出預測,本例分數也都在原始尺度上算。
常見的「弱平穩」要求有限二階動差、平均數不隨時間變、共變異只依賴時間差而非絕對位置;因此變異數也固定。它不代表每個值都差不多,更不代表各期獨立。差分是讓某些非平穩序列較適合建模的一種工具,並不是套上去就保證平穩;差過頭也可能引入不必要的結構。
實務上會一起看時間圖、差分後的圖、相關結構與適當檢定,也要留意結構轉變。本文沒有執行平穩性檢定,不把教學序列的設計當成統計檢定結果。
AR 與 MA 分別記住什麼?
先把要建模的平穩序列寫成 x(t)。AR 使用它過去的值;MA 使用當期與過去的 innovation,也就是在模型資訊下新出現、未被過去預測到的擾動。
AR(1):x(t) = c + φ x(t-1) + ε(t)
MA(1):x(t) = μ + ε(t) + θ ε(t-1)
AR 的直覺是狀態延續:上一期偏高,這一期可能仍偏高。以適當的零均值創新假設來看,AR(1) 的弱平穩條件是 |φ|<1;更高階則要檢查相應特徵多項式的根,不能只逐一要求係數小於一。
MA 的「moving average」容易誤導。它不是把最近三期觀察值取平均的 rolling mean。rolling mean 是直接計算觀察值的平滑;MA 模型則透過潛在創新及其滯後組成序列。創新需要由模型推論,並不是資料表原本就有一欄可以直接拿來用。可逆性還關係到能否用過去觀察穩定地表達這些創新。
ARIMA 把差分與這兩種依賴結構接起來:
例如 ARIMA(1,1,0) 先做一次普通差分,再用一階 AR 結構描述變化;ARIMA(0,1,1) 則用一次普通差分與一階 MA。季節模型常寫成 SARIMA(p,d,q)(P,D,Q)m,季節項處理間隔 m 的結構;它與先用 STL 拆出季節成分,是不同建模方式。
還有一個容易漏掉的選擇:有沒有常數、漂移或時間趨勢?本文兩個 ARIMA 都設 trend="n",沒有額外的確定性漂移項。因此,資料雖然被我們設計成每步成長 0.4,模型沒有直接拿到這個成長公式。做了一階差分,不等於自動加入固定成長率。
ACF、PACF 是縮小候選範圍的線索
ACF 看序列與它滯後 h 步的線性相關。PACF 則在控制中間滯後值後,看這個滯後還剩多少線性關聯。
在符合條件的理論模型裡,純 AR(p) 的 PACF 在 p 之後截尾,純 MA(q) 的 ACF 在 q 之後截尾;另一種相關函數通常拖尾。這些理論型態能幫我們提出候選,但有限樣本不會整齊地把所有後續相關都畫成零。混合 ARMA、季節性、趨勢、樣本少或模型變動,都會讓判讀困難。
圖 4 的陰影也要看清定義:官方預設 alpha=.05,原資料 ACF 的標準誤使用 Bartlett 公式,並非所有 lag 都用相同的白雜訊近似帶。這類逐 lag 的區間不是「整張圖同時有 95% 把握都不出界」;看很多個 lag,自然增加偶然出現尖峰的機會。
因此,選 p、q 不能變成「最後一個出界的棒子就是答案」。NIST 的 Box–Jenkins 模型識別說明也區分理論型態與樣本判讀,指出混合模型尤其難識別。ACF/PACF、資訊準則與領域知識可以產生候選,最後仍要在同一時間預測任務上驗證。
殘差診斷與預測區間,各自回答不同問題
擬合後如果殘差還有明顯季節或自相關,代表模型可能漏掉可利用的結構。Ljung–Box 檢定會針對選定的一組 lag,檢查是否有聯合自相關的證據;對擬合模型的殘差還要考慮模型自由度。
沒有拒絕虛無假設,不代表已證明獨立、常態或模型正確,更不能替代未來資料上的預測評估。反過來,MAE 較低的模型也未必有校準好的區間。本文程式保存擬合警告與預測,但沒有執行 Ljung–Box、殘差 ACF 或區間覆蓋率實驗。
本文程式的 get_forecast 也產生模型式 95% 預測區間:在指定模型及估計參數的條件下,針對每一個未來觀測時間點計算。它不是整條未來路徑同時落入的 95% 保證,也沒有完整納入參數估計與模型選擇的不確定性。更不能因為 API 設 alpha=.05,就宣稱在這條人工序列上已實證達到 95% 覆蓋率。
例如最後一折 ARIMA(1,1,0) 的第一步區間約 [116.25,126.89],第十二步約 [44.07,173.84]。區間隨步數變寬,呈現這個模型的誤差累積方式;它不會自動處理未來新政策、停業或季節模式改變。
實作:先用兩個起點選模型,才打開最後十二點
我們建立 96 點人工資料。它包含每步 0.4 的線性成長、一輪十二步的季節形狀與一輪五步的小擾動。後者也是確定數字,不是抽樣雜訊。這讓切分與基線都能手算,但也意味著作者事先知道資料設計;這不是盲測。
四個候選與週期都預先固定,不做自動選階:最後值、季節 naive、沒有漂移的 ARIMA(1,1,0)、沒有漂移的 ARIMA(0,1,1)。切分使用從零開始的索引:
| 用途 | 當時可見的訓練點 | 一次預測的十二點 |
|---|---|---|
| 驗證一 | 0–59 | 60–71 |
| 驗證二 | 0–71 | 72–83 |
| 最後評估 | 0–83 | 84–95 |
每一段的十二個預測都在起點一次產生,不會拿到段內實際值後逐日更新。第二折訓練包含第一折已經過去的驗證資料,符合擴張起點的模擬;但兩折訓練大量重疊,所以不能當成兩份獨立樣本做簡單推論。
評分用 MAE,即每點絕對誤差的平均。兩折都十二點,因此先算各折 MAE 再平均,和二十四點一起平均相同。先依這個驗證平均選模型,再計算最後區段的所有候選分數;最後結果只是公開比較,不回頭改選擇。
以下是實際執行環境。外部教學圖是 statsmodels 0.14.0;這支程式實際執行的是 0.14.2,兩者不冒充同一次實驗。
Python 3.10.12
numpy 1.26.3
pandas 2.2.2
scipy 1.14.0
statsmodels 0.14.2
在已有上述套件的 Python 環境,把下方完整程式存成檔案,再執行:
python3 chronological_forecasts.py > stdout.json
若另建環境,可依下列版本準備依賴;本文驗證的是既有環境的實際執行,沒有宣稱在每個平台全新安裝都已測試。最佳化與浮點差異也可能讓不同環境末位數字略有變動。
numpy==1.26.3
pandas==2.2.2
scipy==1.14.0
statsmodels==0.14.2
"""Original deterministic teaching series; actual statsmodels ARIMA fits.

Validation uses two expanding origins; the final block never selects a model.
The signal is hand-specified, not a random sample or a forecasting benchmark.
"""
import json
import platform
import warnings

import numpy as np
import pandas as pd
import scipy
import statsmodels
from statsmodels.tsa.arima.model import ARIMA


PERIOD = 12
HORIZON = 12
PATTERN = (-10, -8, -4, 0, 4, 8, 12, 14, 10, 4, -4, -8)
DISTURBANCE = (-1, 0, 1, 0, -1)
SERIES = [100 + 0.4 * t + PATTERN[t % PERIOD] + DISTURBANCE[t % 5]
          for t in range(96)]
CANDIDATES = ("last_value", "seasonal_naive", "ARIMA(1,1,0)", "ARIMA(0,1,1)")


def forecast(history, name):
    """Accept history only: future observations are not an input."""
    history = np.asarray(history, dtype=float)
    if name == "last_value":
        return np.repeat(history[-1], HORIZON), None, None, []
    if name == "seasonal_naive":
        assert len(history) >= PERIOD and HORIZON <= PERIOD
        return history[-PERIOD:][:HORIZON].copy(), None, None, []
    order = {"ARIMA(1,1,0)": (1, 1, 0), "ARIMA(0,1,1)": (0, 1, 1)}[name]
    with warnings.catch_warnings(record=True) as recorded:
        warnings.simplefilter("always")
        fitted = ARIMA(history, order=order, trend="n",
                       enforce_stationarity=True, enforce_invertibility=True).fit()
        prediction = fitted.get_forecast(steps=HORIZON)
        mean = np.asarray(prediction.predicted_mean)
        interval = np.asarray(prediction.conf_int(alpha=0.05))
    assert fitted.mle_retvals.get("converged", False), name
    assert np.isfinite(mean).all() and np.isfinite(interval).all()
    assert (interval[:, 0] <= mean).all() and (mean <= interval[:, 1]).all()
    return mean, interval, dict(zip(fitted.param_names, map(float, fitted.params))), [
        str(item.message) for item in recorded]


def mae(truth, predicted):
    return float(np.mean(np.abs(np.asarray(truth) - np.asarray(predicted))))


def numbers(values):
    return np.round(np.asarray(values), 8).tolist()


def main():
    validation = []
    for origin in (60, 72):
        history = SERIES[:origin]
        truth = SERIES[origin:origin + HORIZON]
        assert len(history) == origin and len(truth) == HORIZON
        for name in CANDIDATES:
            predicted, _, parameters, messages = forecast(history, name)
            validation.append({"origin": origin, "training_indices": [0, origin - 1],
                "forecast_indices": [origin, origin + HORIZON - 1], "model": name,
                "forecast": numbers(predicted), "truth": numbers(truth),
                "MAE": mae(truth, predicted), "parameters": parameters,
                "warnings": messages})
    scores = {name: float(np.mean([r["MAE"] for r in validation if r["model"] == name]))
              for name in CANDIDATES}
    selected = min(CANDIDATES, key=lambda name: (scores[name], CANDIDATES.index(name)))
    # Freeze the selection before evaluating any final-block errors.
    final_origin = 84
    final = []
    for name in CANDIDATES:
        predicted, interval, parameters, messages = forecast(SERIES[:final_origin], name)
        truth = SERIES[final_origin:final_origin + HORIZON]
        row = {"model": name, "selected_using_validation_only": name == selected,
            "training_indices": [0, final_origin - 1], "forecast_indices": [84, 95],
            "forecast": numbers(predicted), "truth": numbers(truth),
            "MAE": mae(truth, predicted), "parameters": parameters, "warnings": messages}
        if interval is not None:
            row["model_based_95_percent_prediction_interval"] = numbers(interval)
            row["interval_scope"] = (
                "Conditional on this fitted ARIMA specification and estimated parameters; "
                "not simultaneous coverage, a confidence band for the mean, or validated "
                "95% real-world coverage on this deterministic teaching signal.")
        final.append(row)
    first_difference = np.diff(SERIES[:60])
    seasonal_difference = np.asarray(SERIES[12:60]) - np.asarray(SERIES[:48])
    print(json.dumps({"scope": "Hand-set deterministic 96-point series; actual ARIMA fitting, "
        "two-origin fixed-horizon validation, then one untouched final block. No RNG, "
        "external dataset, hyperparameter search, or claim of general model superiority.",
        "versions": {"python": platform.python_version(), "numpy": np.__version__,
            "pandas": pd.__version__, "scipy": scipy.__version__,
            "statsmodels": statsmodels.__version__},
        "series": numbers(SERIES), "period": PERIOD, "horizon": HORIZON,
        "ordinary_first_differences_first_12": numbers(first_difference[:12]),
        "seasonal_lag12_differences_first_12": numbers(seasonal_difference[:12]),
        "validation": validation, "mean_validation_MAE": scores,
        "selected_before_final_evaluation": selected, "final_block": final,
        "limits": ["The final block is evaluated once and never used for model selection.",
            "Each forecast block is predicted entirely from its origin; no rolling test updates.",
            "Overlapping training histories mean validation folds are not independent samples.",
            "Period and candidate orders were fixed as part of this teaching design.",
            "Residual diagnostics, structural changes, calibrated intervals and external validation "
            "would be needed for a real application."]}, ensure_ascii=False, indent=2))


if __name__ == "__main__":
    main()
執行會輸出 JSON,包括完整序列、每折逐點預測、擬合參數、警告與最後兩個 ARIMA 的逐點區間。下面是保存輸出的選模欄位,不是另外假設的結果:
{
  "mean_validation_MAE": {
    "last_value": 12.616666666666667,
    "seasonal_naive": 4.883333333333334,
    "ARIMA(1,1,0)": 21.83562687316268,
    "ARIMA(0,1,1)": 12.146798720884515
  },
  "selected_before_final_evaluation": "seasonal_naive"
}
| 固定候選 | 驗證一 MAE | 驗證二 MAE | 驗證平均 | 最後十二點 MAE |
|---|---|---|---|---|
| 最後值 | 13.1167 | 12.1167 | 12.6167 | 12.2333 |
| 季節 naive | 4.8000 | 4.9667 | 4.8833 | 4.5500 |
| ARIMA(1,1,0) | 25.1191 | 18.5522 | 21.8356 | 23.9471 |
| ARIMA(0,1,1) | 12.9396 | 11.3540 | 12.1468 | 12.6941 |
選中的是季節 naive。最後起點的最後值為 125.2,所以 naive 十二步都不變;季節 naive 複製的第一步是 119.8,下一步是 121.2,十二步最後又是 125.2。這個差異能直接看出:季節基線保留的是形狀,最後值基線保留的是當前水準。
此例季節基線的優勢有清楚原因:資料真的被設計成反覆出現十二步形狀,而兩個 ARIMA 都沒有季節項,也沒有確定性漂移。這不能推成 ARIMA 整個模型家族不如基線,更沒有比較 SARIMA、STLForecast 或其他階數。現實中若要新增候選,應回到驗證流程,不能反覆查看最後區段直到挑到好看的結果。
六次 ARIMA 擬合都回報收斂,但三次 ARIMA(0,1,1) 各自保存了一個警告:
Non-invertible starting MA parameters found. Using zeros as starting parameters.
這表示初始 MA 參數不可逆,套件改用零作為起始值再最佳化;不是說最後 MA 係數為零,也不是三次都沒收斂。程式把警告寫進 JSON,因此不能因終端 stderr 沒字就說沒有警告。遇到這類訊息,要同時查看最終參數、收斂、診斷與預測表現。
真正可遷移到工作上的順序,是先確認每個起點有哪些可見資訊,訂出要交付的步數,再讓簡單基線和合理候選接受同一種評估。ARIMA 的階數、殘差與區間都能提供額外判斷;它們的價值建立在這個時間問題先定義正確。
來源與圖像授權
本文新增的部分是 96 點人工序列、相同十二步的兩起點驗證、凍結後的最後評估,以及完整程式與逐點結果。五張外部圖各自保留來源情境,沒有把來源 notebook 的執行結果當成本站重跑。
- scikit-learn:時間切分說明、四折圖與完整範例程式、1.5.2 原版 BSD 3-Clause。
- statsmodels 0.14.0:完整 STL notebook、人工 ARMA notebook、ACF 定義與 Bartlett 區間、原版 Modified BSD 授權。
- statsmodels:ARIMA 模型 API、預測 API。前兩項連到目前可查的 stable 文件,不冒稱網站文件與執行版本完全相同;本文實際執行與核對的 installed source/docstrings 為 0.14.2。另見 Ljung–Box 與 model_df 定義(0.14.0)。
- NIST/SEMATECH:季節性、Box–Jenkins 識別、ACF 與不相關不等於獨立。本文使用文字方法脈絡,未重刊這些頁面的圖。
以下保留圖片署名、改作與兩份原版 BSD 授權全文。
DS60 IMAGE ATTRIBUTION NOTICE

Figure 1: scikit-learn developers, scikit-learn 1.5.2 documentation example `plot_cv_indices`, TimeSeriesSplit panel, https://scikit-learn.org/1.5/auto_examples/model_selection/plot_cv_indices.html. BSD 3-Clause. Main image copied unchanged. Mobile version shows the complete source first, then the full original panel crop [0,0,435,290] enlarged to 600px (retaining title, both axes/labels/ticks, split bars, and class/group rows); the complete legend crop [425,25,565,85] is enlarged to 360px and centered. The panel crop includes the first 10 source pixels of a legend color patch at its right edge so the final “100” tick remains complete; the complete legend follows separately. Coordinates are half-open in the original 600x300 source. No content added.

Figures 2–3 and cover: statsmodels developers, statsmodels 0.14.0 documentation notebook, “STL: Seasonal-Trend decomposition using LOESS,” https://www.statsmodels.org/v0.14.0/examples/notebooks/generated/stl_decomposition.html. Modified BSD 3-Clause. Figure 2 source PNG copied unchanged. Figure 3 is the source Trend and Seasonal output only, from the same seeded 2,000-point synthetic series with period 100; it is not a four-panel decomposition. Cover fits the complete Figure 2 on a white 1600x900 canvas without additional text or marks.

Figure 4: statsmodels developers, statsmodels 0.14.0 `plot_acf` API example, https://www.statsmodels.org/v0.14.0/generated/statsmodels.graphics.tsaplots.plot_acf.html. Modified BSD 3-Clause for the chart/page. The underlying statsmodels sunspots metadata separately states that its 309 annual observations for 1700–2008 are public domain and identifies NOAA NGDC; that data statement is separate from chart/page licensing. This is a raw-series ACF, not fitted residuals.

Figure 5: statsmodels developers, statsmodels 0.14.0 artificial-data ARMA notebook (`tsa_arma_1`), https://www.statsmodels.org/v0.14.0/examples/notebooks/generated/tsa_arma_1.html. Modified BSD 3-Clause. The source image is copied unchanged. It uses a seeded synthetic 250-month ARMA(2,2) sequence, fits ARIMA(2,0,2), and shows a 95% interval over 17 in-sample prediction points and 7 future points. It is not prototype output or empirical coverage evidence.

FPP3 and NIST/SEMATECH figures are not reproduced.

--- scikit-learn 1.5.2 BSD 3-Clause license (verbatim) ---

BSD 3-Clause License

Copyright (c) 2007-2024 The scikit-learn developers.
All rights reserved.

Redistribution and use in source and binary forms, with or without
modification, are permitted provided that the following conditions are met:

* Redistributions of source code must retain the above copyright notice, this
  list of conditions and the following disclaimer.

* Redistributions in binary form must reproduce the above copyright notice,
  this list of conditions and the following disclaimer in the documentation
  and/or other materials provided with the distribution.

* Neither the name of the copyright holder nor the names of its
  contributors may be used to endorse or promote products derived from
  this software without specific prior written permission.

THIS SOFTWARE IS PROVIDED BY THE COPYRIGHT HOLDERS AND CONTRIBUTORS "AS IS"
AND ANY EXPRESS OR IMPLIED WARRANTIES, INCLUDING, BUT NOT LIMITED TO, THE
IMPLIED WARRANTIES OF MERCHANTABILITY AND FITNESS FOR A PARTICULAR PURPOSE ARE
DISCLAIMED. IN NO EVENT SHALL THE COPYRIGHT HOLDER OR CONTRIBUTORS BE LIABLE
FOR ANY DIRECT, INDIRECT, INCIDENTAL, SPECIAL, EXEMPLARY, OR CONSEQUENTIAL
DAMAGES (INCLUDING, BUT NOT LIMITED TO, PROCUREMENT OF SUBSTITUTE GOODS OR
SERVICES; LOSS OF USE, DATA, OR PROFITS; OR BUSINESS INTERRUPTION) HOWEVER
CAUSED AND ON ANY THEORY OF LIABILITY, WHETHER IN CONTRACT, STRICT LIABILITY,
OR TORT (INCLUDING NEGLIGENCE OR OTHERWISE) ARISING IN ANY WAY OUT OF THE USE
OF THIS SOFTWARE, EVEN IF ADVISED OF THE POSSIBILITY OF SUCH DAMAGE.

--- statsmodels 0.14.0 Modified BSD 3-Clause license (verbatim) ---

Copyright (C) 2006, Jonathan E. Taylor
All rights reserved.

Copyright (c) 2006-2008 Scipy Developers.
All rights reserved.

Copyright (c) 2009-2018 statsmodels Developers.
All rights reserved.


Redistribution and use in source and binary forms, with or without
modification, are permitted provided that the following conditions are met:

  a. Redistributions of source code must retain the above copyright notice,
     this list of conditions and the following disclaimer.
  b. Redistributions in binary form must reproduce the above copyright
     notice, this list of conditions and the following disclaimer in the
     documentation and/or other materials provided with the distribution.
  c. Neither the name of statsmodels nor the names of its contributors
     may be used to endorse or promote products derived from this software
     without specific prior written permission.


THIS SOFTWARE IS PROVIDED BY THE COPYRIGHT HOLDERS AND CONTRIBUTORS "AS IS"
AND ANY EXPRESS OR IMPLIED WARRANTIES, INCLUDING, BUT NOT LIMITED TO, THE
IMPLIED WARRANTIES OF MERCHANTABILITY AND FITNESS FOR A PARTICULAR PURPOSE
ARE DISCLAIMED. IN NO EVENT SHALL STATSMODELS OR CONTRIBUTORS BE LIABLE FOR
ANY DIRECT, INDIRECT, INCIDENTAL, SPECIAL, EXEMPLARY, OR CONSEQUENTIAL
DAMAGES (INCLUDING, BUT NOT LIMITED TO, PROCUREMENT OF SUBSTITUTE GOODS OR
SERVICES; LOSS OF USE, DATA, OR PROFITS; OR BUSINESS INTERRUPTION) HOWEVER
CAUSED AND ON ANY THEORY OF LIABILITY, WHETHER IN CONTRACT, STRICT
LIABILITY, OR TORT (INCLUDING NEGLIGENCE OR OTHERWISE) ARISING IN ANY WAY
OUT OF THE USE OF THIS SOFTWARE, EVEN IF ADVISED OF THE POSSIBILITY OF SUCH
DAMAGE.
留言0
登入後就能留言。
登入