
梯度告訴你目前參數附近,損失朝哪個方向增加;優化器決定收到梯度之後,怎麼更新參數。SGD使用當下的梯度,Momentum保留過去的方向,Adam同時保留方向與梯度大小的歷史,調整各座標的更新量。
上一篇反向傳播已算出每個權重的梯度。接下來不必重新推導整個網路,只要把「梯度如何取得」與「梯度如何轉成更新」拆開,就能理解這幾種方法的關係。
本文先看D2L教材的既有原圖,再用本站的二參數函數,把手寫更新式與PyTorch逐步對照。教材曲線是來源實驗;本站程式只驗證自己的20次更新,沒有重跑教材的Airfoil訓練。
一次看全部資料,或只看一部分?
假設訓練集有N筆資料,每筆損失為l_i(theta),整體目標取平均:
L(theta) = (1/N) * sum_i l_i(theta)
g_full = (1/N) * sum_i grad l_i(theta)
theta_new = theta - learning_rate * g_full
這是full-batch gradient descent:算完全部資料的平均梯度,才更新一次。資料量大時,每一步都需要處理很多樣本。
SGD最狹義的做法,是每一步均勻隨機抽一筆資料,用那一筆的梯度更新。Mini-batch則一次取一小批,先平均梯度再更新。實務上也常把mini-batch的做法一起稱為SGD,因此看到這個名稱,還要問batch size是多少。
| 方法 | 一次更新使用的梯度 | 讀完一輪資料的更新次數,假設N可整除B |
|---|---|---|
| Full-batch GD | 全部N筆的平均 | 1次 |
| 單樣本SGD | 一筆資料的梯度 | N次 |
| Mini-batch SGD | B筆資料的平均 | N/B次 |
Epoch是讀完一輪資料,step是更新一次參數。 同樣訓練2個epoch,batch=1與batch=100的更新次數差100倍;把橫軸都寫epoch,不代表計算成本或更新機會一樣。
先用一個小例子看「抽一筆」會發生什麼。兩個目標值是−1與+1,模型只有參數theta,每筆損失為0.5*(theta-y)²。在theta=0時:
平均梯度已是0,但抽到任一筆仍可能往左或往右走。這沒有矛盾:在固定theta、均勻抽樣的條件下,單筆梯度的期望等於完整平均梯度,不表示每次抽到的梯度都一樣。
圖1|D2L SGD章的原始教學圖,f=x1²+2x2²,梯度兩個座標各加標準常態噪聲,learning rate=0.1、50步。橘色是參數軌跡,藍色是等高線;到原點附近仍有擺動。這是模擬帶噪梯度,不是抽樣真實資料的訓練,也不是本站兩個目標值例子的輸出。來源:D2L,CC BY-SA 4.0;原SVG完整轉PNG。
在資料訓練裡,噪聲來自用部分資料估計全體梯度;圖1則直接加噪聲,幫你看清路徑可能如何擺動。不能只憑一張軌跡圖,宣稱SGD必定跳出局部極小值,或訓練越久一定越準。
還有一項條件常被省略:均勻獨立抽樣、固定參數時的無偏估計,與每個epoch打亂順序、不放回走完資料,並非完全相同的機率模型。後者很常用,但走到某一批時,參數已被前面批次改過,不能無條件套用每一步都獨立同分布的推導。
Batch不只影響噪聲,也影響電腦怎麼工作
獨立樣本梯度取平均時,每個座標平均梯度的變異數會隨batch size B降為原來的1/B,標準差則為1/sqrt(B)。這個簡單關係需要獨立抽樣等條件;不放回抽樣有有限母體修正,樣本相關也會改變結果。
另一面是計算:把多筆資料排成矩陣,往往能更有效利用矩陣運算,減少逐筆呼叫的額外成本。但batch持續加大,可能超出記憶體,也會改變每個epoch的更新次數。它同時是統計與工程選擇。
圖2|左至右/手機上至下:D2L Airfoil線性回歸原始曲線,依序為batch=1500、lr=1、10 epochs;batch=1、lr=0.005、2 epochs;batch=100、lr=0.4、2 epochs。縱軸是教材的訓練半平方誤差平均,橫軸epoch範圍不同。三張完整原圖編排;它們使用不同步長、隨機初始化及資料順序,並非只改batch的控制實驗。圖:D2L CC BY-SA 4.0;資料:Brooks、Pope、Marcolini/NASA與UCI,CC BY 4.0。
這組圖值得讀的地方,是「讀過多少資料」與「更新幾次」並不是同一件事。來源使用前1500筆做線性回歸,先對原資料各欄減平均、除標準差,連目標值也標準化。這是逐欄標準化,沒有把特徵相關性全部消除。曲線不是原始dB單位的預測誤差,也沒有提供獨立測試集的泛化結論。
圖3|D2L把GD、單樣本SGD、batch=100與batch=10的來源訓練曲線放到時間軸。橫軸是秒數的對數刻度;batch=10另用lr=0.05、2 epochs,其餘設定見圖2。整張原圖轉PNG,保留曲線與圖例。機器、實作、評估成本、學習率及更新次數都會影響結果,不能據此宣布某個batch普遍最快。圖:D2L CC BY-SA 4.0;Airfoil資料CC BY 4.0。
所以比較實驗前,要先決定預算:相同epoch、相同步數,還是相同時間?再說清楚每種方法是否各自調過learning rate。若問題是部署前哪個模型較好,還要沿用公平比較的驗證集與測試集分工。
學習率決定走多遠,曲率讓各方向不同步
先暫時拿掉資料抽樣,只看D2L的一個二維函數:
f(x1, x2) = 0.1*x1² + 2*x2²
grad f = (0.2*x1, 4*x2)
GD:
  x1_new = (1 - 0.2*eta)*x1
  x2_new = (1 - 4*eta)*x2
這裡x1方向平緩,x2方向陡。同一個eta乘在兩個方向,效果差很多。
圖4|D2L Momentum章的普通GD原圖,f=0.1x1²+2x2²,eta=0.4、20次更新。x2每步乘−0.6,正負符號交替、幅度縮小;x1每步乘0.92,縮得較慢。這裡的係數與圖1不同,不能把兩條路徑當成同一函數比較。來源:D2L CC BY-SA 4.0;完整原圖轉PNG。
對單一方向的二次函數f(x)=0.5lambdax²,GD每一步把x乘上1−eta*lambda。當lambda為正且0 < eta*lambda < 2,幅度會縮小。乘數為負時是衰減震盪,不等於已經發散;絕對值大於1才會越跳越遠。
把上例eta提高為0.6,x2乘數就成了−1.4;x1雖然移動較快,x2卻失控。這個簡單算式解釋了為什麼「步長加大」不能只看某個方向的進展。
Momentum:把歷史梯度留下來
普通GD每次只看當下的g_t。Momentum多維護一個與參數同形狀的velocity,本篇採以下約定:
v_0 = 0
v_t = beta*v_(t-1) + g_t
theta_t = theta_(t-1) - eta*v_t
若連續幾次梯度方向相近,歷史項會累積;若某個方向的梯度正負來回,則可能互相抵銷。這有助於理解動量,但不是保證每一步損失下降的定理。保留過去的方向,也可能讓參數越過最低點,再擺回來。
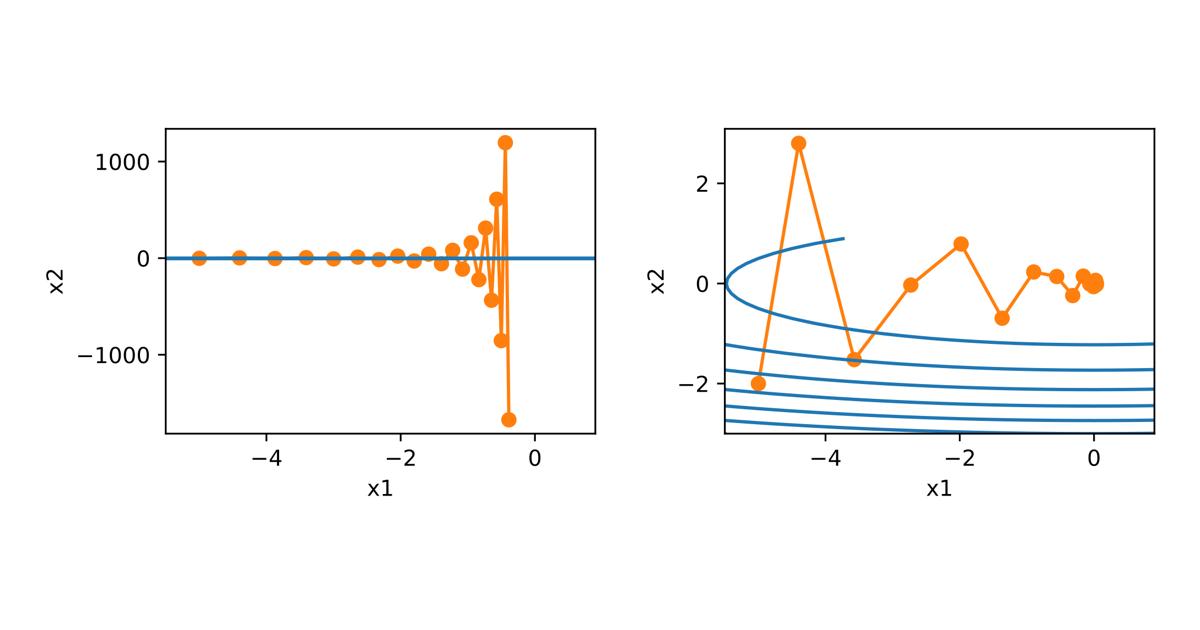
圖5|D2L同一函數f=0.1x1²+2x2²、eta=0.6、20步:左/上是普通GD;右/下是beta=0.5的Momentum。注意兩張原圖的x2刻度不同:GD已到千的量級,Momentum仍在個位數附近;不能只比線條在圖面上的高度。圖保留完整座標軸與原曲線,桌機並排、手機上下排。來源:D2L CC BY-SA 4.0。
Beta控制歷史衰減。在上面的未正規化累積式裡,往前k步的梯度權重是beta^k。beta越接近1,較久以前的梯度保留得越多。
圖6|D2L繪出的beta^k,k=0到39,beta依序為0.95、0.90、0.60、0。來源圖橫軸寫time,這裡讀成梯度的落後步數;縱軸是歷史係數,並非loss或準確率。來源:D2L CC BY-SA 4.0;完整原圖轉PNG。
這裡有一個實作差異要留意。有些說明把Momentum寫成「beta*v+(1−beta)g」,那是正規化的指數移動平均;本篇則使用「betav+g」。固定beta、零初始化時,兩者velocity相差1−beta倍,若要得到相同參數路徑,learning rate也要對應調整。
假設梯度始終固定為g,本篇的v_t才會逐漸接近g/(1−beta)。不能把這個特殊極限說成任何時候都把實際步長放大同一倍,更不能把1/(1−beta)當成真的多讀了幾筆獨立樣本。
從Adagrad看懂「每個座標的尺度」
動量處理歷史方向;另一個問題是不同參數的梯度尺度。如果某個座標長期出現很大的梯度,能不能降低它的更新倍率?Adagrad的做法是累積每個座標的梯度平方。
s_t = s_(t-1) + g_t²
theta_t = theta_(t-1) - eta*g_t / sqrt(s_t + epsilon)
以上採D2L此章的epsilon位置,平方、開根號與除法都逐座標做。s越大,該座標的有效倍率越小。這不是計算完整Hessian,也不是每個座標都用完全相同的縮放。
圖7|D2L Adagrad原圖,函數同圖4,左/上eta=0.4,右/下eta=2,source epsilon=1e−6、20步。累積平方梯度改變各座標步幅;較大eta在這個例子走得更遠,不代表任何任務都應使用eta=2。兩張完整原圖只做編排,沒有修改曲線或刻度。來源:D2L CC BY-SA 4.0。
Adagrad的累積平方不會減少,因此早期累積很大的座標,後面仍保有那份歷史。若倍率縮得過快,後段移動可能很慢。RMSProp改用平方梯度的指數移動平均,讓舊的平方梯度也會逐步淡出;Adam再把這種尺度調整與梯度方向的移動平均合在一起。
Adam的兩份記憶與偏差校正
Adam維護兩個狀態,這裡用m代表一階動差估計,v代表二階動差估計。此處v不是前一節Momentum的velocity。
m_0 = 0, v_0 = 0
m_t = beta1*m_(t-1) + (1-beta1)*g_t
v_t = beta2*v_(t-1) + (1-beta2)*g_t²
m_hat = m_t / (1-beta1^t)
v_hat = v_t / (1-beta2^t)
theta_t = theta_(t-1) - eta*m_hat / (sqrt(v_hat) + epsilon)
m記錄梯度方向的加權平均;v記錄梯度平方的加權平均。v是未中心化的二階動差估計,不是梯度變異數,也不是Hessian。除以sqrt(v_hat)後,各座標會依自己的歷史尺度調整;仍然有共同的基礎learning rate eta。
為什麼要除以1−beta^t?從0開始時,早期累積的權重總和還不足1。若第一步梯度是g,beta1=0.9、beta2=0.999:
因此第一次更新約為−eta*sign(g),當g相對epsilon夠大時,各非零座標的步幅大致接近eta。這也提醒你:Adam的eta=0.01,與普通GD的eta=0.01,不能解讀成相同的實際位移。
偏差校正補的是零初始化造成的早期權重總和不足;對隨時間變動的梯度,不能因此宣稱得到當前梯度或變異數的完美無偏估計。Adam也不保證任意目標與步長下都收斂。
圖8|D2L Adam章的手寫Adam教學輸出,Airfoil、batch=10、lr=0.01、2 epochs;手寫source使用beta1=0.9、beta2=0.999、epsilon=1e−6。這是Adam原圖,不是同章後面的Yogi曲線,也不是本站20步算例。縱軸是標準化目標的訓練半平方誤差,並非測試準確率。圖:D2L CC BY-SA 4.0;Airfoil資料:Brooks、Pope、Marcolini/NASA與UCI CC BY 4.0。
實作時要把epsilon的位置與數值看清楚。本篇Adam算例使用sqrt(v_hat)+1e−8,與圖8來源手寫版的epsilon不同;也不要把Adagrad章的sqrt(s+epsilon)直接搬進Adam,再期待逐步結果完全相同。
實跑20步,核對你理解的更新式
下面不用神經網路,也沒有隨機抽樣。目標是把優化器本身看清楚:
L(theta) = 0.5*(9*theta[0]² + theta[1]²)
grad L = (9*theta[0], theta[1])
初始theta = (2, -2)
三種方法的基礎learning rate = 0.05
起點loss是20。第一步梯度為(18,−2),普通GD更新到(1.1,−1.9),loss=7.25。Momentum零初始化,所以第一步相同。Adam偏差校正後,兩個座標的更新幅度都約為0.05,走到約(1.95,−1.95),loss約19.0125。
這不是Adam比較差的證明:這個二次函數、起點、步數與相同raw learning rate,刻意用來展示更新式的差異,沒有為每種方法公平調參,也沒有測時間或測泛化。
本次實跑環境為WSL、Python 3.10.12、NumPy 1.26.3、PyTorch 2.3.1+cu118,運算明確放在CPU、float64;套件名稱含CUDA不代表使用GPU。讀者可在獨立環境安裝對應NumPy與PyTorch版本,將下列程式存為optimizer_updates.py後以python optimizer_updates.py執行。
import numpy as np
import torch

print(f"numpy={np.__version__} torch={torch.__version__} device=cpu dtype=float64")
# Deterministic full-batch quadratic, not a stochastic neural-network benchmark.
start = np.array([2., -2.])
curvature = np.array([9., 1.])
lr = 0.05
steps = 20

def objective(a):
    return 0.5 * np.sum(curvature * a ** 2)

for name in ["GD", "Momentum", "Adam"]:
    a = start.copy()
    velocity = np.zeros_like(a)
    m = np.zeros_like(a)
    v = np.zeros_like(a)
    p = torch.tensor(start, dtype=torch.float64, device="cpu", requires_grad=True)
    if name == "GD":
        optimizer = torch.optim.SGD([p], lr=lr, momentum=0., foreach=False)
    elif name == "Momentum":
        optimizer = torch.optim.SGD([p], lr=lr, momentum=.9, dampening=0.,
                                    nesterov=False, foreach=False)
    else:
        optimizer = torch.optim.Adam([p], lr=lr, betas=(.9, .999), eps=1e-8,
                                     weight_decay=0., amsgrad=False, foreach=False)
    all_match = True
    for t in range(1, steps + 1):
        g = curvature * a
        if name == "GD":
            a = a - lr * g
        elif name == "Momentum":
            velocity = .9 * velocity + g
            a = a - lr * velocity
        else:
            m = .9 * m + .1 * g
            v = .999 * v + .001 * g ** 2
            m_hat = m / (1 - .9 ** t)
            v_hat = v / (1 - .999 ** t)
            a = a - lr * m_hat / (np.sqrt(v_hat) + 1e-8)
        optimizer.zero_grad(set_to_none=True)
        loss = 0.5 * (torch.tensor(curvature, dtype=torch.float64) * p.square()).sum()
        loss.backward()
        optimizer.step()
        all_match = all_match and np.allclose(a, p.detach().numpy(), atol=1e-12, rtol=0)
        if t in (1, 5, 20):
            print(f"{name} step={t} theta={np.round(a, 9).tolist()} loss={objective(a):.9f}")
    print(f"{name} all20steps_match_torch={all_match}")
# At a fixed theta=0, two per-example gradients differ from their mean.
# This computes the possible gradients, not a random-sampling experiment.
targets = np.array([-1., 1.])
example_gradients = 0. - targets  # derivative of0.5*(theta-y)^2
print("per_example_gradients_at_theta0=", example_gradients.tolist())
print("full_batch_gradient_at_theta0=", float(example_gradients.mean()))
print("scope=equal raw learning rate is not a tuned fairness benchmark; full-batch paths only")
本次輸出如下。前一行版本可能因CPU/CUDA套件變體而不同;數值欄位依這份固定算例解讀。
numpy=1.26.3 torch=2.3.1+cu118 device=cpu dtype=float64
GD step=1 theta=[1.1, -1.9] loss=7.250000000
GD step=5 theta=[0.100656875, -1.547561875] loss=1.243067008
GD step=20 theta=[1.2832e-05, -0.716971845] loss=0.257024314
GD all20steps_match_torch=True
Momentum step=1 theta=[1.1, -1.9] loss=7.250000000
Momentum step=5 theta=[-1.280393125, -0.834311875] loss=7.725367648
Momentum step=20 theta=[-0.116131553, 0.242261052] loss=0.090034628
Momentum all20steps_match_torch=True
Adam step=1 theta=[1.95, -1.95] loss=19.012500001
Adam step=5 theta=[1.750633765, -1.750633766] loss=15.323592891
Adam step=20 theta=[1.040185401, -1.040185406] loss=5.409928348
Adam all20steps_match_torch=True
per_example_gradients_at_theta0= [1.0, -1.0]
full_batch_gradient_at_theta0= 0.0
scope=equal raw learning rate is not a tuned fairness benchmark; full-batch paths only
每個方法的20步都與PyTorch逐步對照,atol=1e−12、rtol=0;顯示True表示參數路徑在指定容許誤差內一致。這不是只有把最後一次loss對上。
| 方法 | 第1步loss | 第5步loss | 第20步loss |
|---|---|---|---|
| GD | 7.250000000 | 1.243067008 | 0.257024314 |
| Momentum | 7.250000000 | 7.725367648 | 0.090034628 |
| Adam | 19.012500001 | 15.323592891 | 5.409928348 |
Momentum第5步的loss比第1步還高,卻在第20步低於第5步。保留歷史並不保證每一步單調進步。Adam第一步兩座標看起來恰好都是0.05,但epsilon讓精確步幅仍有微小差異;輸出顯示的小數是四捨五入結果。
程式最後的兩筆樣本只在固定theta=0計算可能出現的梯度與平均,沒有做隨機抽樣。前面的三條路徑全部是完整確定性目標的梯度;torch.optim.SGD只是介面名稱,不能靠這個名稱把本次算例說成隨機梯度訓練。
訓練不動時,先把問題拆開
若要把這些知識帶回模型訓練,先檢查梯度、更新量與驗證損失,而不是立刻換一個優化器名稱。
PyTorch的backward()會累積梯度。本例每一步先zero_grad再對目前參數算loss、backward、step;若你有意做跨batch的梯度累積,要相應處理loss縮放與何時更新。續訓時,Momentum/Adam的狀態也屬於訓練狀態,只存模型參數再重新建立優化器,通常不會接回相同路徑。
歷史方向、座標尺度與learning rate解決的是不同問題。判讀一個optimizer設定,至少寫清楚batch size、loss的平均方式、步長、狀態初始化與訓練預算;這比只說「用了Adam」更接近一個可重現的訓練描述。
圖片來源、授權與延伸閱讀
本文8組圖皆取自《Dive into Deep Learning》的既有教學原圖,作者Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola。採用完整SVG轉白底PNG;多面板只做並排/手機直排,封面將圖5完整兩面板等比縮放加白邊。未修改曲線、座標軸、數值或新增實驗結果。圖片及上述圖像改作依CC BY-SA 4.0提供,授權依據為D2L英文書實際版本LICENSE。這項圖片授權說明不把本站獨立正文冒稱為D2L翻譯。
圖2、3、8的資料源為UCI Airfoil Self-Noise,Brooks、Pope、Marcolini(1989),NASA航空聲學資料,原資料1503筆、5個輸入特徵,UCI標示CC BY 4.0;D2L只取前1500筆作該教學訓練。本文展示教材產生的曲線,沒有重新發布原始資料或宣稱本次重跑該實驗。
- D2L:Stochastic Gradient Descent:梯度估計、帶噪路徑與步長排程。
- D2L:Minibatch SGD:batch、向量化、Airfoil處理與原始訓練設定。
- D2L:Momentum:歷史梯度、beta權重與二次函數路徑。
- D2L:Adagrad:逐座標平方梯度累積。
- D2L:Adam:兩份動差與偏差校正;Yogi是另一種方法。
- PyTorch v2.3.1 SGD實作與Adam實作:本篇逐步核對的固定版本;官方API頁若轉址,可由這兩份版本化原始碼核對設定與公式。
留言0
登入後就能留言。
登入