
Dropout在訓練時隨機遮住部分activation;Weight Decay在參數更新中加入收縮;Early Stopping依驗證表現決定何時停止。三者改變的地方不同,都需要用一致的驗證方式選擇強度,不能只看訓練loss有沒有變低。
上一篇已看過梯度如何變成參數更新。本篇接著處理另一個問題:模型繼續把訓練資料擬合得更好時,為什麼新資料的表現未必一起改善?
我們用既有教材圖理解機制,再實跑一個很小的算例。圖中的模型訓練結果屬於原教材;本站程式只核對遮罩的期望與單步更新,沒有重新訓練Fashion-MNIST,也沒有把一個toy算例當成泛化提升的證明。
Dropout遮住的是這次計算,不是永久刪除神經元
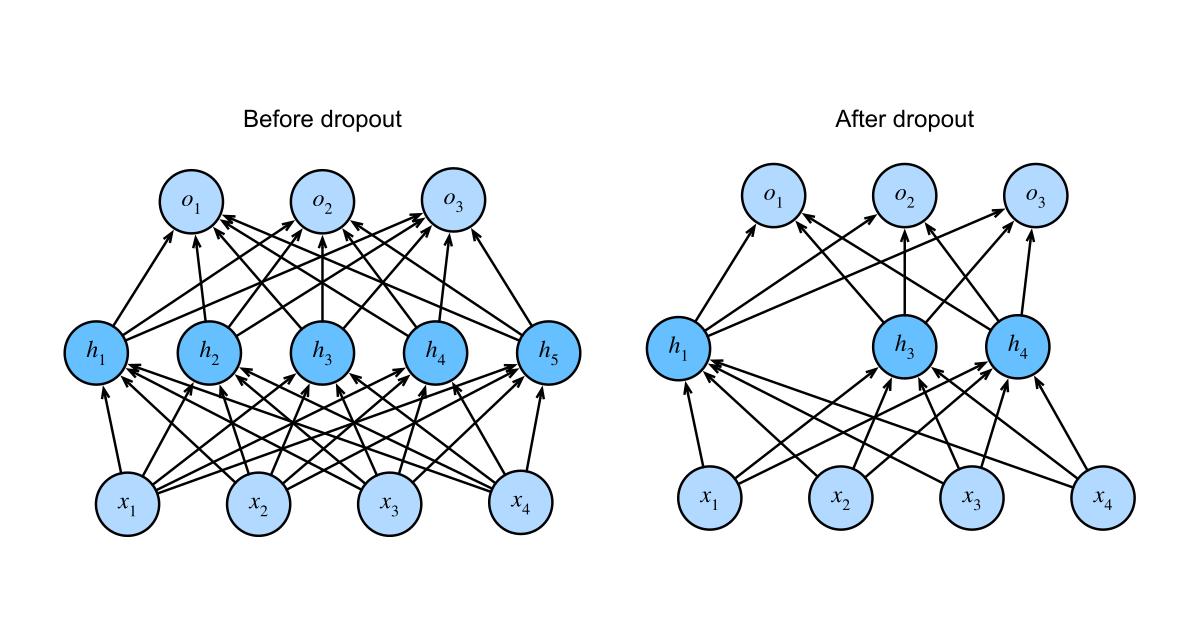
圖1|D2L原始示意圖:4個輸入、5個隱藏節點、3個輸出;右圖這一次遮住h2與h5,只留下h1、h3、h4參與前向計算。這是一張固定遮罩示意,不能從「少了2個」反推出訓練設定p=0.4。原圖完整轉PNG;手機把before/after兩個完整面板上下排,保留節點、箭頭與標籤。來源:D2L,CC BY-SA 4.0。
一般element-wise Dropout在訓練時,對選定層的activation各自抽取遮罩。某個值這次被置零,這次沿該路徑傳回的資料梯度也會被遮住;下次可以換另一個遮罩。模型的參數仍然存在,不是訓練完就永久移除圖上那些節點。
Srivastava等人在2014年的Dropout論文中,討論以隨機移除單元減少過度共同依賴。這個直覺可以幫助理解方法,但是否改善某個任務,仍要看資料、模型與驗證結果。
現在常用的是inverted dropout。令p是丟棄機率、m是保留遮罩,對固定activation h:
m = 1,機率為1-p
m = 0,機率為p
h_train = m*h/(1-p)
這裡先限定p至少為0、且小於1。保留時除以1−p,讓單個activation的期望維持為h:
E[h_train | h固定] = (1-p)*h/(1-p) + p*0 = h
Var(h_train | h固定) = p/(1-p)*h²
若h=3、p=0.4,這個值有0.6機率變成5,有0.4機率變成0,平均仍是3,變異數是6。一次前向不會等於平均值;平均保持不變,也不表示把它送過後續非線性層後,整個網路的輸出或loss期望都不變。
在這個約定下,推論時關閉Dropout,直接保留h,不再多乘一次1−p。p=1是特殊邊界,公式不能直接除以0;也不能同時要求所有值都丟掉又保持原來的非零期望。
看訓練曲線前,先問模型處在哪個模式
PyTorch的model.train()會啟用模組中相應的訓練行為;model.eval()讓Dropout在一般推論流程中不再遮罩。eval()並不等於關閉autograd,評估時是否使用no_grad()是另一件事。
如果訓練時計算的loss開著Dropout,驗證時計算的loss關閉Dropout,它們的計算條件本來就不同。再加上train數值常是在更新過程中累積,而validation是在epoch末算,驗證loss暫時低於訓練loss,不必立刻判成資料洩漏。
圖2|D2L PyTorch原圖,左/上為手寫Dropout,右/下為nn.Dropout。皆為兩個256-unit隱藏層、兩層p=0.5、SGD lr=0.1、batch=256、10 epochs。藍/橘線是來源helper聚合的train/val交叉熵,綠線另為val accuracy;三條線不是同一種量。兩個獨立模型的完整原圖編排,並非Dropout與無Dropout的控制比較。來源:D2L CC BY-SA 4.0;Fashion-MNIST資料作者與MIT聲明見文末。
這組來源還有兩個讀圖條件。第一,D2L helper將Fashion-MNIST官方test split命名為val,並不是另外從訓練資料切出的驗證集。本站沒有重做這份切分,也不能宣稱它另有一個完全未使用的最終測試集。真正需要反覆選設定時,應另外保留驗證資料,把最後測試留到評估階段。
第二,圖上的點是batch scalar的平均;最後一個batch可能較小,因此不宜把它叫作全split逐樣本精確加權平均。訓練點還混合了不同參數狀態與遮罩。這些細節不妨礙看趨勢,卻會影響你怎麼解讀兩條曲線之間的差距。
若想確認Dropout有沒有幫助,應在相同切分與評估流程下,改變p並重複實驗;不能由圖2兩種實作的曲線形狀,就宣布某個p帶來多少提升。
L2限制權重大小,但不保證權重分布長成某個形狀
第13篇已談過正則化。這裡把L2與參數更新接起來。本篇採用的目標是:
J(w) = L_data(w) + (lambda/2)*sum_j w_j²
grad J(w) = grad L_data(w) + lambda*w
L_data如果是batch平均,就先照資料loss的定義取平均,再加一次懲罰;不要把整個L2項又隨手除以batch size。其他教材也可能把係數寫成lambda而沒有1/2,對應的梯度就會差一個2,不能只比超參數名稱。
圖3|Google ML Crash Course對較強L2的權重分布示意,表達較集中於零附近的直覺。橫軸是權重值、縱軸是頻率,沒有提供本次模型的實測資料。來源:Google,CC BY 4.0;完整原SVG轉PNG。
圖4|同一Google教材對較弱L2的概念示意,分布較寬。這兩張圖不保證任何神經網路的權重一定呈常態分布、均值一定為零,或較窄就一定比較準。完整原SVG以瀏覽器轉PNG,保留原內容;來源:Google,CC BY 4.0。
L2不會像L1那樣直接以稀疏解作典型目標,但「不以製造大量精確零為主要機制」與「任何權重都不可能剛好等於零」是兩個不同說法。也別忘了特徵尺度:把輸入放大,表達相近函數所需的權重就可能變小,不能脫離模型與輸入尺度,只靠權重範數排名模型好壞。
Weight Decay與L2,何時才是同一件事?
先看沒有Momentum的普通SGD。本篇L2目標的更新可以整理為:
w_new = w - eta*(g_data + lambda*w)
      = (1-eta*lambda)*w - eta*g_data
當eta*lambda處在適當範圍,第一項把舊權重收縮,第二項再跟著資料梯度移動。在這個明確設定下,加L2梯度與這種weight decay更新相同。不是說更新後每個權重一定比原來小:資料梯度仍可能把它拉大。
問題出在自適應優化器。如果你把lambda*w先加進Adam的梯度,這部分也會進入一階、二階動差,再被座標尺度重新縮放。AdamW則將收縮與資料梯度的自適應更新分開:
耦合L2的Adam:
  g_used = g_data + lambda*w
  用g_used更新Adam的m與v,再更新w

AdamW:
  用g_data更新Adam的m與v
  w_new = (1-eta*lambda)*w
          - eta*m_hat/(sqrt(v_hat)+epsilon)
因此兩者通常不相同。Loshchilov與Hutter的Decoupled Weight Decay工作在2017年提出預印本,後於ICLR 2019發表,核心就是把這項差異說清楚。
本文實跑的是PyTorch 2.3.1:其中Adam(weight_decay=...)採耦合方式,AdamW採解耦方式。不要把這個固定版本結論無條件套到所有框架或未來API;應核對使用版本是否有額外的decoupled設定。
還要看參數分組。Bias要不要衰減、哪些層被排除,都由實際設定決定,不是參數叫bias就自動免除。若已在loss加同一份L2,又替同一組參數設定耦合weight_decay,可能把懲罰重複加進去。
同樣寫loss,畫的可能不是同一個量
圖5|D2L PyTorch scratch原圖:200個輸入、20筆訓練、100筆驗證,batch=5、lr=0.01、10 epochs、lambda=0。合成目標為偏置0.05、各權重0.01再加小量高斯噪聲;縱軸是對數刻度,這裡的loss為平均半平方誤差。來源:D2L CC BY-SA 4.0;完整原圖轉PNG。這是來源教學run,不是本站重跑。
藍線繼續下降,橘線沒有同步改善,提醒我們:記住訓練資料不等於能預測新資料。不過,下一張圖不能只換個標題,就直接拿縱軸數字作公平比較。
圖6|D2L另一個PyTorch scratch run,資料設定同圖5,lambda=3。依來源class與helper,train_loss與val_loss都包含平均半平方誤差加(3/2)*sum(w²),不是驗證時自動去掉L2。曲線保留原始對數刻度;來源:D2L CC BY-SA 4.0,完整原圖轉PNG。沒有據此宣稱裸預測MSE改善多少。
這是讀技術文章時很有用的一個檢查:no_grad()只是不記梯度,不會自動從loss公式拿掉正則化。若驗證程式仍呼叫同一個包含L2的loss,驗證數值就仍有懲罰項。
圖5與圖6的loss定義因此不同;兩次模型初始化也不是同一份受控設定。來源的train點是跨更新batch的平均,val點則在epoch末評估。沒有逐點權重與loss components,不能從整條曲線扣一個固定數,就宣稱還原了裸MSE。
要比較正則化強度,建議分開記錄:訓練用的總目標J、固定定義的資料預測誤差L_data,以及必要的任務指標。選lambda或p時看驗證結果,最後再用保留測試集評估。不要因為兩張圖都叫val_loss,就假定其公式、單位與平均方式相同。
Early Stopping:用驗證資料選擇停止時機
圖7|Google教材概念圖,藍線標Train、紅線原標Test;本文保留原標籤。用這類圖討論停止時機時,本站流程使用驗證集,真正的最終測試集不拿來挑epoch。這是示意趨勢,沒有資料集、精確最佳epoch或本次實測成效。來源:Google CC BY 4.0;完整原圖轉PNG。
Early Stopping把「最多能訓練多久」與「哪個時點的模型值得保留」拆開。先選定監控量及改善規則,再允許一段沒有改善的等待期,避免每次微小波動就停下。
看一個自訂的說明序列,監控val_loss,越低越好,patience=2、min_delta=0,沒有warm-up或baseline條件:
| Epoch | 示意val_loss | 判讀 |
|---|---|---|
| 1 | 0.500 | 記錄第一個最佳值 |
| 2 | 0.400 | 改善,更新最佳模型 |
| 3 | 0.405 | 未改善,等待1次 |
| 4 | 0.402 | 仍未優於0.400,等待2次,停止 |
即使第4個epoch比第3個epoch好一點,也沒有打破「目前最佳」0.400。這個表是規則說明,不是本次Keras訓練的輸出。
停止之後用哪一份權重,也要明確指定。依2026年10月查閱的Keras 3官方文件,restore_best_weights預設為False;只開啟EarlyStopping,不代表自動回復最佳epoch。若要保留本例第2個epoch的模型,就需要恢復最佳權重或另外保存checkpoint。
下面是文件用法示意,未在本機執行Keras;model與資料須由讀者自己的任務提供:
callback = keras.callbacks.EarlyStopping(
    monitor="val_loss",
    mode="min",
    min_delta=0.0,
    patience=2,
    restore_best_weights=True,
)
# model.fit(..., validation_data=(X_val, y_val), callbacks=[callback])
監控的val_loss必須真的出現在訓練logs。若想讓改善至少達一定幅度,可設定min_delta;若前面幾個epoch不參與監控,可使用start_from_epoch。這些都是應明示的實驗設定,不是每個任務共用的最佳預設。
不是每一種loss變差,都該靠提早停止處理
圖8|Google教材的訓練loss突升示意,與圖7「訓練繼續改善、評估轉差」不同。它沒有附實驗數據,不能只憑形狀斷定原因。來源:Google CC BY 4.0;完整原圖轉PNG。
遇到NaN、異常輸入或過大的更新量,應查數值與資料處理。Early Stopping可能讓訓練提早結束,卻不會替你修好loss計算。反過來,若模型始終無法擬合可信的小樣本,還要檢查模型、梯度與訓練流程,不能只加大正則化。
| 想處理的事情 | 主要改動的位置 | 需要觀察的量 |
|---|---|---|
| 減少過度依賴固定activation組合 | Dropout的訓練前向計算 | 驗證指標、train/eval模式、p |
| 限制權重更新與大小 | L2目標或Weight Decay更新 | 固定資料loss、懲罰項、參數分組與optimizer版本 |
| 控制訓練持續時間 | Early Stopping/checkpoint規則 | 同一定義的驗證量、patience、最佳模型恢復 |
三種方法可以一起使用,但強度的效果不一定相加。若一次同時改p、weight decay、步長與停止規則,結果變了也很難知道是哪個改動造成。先固定評估方式,再有計畫地調整。
實跑:32種遮罩與5種單步更新
下面的第一部分固定5個activation,枚舉所有32個二元遮罩,按獨立丟棄機率p=0.4計算各遮罩機率。不是把32個結果等權平均;保留數量不同,機率也不同。它核對的是固定activation的期望與變異數。
第二部分使用權重[1, -2]、資料梯度[0.3, -0.1]、eta=0.05、lambda=0.2。資料目標刻意選成線性函數g dot w,只有一次更新,沒有模型訓練或最佳解搜尋。顯式L2採lambda/2 * sum(w²),且沒有bias。
本次環境為WSL、Python 3.10.12、NumPy 1.26.3、PyTorch 2.3.1+cu118,CPU float64。安裝對應版本後,把下列可執行程式存成regularization_checks.py,以python regularization_checks.py執行。CUDA套件標記不代表本例用了GPU。
import itertools
import numpy as np
import torch

print(f"numpy={np.__version__} torch={torch.__version__} device=cpu dtype=float64")
h = np.array([1., 2., -1., 0., 3.])
p_drop = .4
expected = np.zeros_like(h)
second = np.zeros_like(h)
probability_sum = 0.
for mask_tuple in itertools.product([0., 1.], repeat=len(h)):
    mask = np.array(mask_tuple)
    kept = int(mask.sum())
    probability = (1 - p_drop) ** kept * p_drop ** (len(h) - kept)
    output = h * mask / (1 - p_drop)
    expected += probability * output
    second += probability * output ** 2
    probability_sum += probability
variance = second - expected ** 2
assert np.allclose(expected, h, atol=1e-12, rtol=0)
assert np.allclose(variance, p_drop / (1 - p_drop) * h ** 2, atol=1e-12, rtol=0)
print("all32_masks_probability_sum=", round(probability_sum, 12))
print("inverted_dropout_exact_mean=", np.round(expected, 9).tolist())
print("inverted_dropout_exact_variance=", np.round(variance, 9).tolist())
x = torch.tensor(h, dtype=torch.float64)
torch.manual_seed(7)
sample = torch.nn.functional.dropout(x, p=p_drop, training=True)
torch.manual_seed(7)
scaled_mask = torch.nn.functional.dropout(torch.ones_like(x), p=p_drop, training=True)
assert torch.equal(sample, x * scaled_mask)
assert torch.equal(torch.nn.functional.dropout(x, p=p_drop, training=False), x)
print("torch_train_matches_same_seed_scaled_mask=", True)
print("torch_eval_identity=", True)

# One step only: base objective g dot w, no bias, same initial weights.
w0 = np.array([1., -2.])
g = np.array([.3, -.1])
lr, decay, eps = .05, .2, 1e-8
expected_sgd = w0 - lr * (g + decay * w0)
expected_adam_l2 = w0 - lr * (g + decay * w0) / (np.abs(g + decay * w0) + eps)
expected_adamw = w0 * (1 - lr * decay) - lr * g / (np.abs(g) + eps)
for name in ["SGD_weight_decay", "SGD_explicit_L2", "Adam_weight_decay", "Adam_explicit_L2", "AdamW"]:
    w = torch.tensor(w0, dtype=torch.float64, requires_grad=True)
    explicit = name.endswith("explicit_L2")
    configured_decay = 0. if explicit else decay
    if name.startswith("SGD"):
        opt = torch.optim.SGD([w], lr=lr, momentum=0., weight_decay=configured_decay, foreach=False)
        expected_update = expected_sgd
    elif name == "AdamW":
        opt = torch.optim.AdamW([w], lr=lr, betas=(.9, .999), eps=eps,
                                weight_decay=decay, amsgrad=False, foreach=False)
        expected_update = expected_adamw
    else:
        opt = torch.optim.Adam([w], lr=lr, betas=(.9, .999), eps=eps,
                               weight_decay=configured_decay, amsgrad=False, foreach=False)
        expected_update = expected_adam_l2
    opt.zero_grad(set_to_none=True)
    loss = (torch.tensor(g, dtype=torch.float64) * w).sum()
    if explicit:
        loss = loss + .5 * decay * w.square().sum()
    loss.backward()
    opt.step()
    assert np.allclose(w.detach().numpy(), expected_update, atol=1e-12, rtol=0)
    print(f"{name} one_step_weights={np.round(w.detach().numpy(), 9).tolist()} formula_match=True")
print("scope=dropout exhaustive expectation plus one fixed-seed CPU mask; one-step optimizer formulas in torch2.3.1; no model training, early-stopping API run, or heldout performance")
本次實際輸出如下;版本列會依安裝的套件變體不同:
numpy=1.26.3 torch=2.3.1+cu118 device=cpu dtype=float64
all32_masks_probability_sum= 1.0
inverted_dropout_exact_mean= [1.0, 2.0, -1.0, 0.0, 3.0]
inverted_dropout_exact_variance= [0.666666667, 2.666666667, 0.666666667, 0.0, 6.0]
torch_train_matches_same_seed_scaled_mask= True
torch_eval_identity= True
SGD_weight_decay one_step_weights=[0.975, -1.975] formula_match=True
SGD_explicit_L2 one_step_weights=[0.975, -1.975] formula_match=True
Adam_weight_decay one_step_weights=[0.950000001, -1.950000001] formula_match=True
Adam_explicit_L2 one_step_weights=[0.950000001, -1.950000001] formula_match=True
AdamW one_step_weights=[0.940000002, -1.930000005] formula_match=True
scope=dropout exhaustive expectation plus one fixed-seed CPU mask; one-step optimizer formulas in torch2.3.1; no model training, early-stopping API run, or heldout performance
5個activation的精確期望是原輸入[1, 2, -1, 0, 3],變異數是[2/3, 8/3, 2/3, 0, 6]。程式也固定同一seed,核對functional Dropout輸出與同seed生成的縮放遮罩;training=False時該操作是identity。這沒有實測一個完整模型的eval()或推論品質。
SGD的兩種寫法都得到[0.975, -1.975];耦合Adam的兩種寫法也互相一致,卻與AdamW不同。這是指定版本、狀態初始化、epsilon與單步公式的核對,不是AdamW優於Adam的效能測試。輸出小數有四捨五入,真正比對使用atol=1e−12、rtol=0。
最後要能回答的問題是:你比較的是哪個loss、哪份資料、哪個模式,以及哪一次參數狀態?把這四件事說清楚,Dropout、Weight Decay與Early Stopping才會成為可檢查的選擇。
圖片授權與原始來源
圖1、2、5、6來自《Dive into Deep Learning》,作者Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola;依英文書實際版本LICENSE採CC BY-SA 4.0。完整原圖轉白底PNG;圖2完整面板編排,圖1手機只將完整before/after面板直排,封面等比縮放完整圖1加白邊;圖像改作沿用CC BY-SA 4.0。未重畫節點、箭頭或曲線。
圖3、4、7、8為Google ML Crash Course原始解說圖,依原頁內容的CC BY 4.0使用,署名Google並連回原章;只有完整格式轉換,圖形、數值與標籤不變。這些是教學示意,不是本站數據圖。圖片授權不將本站獨立正文冒稱為教材翻譯。
Fashion-MNIST資料作者為Han Xiao、Kashif Rasul、Roland Vollgraf/Zalando Research,資料集採MIT授權,本稿另保留實際完整聲明。本文使用的是D2L產生的曲線,沒有複製衣物照片或重新發布資料集。
- D2L:Dropout:遮罩、inverted縮放、兩種來源模型。
- D2L:Weight Decay:L2目標與合成資料例;讀圖時須核對實作的loss定義。
- D2L固定版本PyTorch helper:本輪查核train/val模式、loss與batch聚合的根據;不冒稱已精確還原來源圖片當年執行環境。
- Google:L2 Regularization及Interpreting Loss Curves:權重與loss形狀的解說圖。
- Keras 3 EarlyStopping:本文API示意與預設值的文件根據,未在本機執行Keras訓練。
- PyTorch v2.3.1 Adam原碼與AdamW原碼:本篇固定版本耦合與解耦更新的實作根據。
資料集MIT授權全文如下:
The MIT License (MIT) Copyright © 2017 Zalando SE, https://tech.zalando.com

Permission is hereby granted, free of charge, to any person obtaining a copy of this software and associated documentation files (the “Software”), to deal in the Software without restriction, including without limitation the rights to use, copy, modify, merge, publish, distribute, sublicense, and/or sell copies of the Software, and to permit persons to whom the Software is furnished to do so, subject to the following conditions:

The above copyright notice and this permission notice shall be included in all copies or substantial portions of the Software.

THE SOFTWARE IS PROVIDED “AS IS”, WITHOUT WARRANTY OF ANY KIND, EXPRESS OR IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY, FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM, OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE SOFTWARE.
留言0
登入後就能留言。
登入