
反向傳播回傳的是梯度:某個中間數值或權重改變一點,最終損失會如何改變?每一層接收後面傳來的敏感度,乘上自己的局部導數,再把結果交給前面的運算。
上一章已經算過損失對logit的梯度,例如單一未加權分類樣本的p-y。本篇接著問:這個訊號如何穿過中間層,變成每個權重與偏置的梯度?我們先讀小型計算圖,再手算一個2→2→1網路,最後用PyTorch與數值差分核對。
網路圖上的箭頭,先告訴你誰依賴誰
圖1|左為3→4→2,右為3→4→4→1,手機依序上下排。來源:Andrej Karpathy/CS231n Neural Networks Part 1,MIT。兩張完整原圖編排,手機第一張等比放大以對齊寬度。這是前向結構示意,沒有畫梯度或訓練後權重;也不是後面本站2→2→1數值例子的結構。
從輸入到輸出走一次,你會得到各層的中間值與最後損失。若想知道第一層某個權重的影響,就需要追蹤它經過哪些中間運算,才影響到損失。
把每個加法、乘法與激活函數拆成節點,就得到計算圖。對基本前向網路,依賴關係可以按順序計算;反向時則沿相反的依賴順序,把所需梯度算回來。這不要求把網路的函數反解,也不要求某個權重只經過一條路徑影響輸出。
一個局部導數,乘上上游梯度
先把最簡單的情況寫清楚。若q=g(x)、f=h(q),在相應可微位置:
df/dx = (df/dq) * (dq/dx)
節點g只需要知道自己的局部導數dq/dx,以及後面傳來的df/dq。它不必重新展開整個h(g(x))。反向傳播正是把這種局部計算,有順序地用在整張圖上。
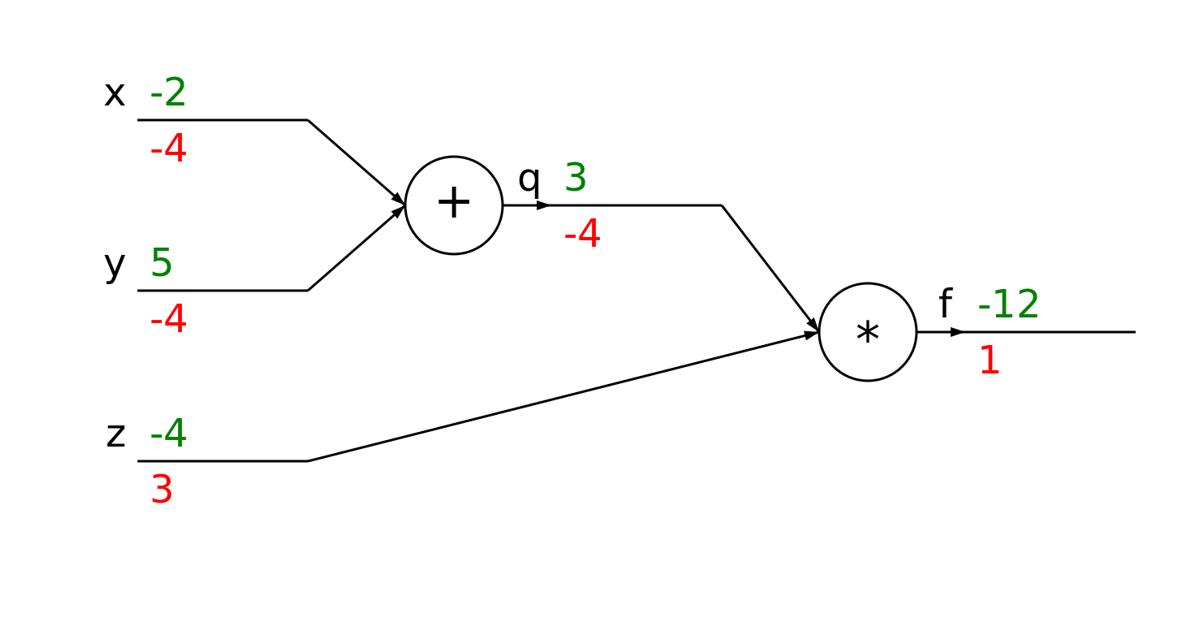
圖2|q=x+y、f=qz,x=-2、y=5、z=-4,所以q=3、f=-12。綠色是前向數值,紅色是最終f對該位置的導數,從df/df=1開始。來源:Andrej Karpathy/CS231n Backpropagation,MIT。從原章inline SVG提取既有圖,擴大viewBox右界以完整顯示原碼已有的輸出線,再轉白底PNG;沒有新增數值或線條。這裡的y是示範自變數,不是訓練標籤。
先從最後的乘法開始。f=qz,所以df/dq=z=-4、df/dz=q=3。再走過q=x+y,加法對兩個輸入的局部導數都是1,因此df/dx=df/dy=-4。
| 位置 | 前向值 | 最終f對該位置的導數 |
|---|---|---|
| f | -12 | 1 |
| q | 3 | -4 |
| z | -4 | 3 |
| x | -2 | -4 |
| y | 5 | -4 |
紅色的-4與綠色的3具有不同意義。q目前是3;df/dq=-4表示在這個點附近,q增加一個很小的量,f約減少它的4倍。導數描述局部敏感度。
這張圖的輸出f也還不是某個訓練任務的損失。若要最小化一個損失L,更新方法會再利用∇L決定步伐;反向傳播本身負責算梯度,沒有替你選學習率或保證更新後一定更好。
加法、乘法與max,怎麼處理傳回來的訊號?
圖3|來源函數是f=2[xy+max(z,w)],x=3、y=-4、z=2、w=-1,輸出-20。綠色為數值、紅色為對最終f的導數。來源同圖2,MIT;擴大原SVG顯示範圍,露出原碼原有的完整-20.00標籤,再轉白底PNG。這是另一個獨立的數學例子。
最後乘2,讓它前面的總和接收到梯度2。接著依各節點的局部規則處理:
- 加法a+b:每條輸入路徑的局部導數都是1,所以兩邊各收到相同的上游梯度。
- 乘法ab:對a的局部導數是b,對b則是a,再各自乘上上游梯度。
- max(z,w):在z>w時,對z的局部導數是1、對w是0;w>z時反過來。
所以圖中df/dx=2y=-8、df/dy=2x=6,而z=2大於w=-1,得到df/dz=2、df/dw=0。max遇到相等輸入時不可用上述唯一分支直接處理,需區分不可微與框架採用的梯度慣例;不能把兩個分支都當成通常導數1。
乘法規則也解釋了資料尺度為何重要:在上游梯度固定時,輸入值會直接乘進權重的梯度。改變資料尺度還可能改變後續輸出與上游梯度,因此不能無條件說整個網路梯度一定只跟著放大某個固定倍數。
複合函數可以拆開,也可以合成一個模組
圖4|來源使用x=[-1,-2]、w=[2,-3,-3],最後一個w是偏置;加權和為1,sigmoid輸出約0.73。紅色是這個sigmoid輸出對各變數的導數,並未接分類損失。來源同圖2,MIT;保留完整原SVG內容並轉白底PNG。手機先完整圖,再依加權和、1.00→0.37、0.37→0.73分三段放大,重疊的值代表同一個中間量,不是新增步驟或另一輪訓練。
sigmoid(z)=1/(1+exp(-z))可以拆成負號、exp、加1與倒數,再逐步反傳。也可以把它視為一個模組,直接使用局部導數s(1-s)。
這個來源例子z=1、s≈0.731059,局部導數約0.196612。對偏置的導數就是這個數;對w0的導數則再乘x0=-1,約-0.196612,圖上四捨五入成-0.20。
模組化改變的是我們安排運算與保存中間值的方式。只要函數與求導規則一致,拆開或合起來都應算到同一個導數。若接上二元交叉熵,則還要納入那個損失的上游訊號,不能把此圖的紅色數字直接當成分類損失的梯度。
同一個量有多條影響路徑,梯度就要累加
圖5|w、x、y、z影響a、b,再經u、v到f。箭頭表示函數依賴,圖中沒有指定數值或神經網路訓練結果。來源:Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola/Dive into Deep Learning,Multivariable Calculus,CC BY-SA 4.0。完整原SVG轉白底PNG,圖像改作沿用同授權。
若a同時經u與v影響f,就要把兩條貢獻相加:
g_a = g_u * (du/da) + g_v * (dv/da)
其中g_a、g_u、g_v都表示最終f對該中間量的總導數。
例如f=x²+x,x=3時,平方那條路貢獻6,直接加x的路貢獻1,總導數為7。只保留最後一條路,就會漏算。實作上常見的+=,就是在累加不同用途返回的貢獻。
圖6|來源另一張依賴圖:y可經y→u→a→f、y→u→f,以及y→v→b→f影響輸出,共三條路。來源同圖5,完整原SVG轉PNG,CC BY-SA 4.0。u到f有一條直接邊,不能只看最長路徑。
反向時,先把f直接傳給u的貢獻,以及經a返回u的貢獻加好,再從u傳向y。這樣就能涵蓋三條路,不必每算一個參數,都重新列出全部路徑。
對應到演算法,要沿反向依賴順序處理節點,並等該節點需要的返回貢獻累積完成。權重被多筆樣本共用、參數被多個分支共用,都需要遵守相同原則。
計算圖也可能包含正則項,先確定你在對誰求導
圖7|D2L原例的x經W1、激活函數φ與W2得到o,再與目標y算L;另一支由W1、W2計算L2正則項s,最後J=L+s。來源:上述D2L四位作者,Forward Propagation, Backward Propagation, and Computational Graphs,CC BY-SA 4.0。採repo原SVG完整轉白底PNG;來源省略偏置,圖的箭頭是前向依賴,沒有畫反向梯度。
若s=(λ/2)(‖W1‖²_F+‖W2‖²_F),W1的梯度除了經資料損失返回的部分,還要加λW1。圖裡權重有兩種用途,這也是分支累加。
因此,看見「誤差下降」之前,先弄清楚紀錄的是資料損失L、正則項s,還是總目標J。接下來本站的數值例子使用偏置,且沒有加正則化,與這張來源圖的設定不同。
把同一套規則寫成矩陣運算
本文採每列一筆樣本的慣例。對兩層網路:
Z1 = X @ W1 + b1
H  = ReLU(Z1)
O  = H @ W2 + b2
L  = 0.5 * mean((O-y)²)
若有n筆資料、d個輸入、h個隱藏單元與q個輸出,形狀是:
在上述mean對全部n×q個元素平均時,輸出梯度是G=(O-y)/(nq)。單輸出q=1時,分母才簡化成n。沿圖往回算:
dW2 = H.T @ G
db2 = sum(G, across samples)
dH  = G @ W2.T
dZ1 = dH * (Z1 > 0)       # 逐元素相乘,0點另依框架慣例

dW1 = X.T @ dZ1
db1 = sum(dZ1, across samples)
矩陣乘法把樣本與單元的貢獻一次整理好,沒有改變鏈式法則。偏置被broadcast到每筆樣本,因此反向要把這些用途加回同一個偏置。
這裡的G已包含平均。db2再跨樣本加總時,不要又無故除一次n。D2L或CS231n若以欄向量、W左乘來寫,轉置位置會不同;整套慣例要一致。維度檢查能抓到許多錯誤,但方陣時,即使轉置用錯也可能仍可相乘,還需要小數值檢查。
手算兩筆資料,追蹤第一層的一個權重
這次使用2→2→1,所有參數都是手選,目的是核對求導:
X  = [[ 1, 2], [-1, 1]]      y  = [[1], [0]]
W1 = [[.2,-.3], [.4,.1]]     b1 = [.1,-.2]
W2 = [[.7],[-.5]]            b2 = [.05]
雖然目標剛好是1與0,這裡使用的是線性輸出與平方損失的回歸式計算,沒有加sigmoid。前向結果為:
Z1 = [[1.1,-.3], [.3,.2]]
H  = [[1.1,  0], [.3,.2]]
O  = [[.82], [.16]]
L  = 0.5 * (.18² + .16²) / 2 = .0145
單輸出、兩樣本,G=(O-y)/2=[[-.09],[.08]]。先算第二層,再往回走:
dW2 = [[-.075], [.016]]     db2 = [-.01]
dH  = [[-.063,.045], [.056,-.04]]
dZ1 = [[-.063,   0], [.056,-.04]]
第一筆的第二個隱藏單元,Z1=-0.3,ReLU把這次路徑的梯度截成0。第二筆兩個隱藏單元都為正,所以相應訊號通過。
以W1左上角為例,兩筆資料對它的貢獻分別是1×(-.063)與(-1)×.056,加起來為-.119。這個權重收到的梯度已經結合了兩個樣本、後層權重與ReLU的局部行為。全部結果如下:
dW1 = [[-.119,.04], [-.07,-.04]]
db1 = [-.007,-.04]
第一個偏置的-.007,則是-.063+.056。不同樣本的貢獻可以互相抵消,梯度不一定與某筆樣本的誤差同號。
還有一個關鍵順序:計算dH時,要用這次前向的W2。先拿dW2更新W2,再用更新後的值繼續算dH,就混用了兩個不同位置的函數資訊,結果不再是這次前向對應的梯度。
用autograd與數值差分交叉核對
以下程式在WSL、Python 3.10.12、NumPy 1.26.3、PyTorch 2.3.1+cu118實跑,使用CPU與float64,沒有使用GPU。主要版本清單未鎖定CPU/CUDA wheel變體;重建環境時依官方歷史版本安裝選項準備相容環境,再執行。本文未驗證所有平台重新安裝。
numpy==1.26.3
torch==2.3.1
將後面的程式另存為backprop_two_layers.py:
python backprop_two_layers.py
import numpy as np
import torch

print(f"numpy={np.__version__} torch={torch.__version__} device=cpu dtype=float64")
X = np.array([[1., 2.], [-1., 1.]])
y = np.array([[1.], [0.]])
W1 = np.array([[.2, -.3], [.4, .1]])
b1 = np.array([.1, -.2])
W2 = np.array([[.7], [-.5]])
b2 = np.array([.05])
parameters = [W1, b1, W2, b2]

def forward(values):
    w1, c1, w2, c2 = values
    z1 = X @ w1 + c1
    h = np.maximum(z1, 0)
    pred = h @ w2 + c2
    loss = 0.5 * np.mean((pred - y) ** 2)
    return z1, h, pred, loss

Z1, H, pred, loss = forward(parameters)
# Derivatives use the same, unchanged forward-pass parameters throughout.
dO = (pred - y) / len(X)
dW2 = H.T @ dO
db2 = dO.sum(axis=0)
dH = dO @ W2.T
dZ1 = dH * (Z1 > 0)
dW1 = X.T @ dZ1
db1 = dZ1.sum(axis=0)
manual = [dW1, db1, dW2, db2]
print("Z1=", np.round(Z1, 9).tolist())
print("H=", np.round(H, 9).tolist())
print("pred=", np.round(pred, 9).tolist())
print(f"half_mean_squared_loss={loss:.9f}")
for name, gradient in zip(["W1", "b1", "W2", "b2"], manual):
    print(f"manual_d{name}=", np.round(gradient, 9).tolist())

# Independent backend: same function, explicit CPU double tensors.
tx = torch.tensor(X, dtype=torch.float64)
ty = torch.tensor(y, dtype=torch.float64)
tp = [torch.tensor(a, dtype=torch.float64, requires_grad=True) for a in parameters]
tw1, tc1, tw2, tc2 = tp
tpred = torch.relu(tx @ tw1 + tc1) @ tw2 + tc2
tloss = 0.5 * (tpred - ty).square().mean()
tloss.backward()
auto_error = max(np.max(np.abs(a - b.grad.numpy())) for a, b in zip(manual, tp))
print("manual_matches_autograd=", all(np.allclose(a, b.grad.numpy(), atol=1e-12, rtol=0) for a, b in zip(manual, tp)))
# Central finite differences: all9parameters, away from ReLU's kink.
eps = 1e-6
finite_errors = []
for i, value in enumerate(parameters):
    for index in np.ndindex(value.shape):
        plus = [a.copy() for a in parameters]
        minus = [a.copy() for a in parameters]
        plus[i][index] += eps
        minus[i][index] -= eps
        numerical = (forward(plus)[3] - forward(minus)[3]) / (2 * eps)
        finite_errors.append(abs(numerical - manual[i][index]))
print(f"finite_difference_checked_parameters={len(finite_errors)} max_error={max(finite_errors):.3e}")
print("finite_difference_within_1e-8=", max(finite_errors) < 1e-8)
# One simultaneous full-batch step, not a full training/generalization test.
updated = [a - .1 * g for a, g in zip(parameters, manual)]
new_loss = forward(updated)[3]
print(f"one_step_lr0.1_loss={new_loss:.9f} decreased={bool(new_loss < loss)}")
本次實際輸出:
numpy=1.26.3 torch=2.3.1+cu118 device=cpu dtype=float64
Z1= [[1.1, -0.3], [0.3, 0.2]]
H= [[1.1, 0.0], [0.3, 0.2]]
pred= [[0.82], [0.16]]
half_mean_squared_loss=0.014500000
manual_dW1= [[-0.119, 0.04], [-0.07, -0.04]]
manual_db1= [-0.007, -0.04]
manual_dW2= [[-0.075], [0.016]]
manual_db2= [-0.01]
manual_matches_autograd= True
finite_difference_checked_parameters=9 max_error=3.254e-12
finite_difference_within_1e-8= True
one_step_lr0.1_loss=0.011695046 decreased=True
手算與autograd在指定容差內一致。數值差分則對每個參數θ_j各做一次正負擾動:
數值導數 ≈ [L(theta + eps*e_j) - L(theta - eps*e_j)] / (2*eps)
九個參數需要18次損失評估,本例eps=1e-6、最大差距約3.254e-12。這個例子刻意讓Z1遠離0;檢查過的擾動也沒有跨ReLU分支。若在不可微點附近做差分,或浮點精度、eps選得不合適,差分與框架選用的梯度慣例就可能不一致,不能只看一個差距數字下結論。
autograd使用各運算的求導規則,沿實際計算圖組合梯度;這與逐參數擾動的數值差分不同。大模型逐個參數做差分很昂貴,反向傳播可以共用前向的中間值,以及已算好的返回訊號。
最後那一次同步更新,以原參數減去0.1倍各自梯度,讓這兩筆資料的損失從0.0145降到約0.011695046。這是一個已實跑的單步核對,沒有做完整訓練、獨立保留集評估或來源圖的實驗重跑;也不保證任意學習率、任意網路都會得到下降。
實務上,最容易讓反傳出錯的幾個地方
第一是平均與加總。先寫下損失完整公式,再決定分母是多少;batch有多個輸出時,mean不一定只除樣本數。第二是共用:一個變數有多個用途,返回的梯度要累加,不能用最後一條覆蓋前面的貢獻。
第三是前向值與權重的版本。反傳需要的中間值應與同一次前向對得上,算完梯度後再按更新規則動參數。保存這些中間值也會占記憶體,是訓練通常比單純推論更需要記憶體的原因之一;不是只有權重本身占空間。
第四是框架狀態。PyTorch的葉節點參數梯度會累積到.grad;做多步訓練時,要依訓練設計清理或刻意累積,不能把這件事與同一張計算圖內正確的分支加總混淆。誤用detach、把tensor轉成不再被追蹤的值,或在不合適的地方原地改動,也可能中斷或破壞求導。
反向傳播回答的是「這次前向下,各參數的局部敏感度是多少」。更新方法接著決定如何利用它。下一篇的SGD、Momentum與Adam,會比較這個後續步驟;把求導與更新分清楚,才能更準確地找出模型為什麼沒有學好。
延伸閱讀與素材出處
- 從感知器到MLP與激活函數/損失函數:前向、logits與局部導數的前置脈絡。
- Andrej Karpathy/CS231n:Backpropagation:圖2–4的原章inline SVG、局部gate與分支累加。本文保留原數值,不把原文「提高f」的直覺說法當成最小化損失的更新指令。
- CS231n:Neural Networks Part 1與repo MIT授權:圖1;所選自有圖依實際repo來源核對,不泛授第三方論文圖。
- D2L:Multivariable Calculus:圖5–6及多路徑鏈式法則。來源四位作者為Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola。
- D2L:Forward Propagation, Backward Propagation, and Computational Graphs:圖7;來源省略bias並包含L2正則項,本文實跑則有bias、無正則項。
- PyTorch 2.3 autograd與Tensor.backward:自動微分與梯度累積介面;精確實跑版本為2.3.1+cu118的CPU計算。
圖片授權聲明
圖1–4與封面採Andrej Karpathy/CS231n教材自有素材,依實際repo MIT授權使用。網路原圖左右/上下編排、inline SVG獨立檔案所需的xmlns與viewBox正規化、圖2/3擴大顯示邊界以露出原碼既有內容、圖4手機完整圖與原片段放大、封面完整縮放加白邊,均已披露,沒有新增梯度、改值或重畫節點。原始SVG標記所在的repo Markdown快照亦有保存。
圖5–7採D2L上述四位作者原SVG,依CC BY-SA 4.0使用;完整轉白底PNG的圖像改作沿同授權。採用的repo向量版本與原章圖意相同,作者、原章及授權連結如上;完整CC原件另存本篇CC-BY-SA-4.0.txt。本文為獨立教學與實作,沒有將其他文章換句話說或假稱來源作者背書。
以下保留CS231n實際完整MIT聲明:
The MIT License (MIT)

Copyright (c) 2015 Andrej Karpathy

Permission is hereby granted, free of charge, to any person obtaining a copy
of this software and associated documentation files (the "Software"), to deal
in the Software without restriction, including without limitation the rights
to use, copy, modify, merge, publish, distribute, sublicense, and/or sell
copies of the Software, and to permit persons to whom the Software is
furnished to do so, subject to the following conditions:

The above copyright notice and this permission notice shall be included in all
copies or substantial portions of the Software.

THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR
IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY,
FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE
AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER
LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM,
OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE
SOFTWARE.
留言0
登入後就能留言。
登入