
一個模型把樣本判成正類,機率是0.51;另一個模型也判成正類,機率是0.99。如果答案其實是負類,兩者的分類準確率都記一次錯誤,但訓練時,你可能希望第二種「很有把握地答錯」付出更高代價。
這就是損失函數要做的事:把預測與目標的差異,變成可以最佳化的數值。激活函數則決定訊號經過某個單元時如何轉換。兩者一個影響模型能表示什麼、局部導數怎麼變,另一個定義錯誤的代價;梯度把它們接起來,形成參數更新的依據。
但不是隨便挑一個激活函數,再接任意損失就能工作。先分清隱藏層、輸出與損失,才能知道數字的意思,也能避免在程式裡重複做softmax或sigmoid。
看激活函數,要同時看輸出與導數
上一章把一個單元寫成h=f(z)、z=w·x+b。若損失是L,對某個權重w_j,在可微位置的鏈式法則是:
dL/dw_j = (dL/dh) * f'(z) * x_j
從這個式子可以看出,激活函數的局部導數只是其中一環。它可能讓訊號通過、縮小或變成0,但權重最後收到的梯度,也取決於上游損失與輸入值。只看曲線很陡,不能直接說所有權重都會大幅更新。
以下三組圖,先看函數如何轉換,再看它允許什麼梯度通過。原圖的橫軸x是函數的自變數;對神經元而言,對應這裡的加權和z,不是必然指原始資料的某個欄位。
ReLU:正半邊通過,負半邊歸零
圖1|左為ReLU,右為來源框架計算後繪出的梯度;手機依序上下排。來源:Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola/Dive into Deep Learning,Multilayer Perceptrons,CC BY-SA 4.0。兩張完整原SVG轉白底PNG編排,圖像改作沿用同授權。右圖在0附近的連線是取樣繪圖,不代表ReLU在0具有通常導數。
ReLU(z) = max(0,z)
ReLU'(z) = 0  當z<0
           1  當z>0
ReLU在0不可微。本文實跑的PyTorch版本在反向傳播時選擇0作為該點的梯度慣例;這是計算規則,不能改寫成數學上可微。
正半邊的導數是1,局部不會把上游梯度再乘上一個很小的數。負半邊則對這次輸入傳回0;若一個單元對訓練樣本長期都落在負半邊,更新可能很困難。它有利於某些訓練問題,並不等於消除了所有梯度消失或最佳化困難。
sigmoid:輸出像機率,導數卻有另一個故事
圖2|左為sigmoid,右為導數;手機上下排。來源同圖1,完整原圖轉PNG編排,CC BY-SA 4.0。圖中的有限範圍與浮點呈現不改變數學值域(0,1)。
s = sigmoid(z) = 1/(1+exp(-z))
sigmoid'(z) = s(1-s)
z=0時,s=0.5,導數最大為0.25。z走向兩端,輸出越接近0或1,曲線也越平,局部導數趨近0。若這類小因子在多個隱藏層一路相乘,就可能讓早期層收到很弱的更新訊號。
不過,這不代表sigmoid不能放在二元分類的輸出端。它與二元交叉熵合在一起時,對logit的梯度可以簡化成p-y,稍後會直接算。隱藏層的梯度傳遞與輸出損失的整體導數,要分開看。
tanh:零中心有幫助,也仍會飽和
圖3|左為tanh,右為導數;手機上下排。來源同圖1,完整原圖編排,CC BY-SA 4.0。
t = tanh(z)
tanh'(z) = 1-t²
tanh(0)=0、導數為1,輸出範圍是(-1,1)。它能產生正負中間值,但兩端仍會變平。零中心不等於保證深層梯度穩定,也不能只因中心導數比sigmoid大,就推論所有任務都應換成tanh。
函數選擇要放回網路、初始化、資料與訓練條件中比較。這裡的三組曲線提供局部行為的判斷基礎,沒有宣稱某種函數在所有資料上勝出。
先辨認模型輸出,再選損失介面
- 一個或多個實數
- MSE、MAE或Huber,依誤差代價選擇
- 一個logit
- BCEWithLogitsLoss,目標為相同形狀的0/1或合法軟目標
- 每類一個logit
- CrossEntropyLoss,目標為類別索引或合法類別分布
- 每標籤一個logit
- 各標籤的BCEWithLogitsLoss,不強迫所有機率加起來為1
logit是尚未正規化的實數分數,不需要介於0與1,也不需要總和為1。這張表說的是常見建模介面,不是禁止其他合理的機率模型或損失。
PyTorch的CrossEntropyLoss接收原始logits,BCEWithLogitsLoss也接收原始logits。 前者已包含log-softmax的計算,後者已結合sigmoid與BCE。若先套softmax或sigmoid再送進這些介面,就會把輸入的意義弄錯。
推論時仍可以把logits轉成機率估計,方便解讀與選閾值。訓練介面不需要你先算機率,不表示模型沒有機率意義;輸出看似機率,也不表示已經完成校準驗證。
多類交叉熵:把正確類別的分數往上推
圖4|D2L原例為4個輸入、3個輸出分數,沒有隱藏層。圖上的o是線性分數;softmax與交叉熵是後續運算,圖本身沒有畫機率柱或損失。來源:上述D2L四位作者,Softmax Regression,CC BY-SA 4.0;完整SVG轉白底PNG,圖像改作沿同授權。
對互斥的C類,用softmax把分數z轉成機率p:
p_j = exp(z_j) / sum_k exp(z_k)
這不是對每個欄位各自做sigmoid;分母包含其他類別,某個分數改變會連帶影響其他機率。以z=[2,1,0]為例,得到約[0.665241,0.244728,0.090031]。
若正確類別是索引0,one-hot目標為[1,0,0]。使用自然對數,單一未加權樣本的交叉熵是:
L = -sum_j y_j log(p_j)
  = -log(p_0)
  = log(sum_j exp(z_j)) - z_0
  ≈ 0.407605964
這個值不是分類錯誤次數。即使argmax已選對類別,損失也可能繼續下降;它還在衡量模型對正確類別給了多少機率。
對logit z_j求導,無類別權重、無平滑且單樣本時,有一個實用的簡化:
dL/dz_j = p_j-y_j
本例梯度約[-0.334759,0.244728,0.090031]。梯度下降會減去梯度,所以正確類別的logit傾向上升,其他類別傾向下降。這是對輸出分數的方向;要知道每個權重怎麼變,仍要沿網路套鏈式法則。
數值穩定性:別急著自己exp再log
直接計算很大的exp可能溢位。令m=max(z),log-sum-exp可以改寫成:
log(sum_j exp(z_j)) = m + log(sum_j exp(z_j-m))
所有logits一起加同一常數,不改變softmax與相應交叉熵,因為正規化時會抵消。但log-sum-exp本身會加上那個常數,並非單獨平移不變。
這也是使用框架合併介面的理由之一。後面的程式實際把所有logits加1000,這個版本與dtype下的CE仍相同;它不保證任意巨大數值與所有浮點設定都不會出問題。
軟目標的最低交叉熵,不一定是0
若目標是分布P,而不只是one-hot,則要保留所有類別的資訊:
CE(P,Q) = -sum_j P_j log(Q_j)
        = H(P) + KL(P||Q)
在P、Q為合法機率分布、對應支撐條件成立時,最低值為H(P),於Q=P達到。若P=[0.1,0.5,0.1,0.1,0.1,0.1],這個值約1.497866137,而不是0。程式會以Q=P核算此點;最低性的依據是上述解析關係,並非程式訓練搜尋找到最低點。
標籤平滑會把目標改成軟分布,也就改變了這個比較基準。此時不能只知道「正確類別的機率」就算出整個交叉熵;其他類別的目標權重與預測機率也參與總和。使用soft targets時,應先確認非負、和為1及形狀正確,不能假定框架會替你修正無效目標。
二元交叉熵:圖上的機率斜率,不是權重梯度
圖5|橫軸是預測正類機率p。橙線為y=1時的-ln(p),藍線為y=0時的-ln(1-p),在p=0.5交於ln2≈0.69。來源:Erin Bugbee、Jared Wilber/MLU-Explain Logistic Regression;Copyright 2021 Amazon.com, Inc. or its affiliates,CC BY-SA 4.0。沿用本系列已採圖的可讀性版本:曲線未改,三處標籤曾調整描邊、字體及位置。手機先放完整圖,再放大同圖交點區及0.3–0.7的原橫軸刻度;局部圖沒有另外重畫縱軸,整體刻度見上圖。這些圖像改作沿同授權。
p = sigmoid(z)
BCE = -[y log(p) + (1-y) log(1-p)]
y=1時,p越接近1,損失越低;很有把握地把正類預測成負類,代價則會增加。y=0時,方向相反。
但圖的橫軸是p。對y=1,dL/dp=-1/p;若再考慮p=sigmoid(z),鏈式相乘後,對logit得到:
dL/dz = p-y (單一未加權二元目標)
例如z=0、y=1,p=0.5,損失是ln2,對z的梯度是-0.5。不是把圖上對p的斜率-2,直接當成每個權重的梯度。
BCEWithLogitsLoss以穩定形式合併兩步,常見等價的單點寫法為:
L(z,y) = max(z,0) - z*y + log(1+exp(-abs(z)))
多標籤任務可對每個標籤使用相應的二元目標,不要求所有正類機率加起來為1。若加入pos_weight、樣本權重或不同reduction,梯度與平均的縮放也會改變;前面的p-y不是涵蓋所有設定的無條件公式。
回歸損失:你要對大誤差付出多大代價?
本文先定義殘差r=預測值-真值。逐點平方誤差是r²,絕對誤差是|r|;對多個元素取平均,才分別得到這裡使用的MSE與MAE。
平方誤差對r的導數為2r,所以大殘差的代價與導數都會放大。絕對誤差在r≠0時導數是sign(r),0點不可微;相較之下,它不讓單一大殘差的逐點斜率一直增長。這些是從公式推導的性質,不是本文程式已測量的泛化效果。
Huber則在近零處用平方、外側用線性成長。對δ>0:
Huber_delta(r) = 0.5*r²                  當|r|<=delta
                delta*(|r|-0.5*delta)    當|r|>delta
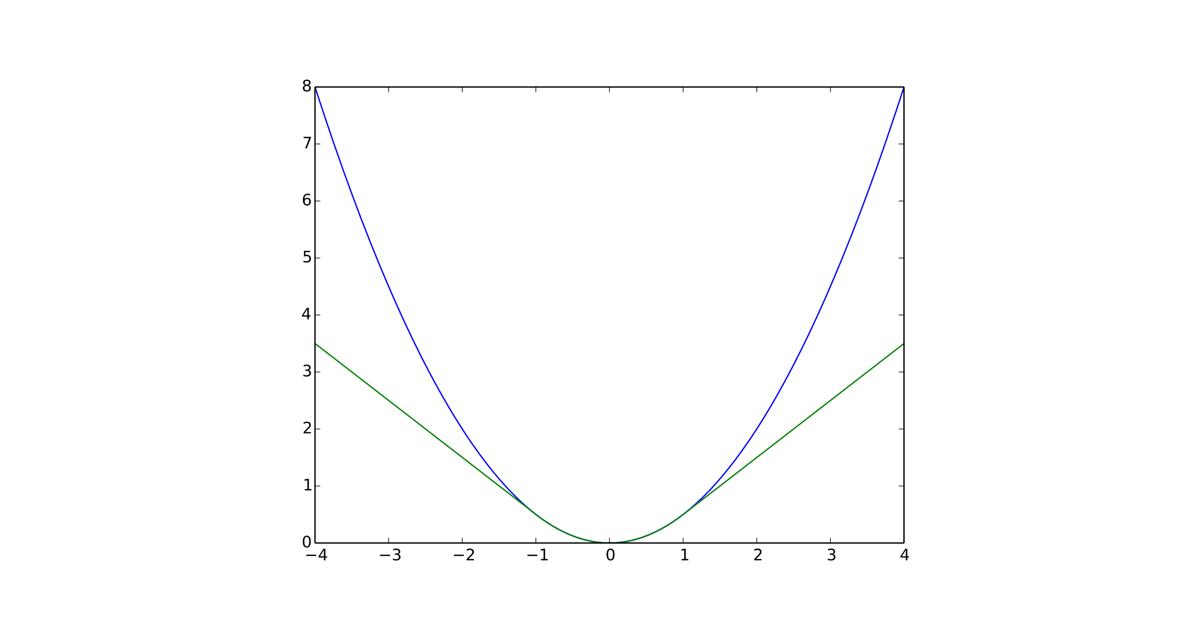
圖6|來源橫軸為殘差y-f(x),縱軸為逐點損失;原圖沒有軸名稱或圖例,因此在此明示:藍線為½r²,綠線為δ=1的Huber。兩線在|r|≤1重合,外側綠線線性成長。來源:Qwertyus/Wikimedia Commons「Huber loss.svg」,2014,原作者Own work,CC BY-SA 4.0。完整原SVG轉白底PNG,圖像改作沿同授權;沒有第三條MAE曲線。封面沿用同圖完整縮放加白邊。來源殘差與本文的符號相反,但這些偶函數的損失值不變。
留意藍線的½。它不是把所有樣本取平均後的MSE,也不是未乘½的r²。乘上正的常數不改單獨最小化這個損失時的最小點集合,但會改梯度尺度;與其他損失或正則項相加時,也會改彼此的相對權重。
| 殘差r | 平方誤差r² | 絕對誤差(abs r) | Huber,δ=1 |
|---|---|---|---|
| 0 | 0 | 0 | 0 |
| 05 | 0.25 | 0.5 | 0.125 |
| 2 | 4 | 2 | 1.5 |
Huber對r的導數在|r|<δ為r,外側為δ sign(r),在兩個接點一階導數連續。若最後取mean,還要再除以實際平均的元素數。它能降低大殘差相較於平方損失的影響,不表示所有離群點都應忽略;大誤差也可能是你最在意的事件。
SmoothL1與Huber,名字接近也可能差一個倍率
在本文使用的PyTorch版本,β=δ>0時,SmoothL1_beta=Huber_delta/β。例如r=3、δ=β=2,Huber為4,SmoothL1為2;只有β=1時兩者的數值縮放相同。把參數從1改成2後,不能繼續假定兩個介面完全等價。
損失曲線與擬合結果,分別回答兩個問題
圖7|這張橫軸是特徵X、縱軸是目標y,畫的是模型擬合線,已不是上一張的殘差/損失曲線。來源:The scikit-learn developers,HuberRegressor vs Ridge原例,BSD-3-Clause。20筆原始toy資料再加4個強離群點;HuberRegressor使用epsilon=1、1.5、1.75、1.9且alpha=0。綠線雖標ridge regression,程式alpha=0,這裡沒有L2懲罰效果。完整原圖保留,手機另附原圖例局部放大;不是新實驗或本站重跑結果。
這個來源例子把「用不同誤差代價擬合,結果可能改變」具體畫出來。但HuberRegressor同時估計誤差尺度,epsilon對應的是標準化殘差的轉折,不能直接當成前面手算公式裡、原始單位下的δ。圖中的某條線比較接近原有點,也不能替所有資料宣稱最佳epsilon。
實務上,先理解資料裡大誤差的含義,再依驗證集與任務代價比較。換損失不會自動修復錯標、尺度錯誤或資料洩漏。
用PyTorch核對數值與梯度,不把小例子當訓練成效
下面程式在WSL、Python 3.10.12、NumPy 1.26.3與PyTorch 2.3.1+cu118實跑,浮點tensor明確使用CPU與float64,類別索引是int64。雖然安裝的wheel帶CUDA版本標記,本例沒有使用GPU。
主要版本清單如下,torch==2.3.1沒有鎖定CPU/CUDA的wheel變體。本次使用既有相容環境執行,沒有驗證所有平台的重新安裝;重建環境時,依PyTorch官方歷史版本安裝選項選適合的平台與wheel,再準備NumPy版本。這裡的成功判準是程式內限定的CPU計算,不是GPU安裝或效能測試。
numpy==1.26.3
torch==2.3.1
將後面的程式另存為activation_loss_gradients.py,在備妥上述相容環境後執行:
python activation_loss_gradients.py
import numpy as np
import torch
import torch.nn.functional as F

# Floating-point tensors are CPU float64; class-index labels are int64.
# No model training or source-figure generation.
print(f"numpy={np.__version__} torch={torch.__version__} device=cpu dtype=float64")
x = torch.tensor([-1., 0., 1.], dtype=torch.float64, requires_grad=True)
y = F.relu(x)
y.sum().backward()
print("ReLU_values=", y.detach().tolist())
print("ReLU_framework_gradients=", x.grad.tolist())
s0 = torch.tensor(0., dtype=torch.float64, requires_grad=True)
sigmoid0 = torch.sigmoid(s0)
sigmoid0.backward()
print("sigmoid_at_zero=", sigmoid0.item(), "derivative=", s0.grad.item())
t0 = torch.tensor(0., dtype=torch.float64, requires_grad=True)
tanh0 = torch.tanh(t0)
tanh0.backward()
print("tanh_at_zero=", tanh0.item(), "derivative=", t0.grad.item())

z = torch.tensor([[2., 1., 0.]], dtype=torch.float64, requires_grad=True)
p = F.softmax(z, dim=1)
ce = F.cross_entropy(z, torch.tensor([0]))
ce.backward()
print("softmax_probabilities=", np.round(p.detach().numpy()[0], 9).tolist())
print(f"CE_from_logits={ce.item():.9f}")
print("CE_logits_gradient=", np.round(z.grad.numpy()[0], 9).tolist())
print("CE_gradient_equals_p_minus_onehot=", torch.allclose(z.grad, p.detach() - torch.tensor([[1., 0., 0.]], dtype=torch.float64)))
# Adding a common constant changes neither softmax nor the exact CE.
shifted_ce = F.cross_entropy(z.detach() + 1000., torch.tensor([0]))
print("CE_common_shift_invariant=", torch.allclose(ce.detach(), shifted_ce))

binary_z = torch.tensor([0.], dtype=torch.float64, requires_grad=True)
bce = F.binary_cross_entropy_with_logits(binary_z, torch.tensor([1.], dtype=torch.float64))
bce.backward()
print(f"BCE_with_logits_z0_y1={bce.item():.9f} gradient={binary_z.grad.item():.6f}")
# Soft targets need every class probability; their minimum CE equals entropy.
soft_target = torch.tensor([[.1, .5, .1, .1, .1, .1]], dtype=torch.float64)
soft_ce = F.cross_entropy(soft_target.log(), soft_target)
print(f"soft_target_CE_at_Q_equals_P={soft_ce.item():.9f}")

r = torch.tensor([0., .5, 2.], dtype=torch.float64)
zeros = torch.zeros_like(r)
print("squared_error_per_residual=", (r ** 2).tolist())
print("absolute_error_per_residual=", r.abs().tolist())
print("Huber_delta1_per_residual=", F.huber_loss(r, zeros, delta=1., reduction="none").tolist())
print(f"MSE_mean={F.mse_loss(r, zeros).item():.9f} "
      f"MAE_mean={F.l1_loss(r, zeros).item():.9f} "
      f"Huber_delta1_mean={F.huber_loss(r, zeros, delta=1.).item():.9f}")
large_r = torch.tensor([3.], dtype=torch.float64)
print("Huber_delta2_r3=", F.huber_loss(large_r, torch.zeros_like(large_r), delta=2.).item(),
      "SmoothL1_beta2_r3=", F.smooth_l1_loss(large_r, torch.zeros_like(large_r), beta=2.).item())
本次實際輸出:
numpy=1.26.3 torch=2.3.1+cu118 device=cpu dtype=float64
ReLU_values= [0.0, 0.0, 1.0]
ReLU_framework_gradients= [0.0, 0.0, 1.0]
sigmoid_at_zero= 0.5 derivative= 0.25
tanh_at_zero= 0.0 derivative= 1.0
softmax_probabilities= [0.665240956, 0.244728471, 0.090030573]
CE_from_logits=0.407605964
CE_logits_gradient= [-0.334759044, 0.244728471, 0.090030573]
CE_gradient_equals_p_minus_onehot= True
CE_common_shift_invariant= True
BCE_with_logits_z0_y1=0.693147181 gradient=-0.500000
soft_target_CE_at_Q_equals_P=1.497866137
squared_error_per_residual= [0.0, 0.25, 4.0]
absolute_error_per_residual= [0.0, 0.5, 2.0]
Huber_delta1_per_residual= [0.0, 0.125, 1.5]
MSE_mean=1.416666667 MAE_mean=0.833333333 Huber_delta1_mean=0.541666667
Huber_delta2_r3= 4.0 SmoothL1_beta2_r3= 2.0
ReLU的0點梯度是框架慣例;CE的三個梯度與p-onehot相符;BCE在z=0、y=1的梯度為-0.5。這些是本次autograd實測。三個回歸loss則實測了數值,沒有對r開requires_grad,前文的回歸導數來自解析公式,不冒稱這段程式也跑了它們的反向傳播。
MSE、MAE與Huber的mean,分別對三個殘差的逐點值求平均,所以得到約1.416667、0.833333與0.541667。不要因第三個數字最小,就宣稱Huber「表現最好」;三個函數的尺度與錯誤代價不同,這種跨損失的裸數值比較沒有同一個基準。
整段沒有fit模型、沒有畫出前面來源圖,也沒有檢驗保留集表現。它的任務是讓你核對函數、導數、reduction與介面,避免把使用錯誤藏進完整訓練管線。
訓練前,可以先做四項小檢查
先確認目標的意義:互斥類別、可共存標籤,還是實數?這決定輸出與損失的合理搭配。再確認送進loss的是logits還是機率,目標的dtype、範圍與形狀是否吻合。
接著用一兩筆手算得出的資料,核對損失與梯度。看見0.693時要知道它對應什麼條件;看見MSE時要知道有沒有½、最後是sum還是mean。若有類別權重、平滑或多項損失,將縮放與相對權重一併記下。
最後才觀察完整訓練:損失是否下降、梯度是否異常、驗證結果是否改善。梯度提供的是目前函數的局部變化資訊,更新方法與步長仍會影響下一步;它不保證任意更新都降低整體損失,更不保證找到全域最優或更好的泛化。
激活函數讓模型形成不同的轉換,損失函數把任務的錯誤代價寫進目標。當你能把它們與梯度對起來,就能從「這段程式可以跑」進一步判斷「它正在往什麼方向學」。下一篇再把這些局部導數接成完整的反向傳播。
延伸閱讀與素材出處
- 上一篇:從感知器到MLP:先分清前向計算、手設權重與訓練。
- 羅吉斯迴歸與線性迴歸:二元logloss與平方誤差的前置脈絡。
- Dive into Deep Learning:Multilayer Perceptrons:圖1–3的函數及導數原SVG,作者Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola。
- D2L:Softmax Regression:圖4與softmax、交叉熵、p-y及熵的來源;單筆欄向量與row-batch的矩陣慣例需一致。
- Erin Bugbee與Jared Wilber:MLU-Explain Logistic Regression及文件授權摘要:圖5曲線來源;文件CC BY-SA 4.0與sample code的MIT-0分開,本文圖像依文件授權。
- Qwertyus:Huber loss.svg作品與授權頁:圖6兩曲線的原始作品、原Python公式與CC BY-SA 4.0。
- scikit-learn:HuberRegressor vs Ridge原例與程式:圖7;來源擬合不是本站測試。
- PyTorch 2.3 CrossEntropyLoss與BCEWithLogitsLoss:logits、目標形狀、權重與reduction的正式介面。
- PyTorch 2.3 HuberLoss與SmoothL1Loss:縮放關係;本次精確2.3.1依本機實裝source/docstring及CPU實算核對,文件網頁可有工具讀取限制。
圖片授權聲明
D2L四位作者的圖1–4、MLU/Amazon的圖5、Qwertyus的圖6與封面,各依CC BY-SA 4.0使用;原頁與作者已在圖說及上方列出。完整SVG的白底轉PNG、左右/手機上下編排、MLU已披露的標籤可讀性調整與手機局部放大、Huber封面縮放加白邊,皆屬本篇披露的圖像改作,沿用同授權,沒有新畫曲線或改動數值。共同完整CC授權原件另存本篇CC-BY-SA-4.0.txt;MLU原授權摘要亦保留。
圖7採The scikit-learn developers官方原圖,保留完整圖與手機原圖例放大,依BSD-3-Clause使用。它與前述CC圖像各自保留授權;獨立撰寫的教學不冒充來源文章的翻譯或作者背書。以下是隨來源附帶的完整BSD聲明:
BSD 3-Clause License

Copyright (c) 2007-2026 The scikit-learn developers.
All rights reserved.

Redistribution and use in source and binary forms, with or without
modification, are permitted provided that the following conditions are met:

* Redistributions of source code must retain the above copyright notice, this
  list of conditions and the following disclaimer.

* Redistributions in binary form must reproduce the above copyright notice,
  this list of conditions and the following disclaimer in the documentation
  and/or other materials provided with the distribution.

* Neither the name of the copyright holder nor the names of its
  contributors may be used to endorse or promote products derived from
  this software without specific prior written permission.

THIS SOFTWARE IS PROVIDED BY THE COPYRIGHT HOLDERS AND CONTRIBUTORS "AS IS"
AND ANY EXPRESS OR IMPLIED WARRANTIES, INCLUDING, BUT NOT LIMITED TO, THE
IMPLIED WARRANTIES OF MERCHANTABILITY AND FITNESS FOR A PARTICULAR PURPOSE ARE
DISCLAIMED. IN NO EVENT SHALL THE COPYRIGHT HOLDER OR CONTRIBUTORS BE LIABLE
FOR ANY DIRECT, INDIRECT, INCIDENTAL, SPECIAL, EXEMPLARY, OR CONSEQUENTIAL
DAMAGES (INCLUDING, BUT NOT LIMITED TO, PROCUREMENT OF SUBSTITUTE GOODS OR
SERVICES; LOSS OF USE, DATA, OR PROFITS; OR BUSINESS INTERRUPTION) HOWEVER
CAUSED AND ON ANY THEORY OF LIABILITY, WHETHER IN CONTRACT, STRICT LIABILITY,
OR TORT (INCLUDING NEGLIGENCE OR OTHERWISE) ARISING IN ANY WAY OUT OF THE USE
OF THIS SOFTWARE, EVEN IF ADVISED OF THE POSSIBILITY OF SUCH DAMAGE.
留言0
登入後就能留言。
登入