
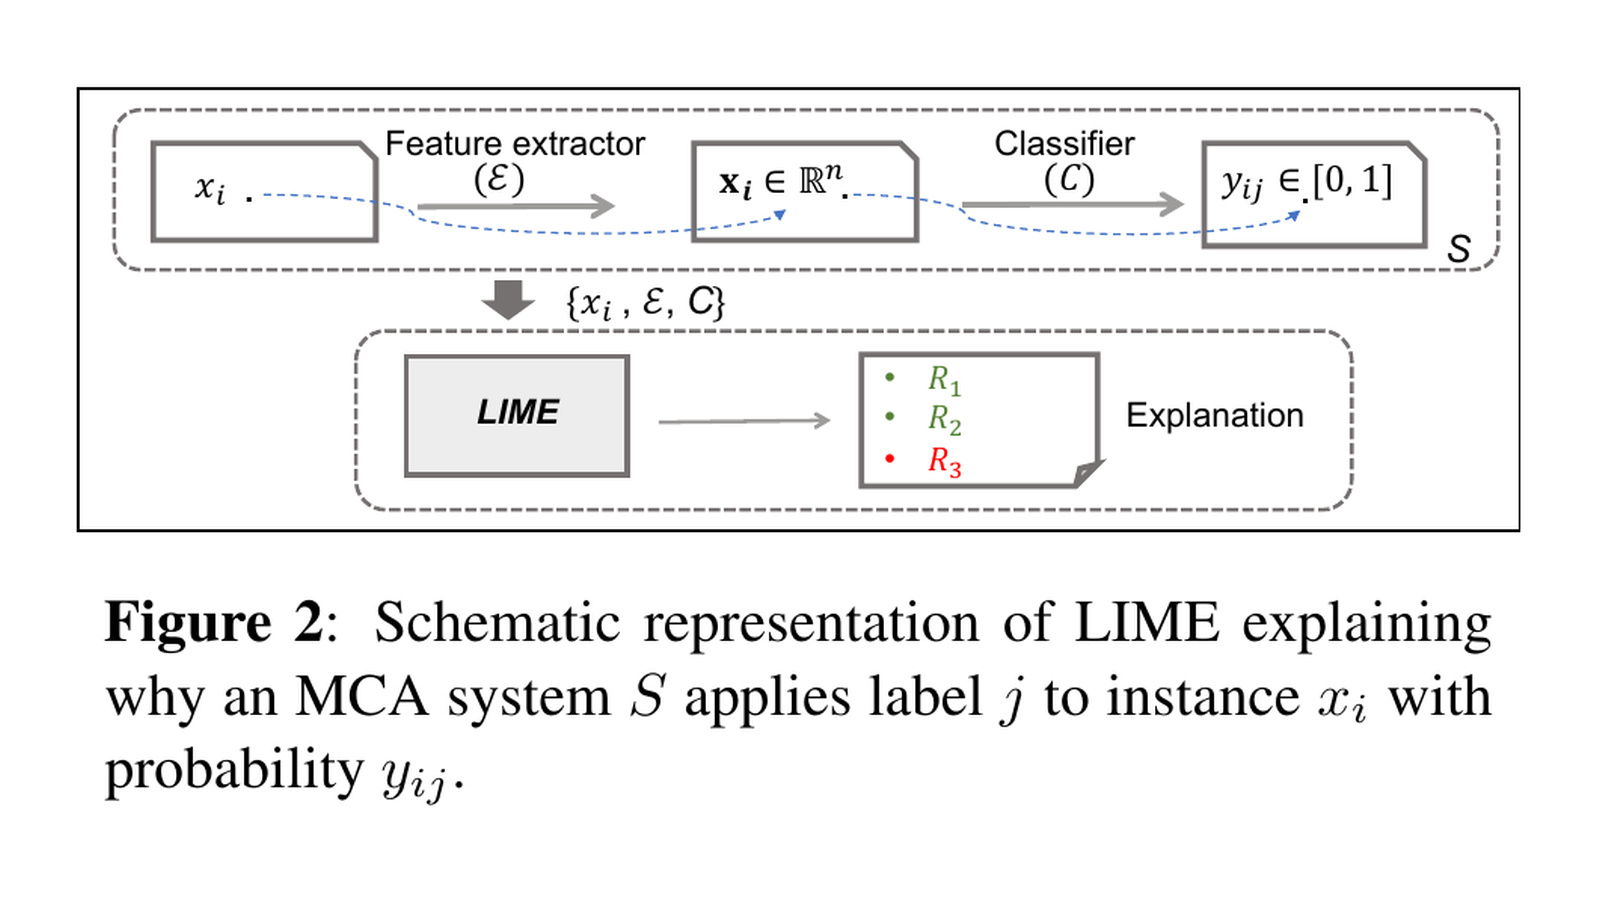
假設一個分類器把某段文字判成指定類別,給出 0.9 分。分數告訴我們模型的輸出,卻沒有直接說明:這一次預測,究竟跟哪些輸入部分有關?如果刪掉幾個詞,模型還會給相近的答案嗎?
LIME 的做法是,先在這筆輸入附近產生一批擾動資料,向原模型查詢分數,再用較容易閱讀的局部模型去近似這些反應。它不是直接把原模型的內部機制完整翻譯成人話,也不是從一筆解釋推出所有輸入都適用的規則。
上一篇區分了全局、局部與因果問題。本篇沿著 Ribeiro、Singh、Guestrin 在 2016 年提出的方法,拆開 LIME 的資料流,再用後續音訊版 SLIME 的流程圖,以及 Python/R 實作的解釋介面輔助閱讀。完整 Python 小例會真的擬合一個加權局部線性模型;黑箱函數則是手設的,沒有訓練文字分類器、使用語料或執行原版 LIME 套件。
先固定:你正在解釋哪一筆、哪個類別的分數?
LIME 的全名是 Local Interpretable Model-agnostic Explanations。Local 指解釋範圍,Interpretable 指人能閱讀的表示與模型,Model-agnostic 則表示它主要透過查詢原模型輸出來工作,不要求取得其梯度或內部權重。
解釋前要先固定原始輸入 x,以及要解釋的類別 j。若分類器同時輸出多個類別分數,這次擬合的目標是其中一個 f_j(x),不是把所有類別的重要性混成同一份排名。
在這個流程裡,原黑箱保持固定;我們另外學一個代理模型 g。g 的訓練目標來自黑箱對擾動資料的分數,不是每個擾動樣本經人工重新標註的真實類別。因此,即使 g 很忠實,它也只是在解釋黑箱的行為;黑箱可能本來就判錯,或用了不希望它依賴的線索。
Model-agnostic 也不代表沒有假設。鄰居怎麼產生、什麼距離算近、如何遮掉輸入部分,以及多簡單的代理模型才夠用,都是解釋方法的一部分。
x 與 x′:人讀的單位,可以不同於模型真正吃的特徵
原模型可能吃 TF-IDF、embedding、RGB tensor 或聲學特徵;直接列出這些數字,讀者未必能把它們對回輸入內容。LIME 因此區分原始表示 x 與可解釋表示 x′。
以原論文的文字/影像做法為例,x′ 可以是一個二元向量,表示某些可辨認部分是否保留:
這不是說每個版本、每種資料都必須使用完全相同的二元編碼。重點是,解釋使用的單位要有明確含義,並且有辦法把擾動後的 z′ 轉回黑箱能接收的 z。
「移除」尤其要定義。刪詞、換成佔位詞、把影像區域填灰或以其他值替代,都可能產生不同的黑箱反應。若擾動破壞了語法或產生資料中罕見的影像邊界,解釋可能主要反映這些人工輸入的行為,而不是自然資料附近的規律。
因此,可讀不等於完整。若你只允許解釋「哪些區塊存在」,某些色調、順序或跨區域互動未必能由這個表示清楚表達。原 LIME §3.1、§3.4 也討論了可解釋表示與線性模型的能力限制。
產生鄰居、查詢黑箱,再準備局部擬合資料
針對同一個 x′,LIME 產生很多保留不同部分的 z′。每一筆 z′ 都要經過對應轉換,得到黑箱可接受的 z,再查詢指定類別分數 f_j(z)。
代理模型實際拿到的資料包含三件事:可解釋特徵 z′、黑箱分數,以及距離決定的權重。它不是只看原始 x 的一個分數,就憑空猜出每個特徵的貢獻。
這張圖把特徵提取與可解釋表示分開,正好提醒我們:關閉一個音訊區塊,不等於隨意把某個 MFCC 數字減一。不同資料類型需要不同的擾動與重建方式,不能只因最後都使用線性代理模型,就把中間處理全部視為相同。
下文的小例刻意縮到兩個二元特徵。名字是 bright、repair,但黑箱直接接收兩個 0/1,沒有真正斷詞、embedding 或文字重建;可解釋空間到黑箱輸入的映射就是這兩個數值本身。這使我們能把所有鄰居列完,專心檢查後面的加權與擬合。
距離變成權重:遠的樣本可以參考,但影響較小
如果所有擾動樣本都等權,簡單線性模型可能努力平均很大一片範圍的行為,而失去「在這一筆附近解釋」的目的。LIME 用 proximity kernel,讓鄰近原輸入的樣本在擬合時較有影響力。
原論文的一種寫法是:
pi_x(z) = exp(−D(x,z)^2 / sigma^2)
D 是選定距離,sigma 控制權重下降的尺度。權重不是樣本屬於某類的機率,也不是模型對該樣本的信心分數;它是解釋器決定「這筆擾動在局部擬合時多重要」的數字。
本例解釋 (1,1),取 cosine distance,sigma=0.5。原向量長度為 sqrt(2),只保留一個特徵時,cosine similarity 是 1/sqrt(2),距離約為 0.292893。全零向量沒有一般意義下的 cosine 角度,本程式明確把它的距離定為 1,這是小例採用的約定。
黑箱是手設的非線性分數:
f(z1,z2) = 0.10 + 0.45z1 + 0.25z2 + 0.10z1z2
它在這四個二元輸入上的分數都落在 0 到 1,但不是由真實語料訓練、校準出的分類機率。
| 鄰居 z′ | 距離/局部權重 | 黑箱分數 |
|---|---|---|
| 保留兩個,(1,1) | 0/1 | 0.90 |
| 只保留 bright,(1,0) | 0.292893/0.709535 | 0.55 |
| 只保留 repair,(0,1) | 0.292893/0.709535 | 0.35 |
| 全關閉,(0,0) | 1/0.018316 | 0.10 |
本例每個配置恰好列一次,沒有隨機抽樣。原方法實際抽樣時,不同配置出現的次數與權重還會共同影響擬合;不能把這四列當成已重現某個 LIME sampler 的隨機分布。
sigma 小,遠處樣本的權重通常掉得更快;sigma 大,代理模型必須照顧更廣的範圍。它不是越小越好:若有效鄰域幾乎沒有足夠變化,擬合可能缺少辨認各特徵作用的資訊;過大的範圍又可能超出簡單模型能近似的區域。
本例的 sigma 不是 Python 套件的預設參數
論文形式與套件實作也要分開。本文查對的 Python repo 固定版本,預設 kernel 是:
sqrt(exp(−d²/kernel_width²))
  = exp(−d²/(2×kernel_width²))
其文字解釋器還把 cosine distance 乘以 100,預設 kernel_width=25。本例則直接使用 0 到 1 尺度的距離與論文形式的 sigma=0.5。距離尺度與指數中的參數約定都不同,不能把這個 0.5 說成套件預設,也不宜原封不動搬進另一種距離尺度。固定版本 LimeTextExplainer 可對照這些細節。
稀疏局部模型:在可讀長度與忠實度之間取捨
有了鄰居與黑箱分數後,LIME 想找的是一個容易閱讀、又能在該鄰域近似黑箱的 g。原方法把這兩個需求寫在同一個目標:
選 g,使下式較小:
  sum_i pi_x(z_i) × [f_j(z_i) − g(z'_i)]² + Omega(g)

前半:在選定鄰域與權重下,代理模型偏離黑箱的程度
後半:代理模型的複雜度
稀疏線性模型的一種複雜度限制是最多保留 K 個非零特徵。K 越小,說明越短,但可能漏掉局部行為;如果黑箱在這個範圍仍高度非線性,短短一張詞權重表不一定能忠實近似它。
原 paper 的文字/影像方法用 K-Lasso 近似這個選擇:先沿 Lasso path 選特徵,再用 least squares 估係數。這不是保證找到所有可能子集合中的精確最優解。後來的 Python 實作則提供其他選擇策略,預設局部 regressor 是 Ridge;查核版本的 auto 模式,當要求的解釋長度不超過 6 時用 forward selection,否則用另一個 highest-weights 策略。不能把論文的一個設定叫成所有版本的固定預設。原 paper Algorithm 1 與固定版本 LimeBase 是兩個要分開讀的依據。
本篇程式只擬合含截距的兩特徵模型:
g(z′) = b0 + b1×z1 + b2×z2
兩個特徵都已指定保留,所以沒有執行 K-Lasso 或稀疏特徵搜尋。它展示的是加權局部 surrogate 的擬合機制,不是原版 LIME 全流程的替代實作;也沒有把後續再排序係數誤稱為已完成稀疏選擇。
實際擬合後,係數與黑箱原式為什麼不同?
程式根據四列資料形成加權最小平方的正規方程,再以帶 pivot 的 Gaussian elimination 解三個未知數。這裡確實擬合了代理模型;沒有訓練的是前面的黑箱分類器。
保存結果約為:
g(z′) = 0.006537 + 0.545876×bright + 0.345876×repair
黑箱原式裡 bright 的一次項是 0.45,代理係數卻接近 0.546,並不矛盾。黑箱另有 0.10z1z2 的交互作用,線性代理沒有該項;在這次偏重 (1,1) 附近的擬合中,一部分交互作用被吸收到線性係數與截距裡。因此代理係數不是把黑箱原有參數逐一抄出來。
在原輸入 (1,1),黑箱分數為 0.900000,代理分數約 0.898288,差約 0.001712。這是這一次局部近似在查詢點的誤差,不能把兩個輸出印成相同的 0.9 就宣稱完全一致。
遠一點的全關閉輸入,黑箱為 0.10,g 的截距卻只有約 0.006537。它在這個點偏差較大,部分原因是該列權重只有約 0.018316。這正好顯示局部擬合的取捨:不能因為查詢點附近很接近,就推論其餘位置也同樣準確。
係數為正,可以說在這個代理模型與表示下,保留該特徵會提高所解釋類別的近似分數。它不是該詞在所有文章中的絕對重要性,也不是刪掉該詞必定造成同樣幅度的真實世界效果。代理線性分數本身也不自動成為新的校準機率。
忠實度、穩定度與速度,要分開檢查
代理模型的目的,是近似指定黑箱的局部反應。因此回報係數之前,至少應同時讀它的近似誤差。本例的加權平方誤差和約為 0.000171;這是四列、這些權重下的 raw weighted SSE,不是分類 accuracy、R²,或跨不同樣本數都可直接比較的統一品質分數。
輸出中的正規方程最大殘差約為 2.22×10⁻¹⁶,則回答另一件事:線性方程的數值解是否滿足方程。它不能證明 g 已經等於黑箱,也不是局部忠實度的誤差;前面的 0.001712 查詢點落差與全關閉點偏差仍然存在。
真正使用隨機擾動時,還會遇到穩定性問題:換一次 seed,入選特徵或排序會不會變?這與某一次擬合誤差小,是不同的檢查。
例如兩次各選 top-3,第一次為 {B1,B2,B3},第二次為 {B2,B5,B6},聯集有 5 個不同成分。若每次都選相同的 3 個,這個計數就會是 3;這是用集合一致性看穩定度,不是在判斷成分是否為真實原因。
原圖在該設定下呈現樣本數增加、U_n 降低而耗時增加的取捨。不能由它推出「所有文字模型取 1000 個樣本就足夠」,也不能說解釋穩定就必然忠實:一套不合適的表示或擾動方式,仍可能穩定地產生不合適的說明。
實際回報一次 LIME 解釋,可以一併交代解釋的類別、表示與遮蔽規則、距離/kernel 尺度、樣本數、K 或選擇策略,以及代理對黑箱的局部誤差。若要檢查抽樣穩定性,可以對同一輸入以多次抽樣比較;若要檢查近似是否只貼合用來擬合的鄰居,也可以另取鄰居檢查。這些是額外驗證工作,本篇窮舉小例沒有執行隨機穩定性或新鄰域測試。
讀實際介面:分類機率、局部係數與 Explanation Fit 各在說什麼?
看到一張彩色解釋圖,先辨認每個數字來自哪一層。下面是原 Python LIME repo 的多類別文字解釋介面,不是本站兩詞程式的輸出。
左邊的 0.50/0.43,是模型對這筆輸入給 atheism/christian 的分類機率。中間的 0.26,是詞 Caused 在該次 atheism 局部解釋中的權重;右邊同一詞對 christian 的解釋,方向與數值又不同。這些數字有不同角色,不能把 0.26 當成新的類別機率,也不能說刪掉這個詞,黑箱機率就一定精確從 0.50 變成 0.24。
後一句需要查詢刪詞後的黑箱才知道。代理模型估計的是選定表示與鄰域內的近似關係;真實黑箱仍可能有非線性互動。圖上的 NOT 也不是一個額外訓練類別,而是相對於正在解釋的類別,標示局部反向支持的一側。
表格資料則常把數值區間當成解釋特徵。下一張 R-port 圖裡的 Petal.Width <= 0.4 是區間條件,並不是把花瓣寬度的每個浮點數都當作一個獨立詞。
Probability 1 描述原分類器對當筆資料的輸出;Explanation Fit 描述局部代理擬合黑箱的程度。兩者不需要相等,也不能把 0.70 讀成「整個分類器只有 70% 準確」。五筆恰好都屬 setosa,無法用它們評估各類別的整體品質;同樣地,圖上的正向權重只支持這次局部說明,不證明花瓣條件對物種具有因果效果。
這裡使用的是作者自己生成的文件圖;資料脈絡另列 R 官方 iris 文件與 UCI Iris 記錄。本文未驗 R 內建資料與目前 UCI release 的逐列/逐位元一致性,不把後者的授權或版本資訊直接視為已證明前者完全相同,也不重新散布資料表。這個來源版本界線不影響我們閱讀圖中「分類輸出與局部擬合不同」的例子。
完整可重跑程式:看見四列資料如何變成局部解釋
將以下完整程式存成 lime_local_surrogate.py,使用 Python 3 執行。只有標準庫,不需安裝 LIME、scikit-learn、語料或模型權重;保存的執行環境為 Python 3.10.12;下方係數與誤差來自這支程式的實際輸出。
python3 lime_local_surrogate.py
#!/usr/bin/env python3
"""Deterministic LIME-style neighborhood and weighted-surrogate toy."""

from __future__ import annotations

import math


QUERY = (1.0, 1.0)  # two interpretable word-presence indicators
WORDS = ("bright", "repair")
SIGMA = 0.5


def black_box(z: tuple[float, float]) -> float:
    """Hand-specified nonlinear score, not a fitted classifier."""
    z1, z2 = z
    return 0.10 + 0.45 * z1 + 0.25 * z2 + 0.10 * z1 * z2


def cosine_distance(query: tuple[float, float], z: tuple[float, float]) -> float:
    """Cosine distance; define an all-zero neighbor's distance as 1."""
    q_norm = math.sqrt(sum(value * value for value in query))
    z_norm = math.sqrt(sum(value * value for value in z))
    if z_norm == 0.0:
        return 1.0
    cosine = sum(a * b for a, b in zip(query, z)) / (q_norm * z_norm)
    return 1.0 - cosine


def solve_linear_system(matrix: list[list[float]], vector: list[float]) -> list[float]:
    """Solve a small square system with Gaussian elimination and pivoting."""
    size = len(vector)
    augmented = [row[:] + [vector[i]] for i, row in enumerate(matrix)]
    for column in range(size):
        pivot = max(range(column, size), key=lambda row: abs(augmented[row][column]))
        if abs(augmented[pivot][column]) < 1e-12:
            raise ValueError("weighted design matrix is rank deficient")
        augmented[column], augmented[pivot] = augmented[pivot], augmented[column]
        scale = augmented[column][column]
        augmented[column] = [value / scale for value in augmented[column]]
        for row in range(size):
            if row == column:
                continue
            factor = augmented[row][column]
            augmented[row] = [
                a - factor * b for a, b in zip(augmented[row], augmented[column])
            ]
    return [augmented[row][-1] for row in range(size)]


def main() -> None:
    # Enumerate every subset of the two present words: no random sampling.
    neighbors = [(1.0, 1.0), (1.0, 0.0), (0.0, 1.0), (0.0, 0.0)]
    rows = []
    for z in neighbors:
        distance = cosine_distance(QUERY, z)
        weight = math.exp(-(distance * distance) / (SIGMA * SIGMA))
        rows.append((z, distance, weight, black_box(z)))

    # g(z') = beta0 + beta1*z1 + beta2*z2, fit by locality-weighted OLS.
    # This deliberately omits LIME's K-Lasso feature selection/sparsity step.
    design = [[1.0, z[0], z[1]] for z, _, _, _ in rows]
    targets = [prediction for _, _, _, prediction in rows]
    weights = [weight for _, _, weight, _ in rows]
    normal = [
        [sum(w * row[i] * row[j] for w, row in zip(weights, design)) for j in range(3)]
        for i in range(3)
    ]
    rhs = [
        sum(w * row[i] * y for w, row, y in zip(weights, design, targets))
        for i in range(3)
    ]
    beta = solve_linear_system(normal, rhs)

    residual = max(
        abs(sum(normal[i][j] * beta[j] for j in range(3)) - rhs[i])
        for i in range(3)
    )
    assert residual < 1e-10
    local_prediction = sum(beta[j] * [1.0, QUERY[0], QUERY[1]][j] for j in range(3))
    weighted_sse = sum(
        w * (y - sum(b * feature for b, feature in zip(beta, row))) ** 2
        for w, y, row in zip(weights, targets, design)
    )

    print("scope=hand-specified black box; deterministic exhaustive 2-word neighborhood")
    print(f"query_interpretable={QUERY}; words={WORDS}; sigma={SIGMA}")
    print("neighbor z1 z2 cosine_distance locality_weight black_box_score")
    for z, distance, weight, prediction in rows:
        print(f"{int(z[0])} {int(z[1])} {distance:.6f} {weight:.6f} {prediction:.6f}")
    print(f"surrogate=intercept + b1*{WORDS[0]} + b2*{WORDS[1]}")
    print(f"intercept={beta[0]:.6f}; b_{WORDS[0]}={beta[1]:.6f}; b_{WORDS[1]}={beta[2]:.6f}")
    print(f"black_box_at_query={black_box(QUERY):.6f}")
    print(f"surrogate_at_query={local_prediction:.6f}")
    print(f"weighted_squared_error={weighted_sse:.6f}")
    print(f"normal_equation_max_residual={residual:.3e}")
    print("limit=no trained model, corpus, randomized LIME sampling, feature selection, or stability study")


if __name__ == "__main__":
    main()
程式先印出四個鄰居的距離、權重、黑箱分數,再印代理係數、原查詢點的兩種預測,以及加權誤差。它讓我們能查核一個局部模型確實如何被擬合;不代表本站已跑出一個真實文本分類器的解釋,更沒有用這四列驗證音訊研究的穩定度曲線。
LIME 的價值在於,把一次預測附近原本難以閱讀的反應,整理成可檢查的簡單模型。閱讀它時,應連同附近的定義與近似品質一起看。若接著要推論全局規律、評估模型整體可信度或採取因果干預,仍須另外準備相應證據,不能只把這次的詞權重放大使用。
方法、圖片與實作來源
- Ribeiro、Singh、Guestrin,Why Should I Trust You? Explaining the Predictions of Any Classifier,2016,arXiv v3:原始 LIME。本文直接讀 §2、§3.1–3.6、Algorithm 1 與相關圖說;沒有宣稱逐讀全部後續實驗。原 paper 圖像只提供連結,不以程式 repo 的授權重刊同一份論文像素。
- Saumitra Mishra、Bob L. Sturm、Simon Dixon,Local Interpretable Model-agnostic Explanations for Music Content Analysis,ISMIR 2017,pp.537–543:本文讀完整主文、圖說與實驗前提,使用作者的 Fig. 2/3/6,依首頁明列的 CC BY 4.0 署名。沒有重刊來源音訊、曲目頻譜或示例照片,也沒有重跑音訊模型。三圖是同一篇來源研究的不同用途,不是三個獨立重現實驗。
- marcotcr/lime 固定版本 LimeTextExplainer與LimeBase:核對必要 kernel、distance scaling、Ridge 與 feature-selection 程式,未執行該套件。另讀該版完整 README,使用作者的 README multiclass 文件圖,依固定 BSD-2-Clause 保留完整聲明。本文可跑程式是獨立的標準庫兩詞算術,不把來源介面或完整套件當成本站實測。
- 圖像的完整原件、手機重排、封面與改作範圍如各圖說及下方聲明;來源自有圖的個別授權分開保留。
- tidymodels/lime 固定版本 README.Rmd及MIT LICENSE:本文讀完整 README.Rmd、授權與自製五案例圖的生成程式;沒有執行 R/caret 模型。
- R 官方 iris 文件與UCI Iris 資料記錄:前者交代 Anderson 採集、Fisher 使用的資料脈絡;後者列 R. A. Fisher、1936、DOI 10.24432/C56C76 與 CC BY 4.0。此處分別提供資料來源線索,沒有驗證兩個 release 的逐列或逐位元一致性,也未重新散布資料表。
- 各圖改作、著作權與授權分開保留;下方提供兩個軟體專案自有文件圖所需的完整授權副本及本次圖像聲明。
圖像著作權與授權副本
ISMIR 三圖與封面依各圖列明的 CC BY 4.0 使用;下列兩份完整授權副本分別對應 Python LIME 與 R-port 的自有文件輸出,不能跨來源套用。最後附本次五組圖的署名與改作聲明。
Python LIME:BSD 2-Clause
Copyright (c) 2016, Marco Tulio Correia Ribeiro
All rights reserved.

Redistribution and use in source and binary forms, with or without
modification, are permitted provided that the following conditions are met:

* Redistributions of source code must retain the above copyright notice, this
  list of conditions and the following disclaimer.

* Redistributions in binary form must reproduce the above copyright notice,
  this list of conditions and the following disclaimer in the documentation
  and/or other materials provided with the distribution.

THIS SOFTWARE IS PROVIDED BY THE COPYRIGHT HOLDERS AND CONTRIBUTORS "AS IS"
AND ANY EXPRESS OR IMPLIED WARRANTIES, INCLUDING, BUT NOT LIMITED TO, THE
IMPLIED WARRANTIES OF MERCHANTABILITY AND FITNESS FOR A PARTICULAR PURPOSE ARE
DISCLAIMED. IN NO EVENT SHALL THE COPYRIGHT HOLDER OR CONTRIBUTORS BE LIABLE
FOR ANY DIRECT, INDIRECT, INCIDENTAL, SPECIAL, EXEMPLARY, OR CONSEQUENTIAL
DAMAGES (INCLUDING, BUT NOT LIMITED TO, PROCUREMENT OF SUBSTITUTE GOODS OR
SERVICES; LOSS OF USE, DATA, OR PROFITS; OR BUSINESS INTERRUPTION) HOWEVER
CAUSED AND ON ANY THEORY OF LIABILITY, WHETHER IN CONTRACT, STRICT LIABILITY,
OR TORT (INCLUDING NEGLIGENCE OR OTHERWISE) ARISING IN ANY WAY OUT OF THE USE
OF THIS SOFTWARE, EVEN IF ADVISED OF THE POSSIBILITY OF SUCH DAMAGE.
R-port lime:MIT
# MIT License

Copyright (c) 2025 lime authors

Permission is hereby granted, free of charge, to any person obtaining a copy
of this software and associated documentation files (the "Software"), to deal
in the Software without restriction, including without limitation the rights
to use, copy, modify, merge, publish, distribute, sublicense, and/or sell
copies of the Software, and to permit persons to whom the Software is
furnished to do so, subject to the following conditions:

The above copyright notice and this permission notice shall be included in all
copies or substantial portions of the Software.

THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR
IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY,
FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE
AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER
LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM,
OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE
SOFTWARE.
本次圖像來源與改作聲明
# DS56 image source and license notices

This record describes the selected source illustrations. Each source keeps its own grant; this notice does not combine or extend the licenses. All edits are limited to the changes described below. No source data or model outputs were regenerated for these images.

## ISMIR 2017 paper figures — CC BY 4.0

**Source:** Saumitra Mishra, Bob L. Sturm, and Simon Dixon, “Local Interpretable Model-Agnostic Explanations for Music Content Analysis,” ISMIR 2017, Figs. 2, 3, and 6. [Original paper](https://archives.ismir.net/ismir2017/paper/000216.pdf). The paper’s first page grants CC BY 4.0; the selected figure pages show no separate third-party credit. [CC BY 4.0 terms](https://creativecommons.org/licenses/by/4.0/).

- `fig-01-lime-overview.png`, `fig-01-lime-overview-mobile.png`, `cover-ds56-lime-overview.png`: Fig. 2. The desktop/cover preserve the complete source figure and caption after page-margin cropping; the mobile image places a complete original source-panel crop after the whole figure.
- `fig-02-slime-workflow.png`, `fig-02-slime-workflow-mobile.png`: Fig. 3. The desktop preserves the complete source figure/caption after page-margin cropping; the mobile image places six original node crops after the whole figure. Connections should be read in the complete figure; no connections were added.
- `fig-03-sample-budget.png`, `fig-03-sample-budget-mobile.png`: Fig. 6. The desktop preserves the full two-panel figure/caption after page-margin cropping; the mobile image places complete original panels after the whole figure.

Changes: page whitespace was cropped, desktop images were proportionally resized with white margins, and mobile variants stack source-only crops beneath the whole source image. The cover proportionally fits the full Fig. 2 on a white 1600×900 canvas. No labels, arrows, data, or visual marks were added or redrawn. Source page/crop coordinates and output hashes are recorded in `source-crop-audit.json`.

## `marcotcr/lime` multiclass output — BSD 2-Clause

**Creator:** Marco Tulio Correia Ribeiro. **Source:** pinned repository commit [`fd7eb2e6f760619c29fca0187c07b82157601b32`](https://github.com/marcotcr/lime/tree/fd7eb2e6f760619c29fca0187c07b82157601b32), [`doc/images/multiclass.png`](https://github.com/marcotcr/lime/blob/fd7eb2e6f760619c29fca0187c07b82157601b32/doc/images/multiclass.png). The repository-authored HTML output is covered by the pinned repository’s BSD 2-Clause license. The full BSD license, copyright notice and disclaimer are reproduced above in this article.

- `fig-04-multiclass-text.png` is byte-identical to the source PNG.
- `fig-04-multiclass-text-mobile.png` places the original whole image before three source-pixel crops (probabilities and two complete class-pair panels); it adds no labels or data.

## `tidymodels/lime` Iris README output — MIT

**Source:** pinned [`tidymodels/lime` commit `1ac166867a7b2b4af6e3f4717159cd59e30cf7b0`](https://github.com/tidymodels/lime/tree/1ac166867a7b2b4af6e3f4717159cd59e30cf7b0), README.Rmd-generated `man/figures/README-unnamed-chunk-2-1.png`. The pinned MIT license applies to the associated documentation and this author-generated plot; the complete MIT notice and terms are reproduced above in this article.

- `fig-05-iris-cases.png` is byte-identical to the source PNG.
- `fig-05-iris-cases-mobile.png` places the original whole image before five source-pixel case crops. The shared feature/weight axes and legend remain in the whole image; no values were reconstructed.

The source README uses R’s built-in `iris`. The UCI Iris resource has a separate CC BY 4.0 grant, but byte/row identity between those releases has not been established. No dataset file is included, and these figures must not be described as a verified exact reproduction of the UCI data.

## Exclusions and limitations

The original 2016 LIME paper figures are link-only because no positive commercial republication grant was established. The `marcotcr/lime` tabular screenshot with unresolved data provenance, photographic/email screenshots, and the Jamendo-dependent ISMIR figure are not included.
留言0
登入後就能留言。
登入